毕业于南京大学计算机软件研究所前沿交叉中心,期间参与国家“新一代人工智能”重大项目及国家自然科学基金面上项目,长期研究群体智能的激发与汇聚。其主要成果包括多项强化学习相关专利及大语言模型方向论文(Jiang, Y., Wang, L., Hu, H., & Tao, X., Represent Code as Action Sequence for Predicting Next Method Call, Proc. 13th Asia-Pacific Symposium on Internetware, pp.45–54)。目前任职于火山引擎数智平台数据应用团队,负责 AI + 用户分析项目中大模型 Agent 系统的设计与研发。
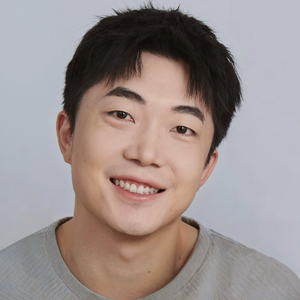
专题演讲嘉宾:蒋煜
火山引擎数据应用资深工程师
by 蒋煜
火山引擎
数据应用资深工程师行为数据不仅数量大,且包含的数据类型、语义繁杂,在一些需要语义理解较快产出结论或模仿人类推理的行为分析场景,传统的数据分析、机器学习方法存在冷启动慢、语义理解和解释困难的弊端,需要利用人工智能领域新进展解决类似的用户行为分析诉求;
为此,结合大语言模型(LLM)的行为数据分析与归因,创新性地在原始日志的基础上建立分析的数据形态中间层,充分利用大模型非结构化数据尤其是自然语言的理解与推理能力优势;为了满足用户在行为 AI 辅助数据分析过程中结果可解释、可信的需求,以及解决长时间跨度行为数据的庞大数据量与模型上下文窗口限制之间的矛盾,我们推出了用户研究 Agent,实现方案上引入了行为数据形态中间表示层,这一中间层不仅能有效处理超出上下文窗口的数据,还在引入业务知识、主动学习和智能分析规划方面起到了关键作用,同时,为了提升结论的可信度,系统实现上始终保持模型分析与原始数据之间的连接,从而提高了分析结果的透明度和可验证性,并提升了人际协作的效率与信任度;
最终,用户研究 Agent 较大程度提高了业务分析效率,帮助业务方识别了若干提升收益的动作点,模型与原始数据的紧密结合使得关键分析步骤可追溯与验证,从而增强了分析结果的可信度,在人机协同分析的基础上推动了业务决策的优化与业务收益的提升。
演讲提纲:
- 大模型在行为分析场景中的优势
- 非结构化数据尤其是自然语言的理解和推理能力
- 巨大的预训练数据与参数量带来的泛化能力与通识储备
- 仍然在快速进步的领域,可以利用诸多应用上的新能力(function call、MCP等)与新实践(Deep research、新兴Agent架构)快速提供更强的分析
- 实践中的问题与用户研究Agent解决方案
- 问题:要分析数据量远大于模型上下文
- 如何选择分析数据的子集
- 如何分析长时间跨度的行为
- 问题:行为分析/洞察场景需要结果有逻辑、可信、可证明
- 如何在大模型的自由发散与约束确定之间取舍
- 如何利用业务方已有的业务知识与分析经验
- 如何建立业务方对大模型分析过程与结论的信任
- 如何在人类与AI协作分析的过程中让AI获得有效反馈并成长
- 问题:如何在大模型驱动的系统中进行质量评估
- 如何从研发与测试角度对结果进行自动化评估
- 如何从研发角度提高模型输出结果的稳定性与可测试性
- 问题:要分析数据量远大于模型上下文
- 用户研究 Agent 业务价值复现与review
- 大模型驱动的行为分析真实 show case
- 大模型分析结果结果可信、可证明的 demonstration
- 总结与展望
听众收益:
- 对大模型+行为分析落地场景的具体技术常见问题得到解法参考
- 收获当前实践中的大模型驱动系统的质量评估方案
- 理解1-2种重要且有效的关键技术设计
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Realm Beijing
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手