拥有超过20年IT及10年云计算行业经验。近年专注于AI基础设施领域,在AI应用的训练、推理、跨硬件平台(GPU/TPU等)部署适配及性能优化方面具有深厚的理论知识和丰富的实战经验,致力于推动AI算力在各行业的普惠化落地。
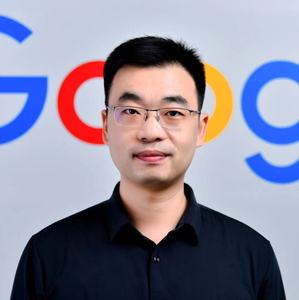
专题演讲嘉宾:杨国强
GoogleAI Infra 技术专家
by 杨国强
本次演讲将探讨如何在Google Cloud TPU上,以高性价比的方式部署开放的大语言模型和文生图模型。我们将基于TPU的发展历程及其硬件架构特性,深入剖析如 vLLM、JetStream、MaxDiffusion 等主流推理框架在TPU上的优化路径。
演讲将重点介绍围绕自动前缀缓存、分块预填充、连续批处理、分布式推理等关键技术手段,如何实现推理流程的深度调优,从而显著提升模型部署的吞吐效率与响应延迟。
演讲提纲:
- TPU 简介与技术演进
- 理解大模型推理的核心流程
- 自回归模型的推理过程:Prefill 与 Decode 阶段解析
- 关键挑战:如何突破延迟瓶颈与吞吐上限?
- 推理框架优化实践:vLLM 与 JetStream 深度调优
- vLLM on TPU:自动前缀缓存(APC)、分块预填充、连续批处理的落地
- JetStream 与推测解码:提升效率的系统级创新
- LLM-d 与 GKE:如何构建分布式推理服务体系
- 性能指标解读与服务优化
- 如何测量好推理服务?延迟、吞吐、KV Cache 使用率等指标剖析
- 对比 GKE 推理网关 vs 传统负载均衡的实际效果
- TPU 硬件特性赋能模型推理
- SPMD 并行、SparseCore、Pod 架构下的推理效率优势
- Ironwood 带来的最新计算能力与部署选项
- 落地案例与部署总结
- 文生图场景中延迟下降实践:客户案例分享
- 部署路径总结:多种方案下的性价比对比与优化建议
听众收益:
- 全面理解 TPU 架构与演进,掌握其适配开放大模型的核心优势
- 学会在 TPU 上部署大语言/图像模型的实战优化技巧
- 掌握推理过程中的关键指标分析方法,并通过 GKE 网关优化推理服务
- 借助真实案例理解如何兼顾推理性能与成本控制,实现性价比最大化
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手