马腾于 2021 年 6 月在清华大学获得计算机博士学位。于 2021 年 7 月至 2023 年 11 月期间,在阿里云联合中科院自动化所博士后工作站从事数据中心解耦相关研究。马腾目前担任阿里云基础软件部门的高级技术专家,主要从事 AI 基础设施在新硬件环境下国产化的研究工作,以及国产化硬件如何优化大模型服务系统,其中 CXL-SHM 是国内高速总线领域第一个开源项目,另一个开源项目 Mooncake 被阿里 / 蚂蚁 / 腾讯等多家企业使用。在 SOSP, ASPLOS, ATC, SC, INFOCOM, VLDB, TPDS 等顶级会议上发表论文二十余篇,相关成果授权美国 / 中国专利十余项。入选 CCF 系统软件专委会优秀博士论文激励计划,担任 PPoPP, FAST, ICME, DASFAA, TPDS, TC, JSC 等国际会议 / 期刊的程序委员会成员和审稿人。
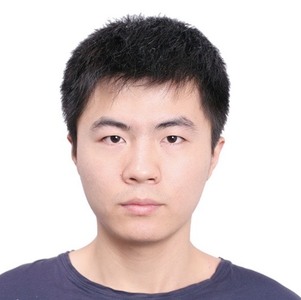
专题演讲嘉宾:马腾
阿里云高级技术专家
by 马腾
阿里云
高级技术专家随着大模型应用的普及,推理过程中的高计算资源消耗和 KVCache(键值缓存)的冗余存储成为关键瓶颈,导致推理成本高昂、吞吐量受限,尤其在长上下文场景中表现尤为突出。Mooncake 项目通过创新的以 KVCache 为中心的“PD 分离”架构(计算与存储解耦)和“以存换算”设计,将 KVCache 池化共享,结合高性能传输技术(如 eRDMA、GPUDirect)和分布式存储优化,实现跨实例的资源复用。
Mooncake 项目包括三大创新点:(1)Transfer Engine:支持全链路零拷贝、多网卡聚合(8×400Gbps),兼容 eRDMA/NVLink/CXL,动态拓扑感知。(2)KVCache Store:利用 GPU 闲置内存与 RPC 框架 coro_rpc,实现透明多级缓存,未来支持廉价存储下沉。(3)生态整合:与 vLLM/SGLang 等主流推理框架适配,TPOT 下降 20%,成本低至 0.2$/1M Token。在多轮对话,长文本阅读等场景中,推理吞吐量显著提升,响应时间降低 69.1%,并被阿里云、蚂蚁集团等企业实际部署。
演讲提纲:
- 引言
- 大模型推理的挑战:成本、吞吐与长上下文瓶颈
- Mooncake 项目的产学研背景与开源意义
- 核心技术解析
- PD分离架构:计算与存储解耦的设计哲学
- KVCache池化:共享机制与性能优化
- Transfer Engine:eRDMA/GPUDirect 的高效传输实现
- 行业实践与效果
- 与vLLM/SGLang的适配案例
- 企业级部署经验(阿里云、蚂蚁集团)
- 未来展望
- Mooncake Store v2:多实例共享KVCache
- 生态扩展:LMDeploy、TensorRT-LLM等框架支持
听众收益:
- 了解如何通过 KVCache 池化与 PD 分离架构解决大模型推理的高成本问题,获得可复用的架构设计思路
- 学习 eRDMA/GPUDirect 等高性能传输技术在大模型场景的落地方法,提升分布式系统优化能力
- 掌握主流推理框架(如 vLLM)与 Mooncake 的适配策略,推进开源解决方案持续发展
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手