大模型推理性能优化主要从模型优化、推理加速和工程优化三个方向展开。通过模型量化、... 展开 >
大模型推理性能优化策略
会议室:爱那里宴会厅 2出品人:王德山
- Topic 1
姜慧强
微软亚洲研究院 研究开发工程师 - Topic 2
张君
华为 高级开发工程师 - Topic 3
向乾彪
腾讯 推理架构师 - Topic 4
李元龙
阿里云 技术专家
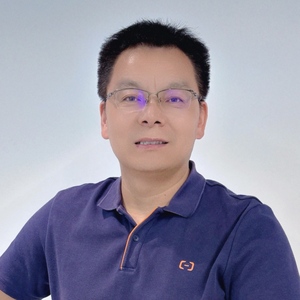
专题出品人:王德山
阿里云公共云大模型技术服务负责人
负责阿里云大模型技术服务和汽车行业线技术。基于阿里云算力和AI大模型,从 IaaS、PaaS/MaaS、SaaS 三层,构建全尺寸大模型,支持开源/闭源/私有化的 AI 综合服务体系。涵盖从硬件适配到算力资源调度、数据处理到模型训练、智能体应用构建到AI应用工程、安全合规到 AI 服务稳定性建设的各个环节,致力于建立面向全领域客户首选的 AI 全栈技术服务。
地点:爱那里宴会厅 2
专题:大模型推理性能优化策略
大模型推理性能优化主要从模型优化、推理加速和工程优化三个方向展开。通过模型量化、剪枝和蒸馏等技术降低计算复杂度,提高推理效率,如 DeepSeek-R1-Distill-Qwen-32B 采用蒸馏技术,在保持高性能的同时显著减少计算资源消耗;借助 SGLang 和 vLLM 等高效推理计算框架提升生成速度和吞吐量;同时,结合业务场景合理规划请求并发量,优化 GPU 资源配置,确保系统具备横向扩展能力,提升整体推理服务的稳定性和可扩展性。本专题将围绕这些优化策略及其实际应用展开深入探讨。
by 姜慧强
微软亚洲研究院
研究开发工程师长上下文大语言模型推动了众多下游应用的发展,但也带来了计算和内存效率方面的重大挑战。为了应对这些挑战,围绕KV缓存的长上下文推理优化方法应运而生。然而,现有的基准测试通常仅关注单请求场景,忽视了KV缓存在实际使用中的完整生命周期。这一疏漏尤为关键,因为KV缓存复用已在LLM推理框架中被广泛采用,例如vLLM和SGLang,同时也得到了OpenAI、微软、谷歌、Anthropic、Deepseek等LLM提供商的支持。
为填补这一空白,我们提出了SCBench,一个全面的基准测试工具,从KV缓存为中心的视角评估长上下文方法。并且在本次演讲中首先会对目前主流的推理优化方法进行梳理,其次以KV缓存为中心梳理和介绍各类高效长文本方法:1)KV缓存生成,2)KV缓存压缩,3)KV缓存检索,4)KV缓存加载。
演讲提纲:
- 长文本大语言模型的应用和推理挑战
- 当前主流推理优化方法与技术
- 以 KV 缓存为中心的大语言模型推理架构
- 以 KV 缓存为中心的高效长文本方法
- 以 KV 缓存为中心的测试的拓展方法
- 总结与展望
听众收益:
- 了解前沿大语言模型推理引擎的设计发展方向
- 了解前沿高效长文本方法的设计思路和方法
by 张君
华为
高级开发工程师随着大模型技术的快速发展,其在LLM、多模态融合等领域的应用越来越广泛。然而,大模型的高效推理仍然是一个关键挑战,从计算复杂度、内存占用、通信技术等各个技术层面展开,如何在保证性能的同时降低计算成本、提升推理效率成为了关键挑战。
本次演讲将围绕大模型推理优化的技术发展方向,围绕模型层、推理框架层、算子层这3个方面展开,并结合实践案例,阐述相关的技术方案和选型,帮助听众更好地理解和应用大模型推理技术。
演讲提纲:
- 大模型推理加速的技术挑战与常用方案
- 算子融合,如 FA,通算融合
- 模型量化,如 w8a8 等
- Attention容量压缩,如 MLA、GQA 等
- 技术研究热点:模型层、框架层、算子层
- 模型层优化
- 昇腾推理领域加速库ATB
- 推理框架层优化
- - 昇腾图编译技术TorchAir
- - PD分离部署
- - 动态批处理(Dynamic Batching)、Prefix Cache等
- 算子层优化
- 高效融合算子,如MLA算子设计
- NPU 亲和性编程,充分利用 Cube 和 Vector 计算单元能力
- 模型层优化
- 业务实践:推理优化成功案例
- 通信融合算子最大化时间掩盖,如 AllGatherMatmul
- MLAPO大融合算子,加速降低计算耗时
- 下一步优化方向
- PD+大EP 等
听众收益:
- 了解当前华为昇腾推理技术的优化实践
by 向乾彪
腾讯
推理架构师腾讯 AngelHCF 推理加速框架针对混元 LLM 大语言模型做了深度推理优化,结合全新的 Hybrid 模型结构整体上取得了不错的推理成本优势,支撑了元宝线上混元模型上万卡推理。同时,AngelHCF于24 年初即大规模部署上线了万亿 MoE 大模型,针对大规模MoE模型通信特点做了混合切分策略优化,叠加模型压缩、PD 分离等优化手段,显著降低了线上推理成本。本次分享将从不同角度分别介绍腾讯混元推理加速框架 AngelHCF 所做的一些针对性优化,结合全新的Turbos 模型结构,希望能给听众带来一些新的启发。
演讲提纲:
- 腾讯混元模型 & AngelHCF 推理加速框架概述
- 混元 Turbos Hybrid 推理优化
- Mamba Hybrid 模型的推理优势及收益
- kernel 精度以及性能调优
- 显存 & KVCache 优化之路
- 超大规模 MoE 模型并行策略优化
- 各种模型切分策略的优缺点
- 模型并行融合策略
- 通信优化
- PD 分离部署优化
- PD 分离部署的优势
- 请求智能调度策略
- 计算通信 Overlap
- 腾讯混元 & AngelHCF 落地情况和展望
听众收益:
- 了解混元 Turbos Hybrid 结构带来的性能收益以及推理优化手段
- 了解大规模 MoE 语言模型推理加速具体方法&实践
by 李元龙
阿里云
技术专家本次演讲将带领大家逐层解析大模型推理的核心技术。从模型代码讲解 Transformer 前向传播的核心流程与关键模块设计;框架层解读主流推理引擎(如 vLLM/TensorRT)的加速原理与适用场景;深度学习框架揭示 PyTorch 动态图编译、算子优化等底层支持技术;硬件加速剖析 CUDA 并行计算与内存优化策略;最后结合 GPU 特性分析不同硬件对推理性能的影响规律,提供从代码优化到硬件选型的全链路实践指南,帮助开发者快速构建高效推理方案。
演讲提纲:
- 大模型推理技术全景
- 技术演进脉络
- 分层技术体系
- 垂直分层:模型架构层→框架调度层→计算图优化层→硬件指令层
- 横向协同:算法-框架-硬件的联合优化范式
- 模型架构层的推理优化
- 前沿架构优化技术
- 动态计算图优化(DeepSeek的Dynamic Token机制)
- 稀疏激活模式(Mixtral的MoE门控策略)
- 计算-通信重叠(LLAMA的预取策略)
- 前沿架构优化技术
- 推理框架层的加速革命
- 框架技术矩阵分析
- 框架选型决策树
- 计算图编译层的深度优化
- Torch2.x编译技术栈
- 编译实践陷阱
- 硬件层的极限压榨
- CUDA加速范式
- GPU选型决策模型
- 总结与展望
听众收益:
- 为听众提供简明扼要的推理部署优化指南,使用户快速找到适合自己场景的模型推理部署策略
- 了解最前沿的推理优化技术和技术局限性
关注主办方(InfoQ)
联系我们
交通指南
上海中优城市万豪酒店
Shanghai Marriott Hotel Pudong South
地址:上海市浦东新区沪南公路7688弄1号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手