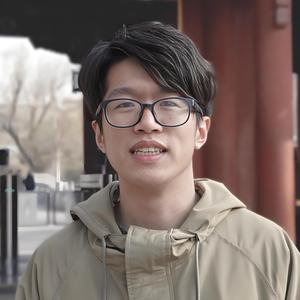
毕业于北京大学。研究聚焦于系统与算法的联合优化,以及高效推理和训练方法的探索,涵盖多个前沿领域,包括动态稀疏注意力机制(如 MInference 和 RetrievalAttention)、KV 缓存优化(SCBench)、提示压缩(LLMLingua)、稀疏推理(PIT)、推测性解码、模型压缩、神经架构搜索和高效微调等。在 ICLR、NeurIPS、SOSP、ACL、EMNLP、ICCV 等国际顶级会议上发表了数十篇高水平论文,并以领域主席和审稿人的身份积极参与学术社区的建设和服务。
讲师介绍
议题介绍
地点:爱那里宴会厅 2
所属专题:大模型推理性能优化策略
演讲:以 KV 缓存为中心的高效长文本方法的优化和实践
长上下文大语言模型推动了众多下游应用的发展,但也带来了计算和内存效率方面的重大挑战。为了应对这些挑战,围绕KV缓存的长上下文推理优化方法应运而生。然而,现有的基准测试通常仅关注单请求场景,忽视了KV缓存在实际使用中的完整生命周期。这一疏漏尤为关键,因为KV缓存复用已在LLM推理框架中被广泛采用,例如vLLM和SGLang,同时也得到了OpenAI、微软、谷歌、Anthropic、Deepseek等LLM提供商的支持。
为填补这一空白,我们提出了SCBench,一个全面的基准测试工具,从KV缓存为中心的视角评估长上下文方法。并且在本次演讲中首先会对目前主流的推理优化方法进行梳理,其次以KV缓存为中心梳理和介绍各类高效长文本方法:1)KV缓存生成,2)KV缓存压缩,3)KV缓存检索,4)KV缓存加载。
演讲提纲:
- 长文本大语言模型的应用和推理挑战
- 当前主流推理优化方法与技术
- 以 KV 缓存为中心的大语言模型推理架构
- 以 KV 缓存为中心的高效长文本方法
- 以 KV 缓存为中心的测试的拓展方法
- 总结与展望
听众收益:
- 了解前沿大语言模型推理引擎的设计发展方向
- 了解前沿高效长文本方法的设计思路和方法
关注主办方(InfoQ)


联系我们
交通指南
上海中优城市万豪酒店
Shanghai Marriott Hotel Pudong South
地址:上海市浦东新区沪南公路7688弄1号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手