多模态大模型开启智能交互新篇章。本论坛深入解析多模态大模型的技术原理,包括不同模... 展开 >
多模态大模型创新实践
会议室:中优大宴会厅 1出品人:林梓佳
- Topic 1
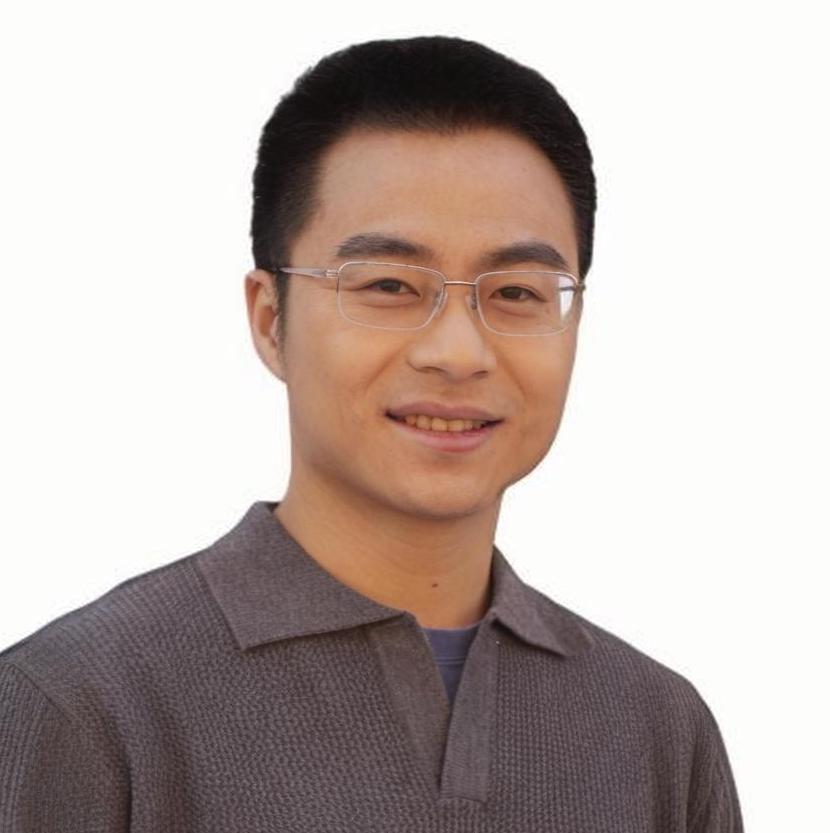
赵波
上海交通大学 人工智能学院 副教授 - Topic 2
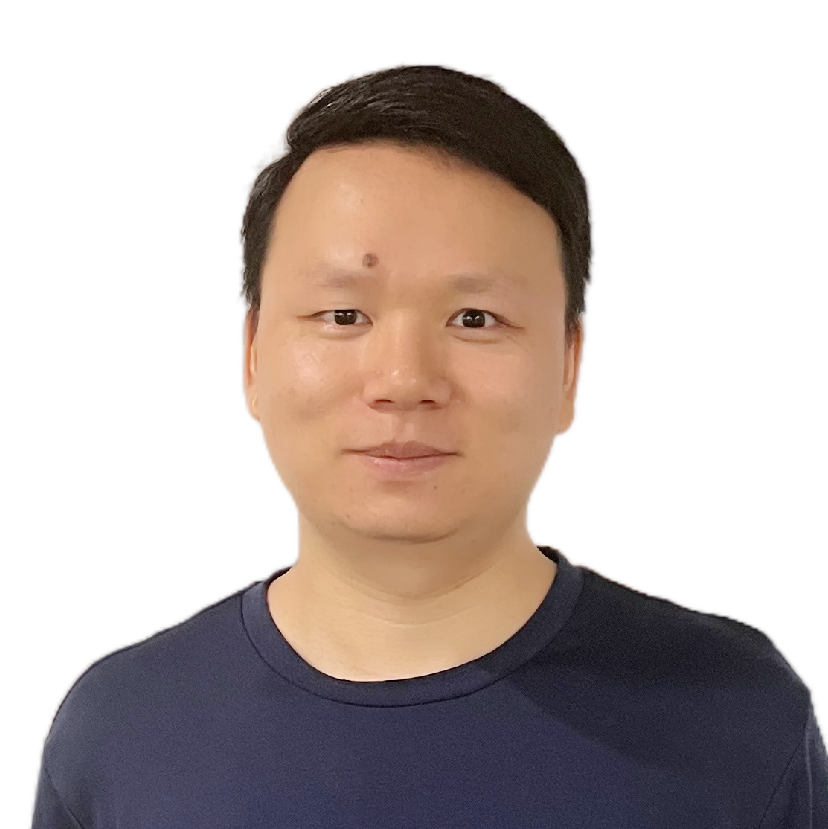
王兆雄
vivo AI 研究院 AI 架构师 - Topic 3
高欢
快手 快意多模态模型算法负责人 - Topic 4
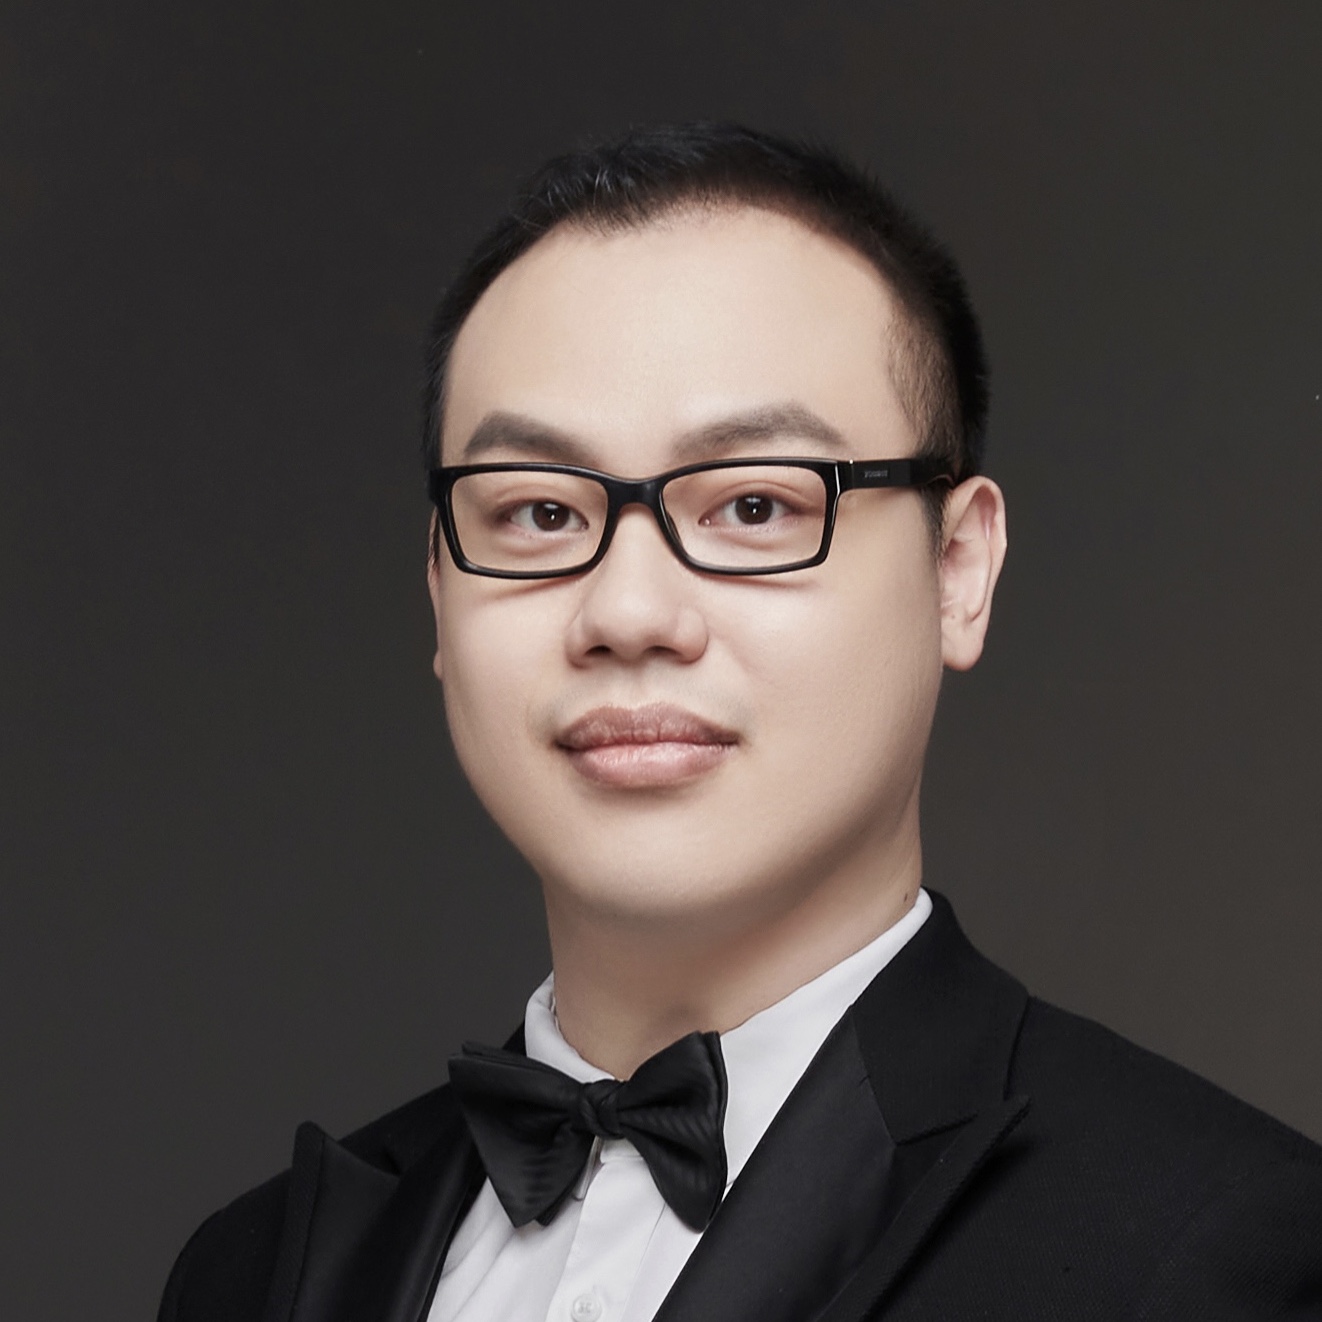
邵帅
腾讯混元 专家研究员
专题出品人:林梓佳
快手多模态大模型负责人
2011年和2016年在清华大学获得学士学位和博士学位,曾获2015 Google PhD Fellowship、北京市优秀博士毕业生等荣誉。曾任微软亚洲研究院主管研究员、阿里巴巴高级算法专家,现任快手NLP专家,负责快意大语言模型的预训练与对齐工作,长期从事人工智能领域相关的研究与应用,专注于自然语言处理、多模态内容理解等方向,已在ICML、NeurIPS、CVPR、ICCV、ACL、EMNLP等国际会议或期刊上发表40余篇学术论文。
地点:中优大宴会厅 1
专题:多模态大模型创新实践
多模态大模型开启智能交互新篇章。本论坛深入解析多模态大模型的技术原理,包括不同模态数据的特征提取与融合策略,探讨其在智能客服、智能驾驶等领域的创新应用,展示多模态大模型如何实现语音、文本、图像等协同交互,提升用户体验和行业效率。
by 赵波
上海交通大学
人工智能学院 副教授近年来,多模态大模型技术发展迅速,展现出强大的视觉理解能力。其中基于大模型的长视频理解任务受到了越来越多的关注,其在教育、影视、安防等领域具有广泛的应用前景。然后由于大语言模型的有效上下文长度有限,难以用有限的 GPU 计算资源实现长视频理解。
针对这一研究问题,课题组首先推出了面向长视频理解大模型的测评基准:MLVU,提供了丰富的评测任务,揭示了主流大模型在长视频理解任务上的能力缺陷。针对长视频数据 Token 数量过多的问题,课题组提出利用可学习 Token 来自适应地压缩视频 Token,从而实现单张卡处理 1 小时以上视频的能力。
演讲提纲:
- 基于大模型的长视频理解任务与挑战
- 主流的视频理解模型与能力测评
- 基于可学习 Token 的视频 Token 压缩技术
- 可学习的压缩 Token
- 自适应切片算法
- 训练数据扩增方法
- 应用实例分析
- 总结与展望
听众收益:
- 了解最新的长视频理解大模型性能和局限性
- 了解最新的长视频理解大模型 Token 压缩技术
by 王兆雄
vivo AI 研究院
AI 架构师多模态大模型在智能客服、自动驾驶、AIGC 等领域的应用需求不断增长,但其训练工程面临计算、存储、数据处理、分布式通信等多重挑战。特别是在千卡级GPU 训练集群上,如何优化数据加载、提升训练稳定性、突破计算与存储瓶颈,成为AI Infra需要重点攻克的难题。本次演讲将基于LLaVA视觉多模态理解模型和FLUX文生图模型的训练工程实践,详细解析大规模GPU训练集群下的数据存储优化、分布式计算策略、训练容错机制,并探讨如何提升大规模多模态模型的训练效率和稳定性。演讲将重点介绍混合并行训练、数据高效加载、自动容错恢复等技术方案,为业界提供可落地的工程实践经验。
演讲提纲:
- 多模态大模型的训练工程挑战
- AI Infra 四大优化方向
- 数据处理优化
- 模型计算优化
- 分布式通信优化
- 训练稳定性建设
- 训练工程案例:LLaVA & FLUX
- 视觉多模态理解模型(LLaVA)的训练优化
- 文生图 FLUX 结构的训练工程
- AI Infra 未来展望
听众收益:
- 深入理解多模态大模型的训练挑战,尤其是理解模型 vs 生成模型的工程区别
- 掌握大规模GPU训练集群的优化策略,包括数据处理、并行计算、通信优化
- 学习如何提升训练稳定性,减少长时间训练中的失败率
- 借鉴 LLaVA 和 FLUX 训练的实际优化经验,为自身多模态模型训练提供参考
by 高欢
快手
快意多模态模型算法负责人2024是AIGC爆发的一年。自年初OpenAI的Sora概念推出以来,各家互联网公司争相进入文生视频的赛道,AI创作出的视频愈加真实且具有美感,满足了更多影视创作和专业用户的需求。同时,生成式的搜索和推荐也逐渐进入各家电商和短视频平台的事业,将用户画像建模和意图理解准确性提升到新的高度。多模态理解技术在这些AI原生应用背后承担着支撑性的作用,显著提升了AIGC的可控性。
本次分享将从国内外多模态理解技术的发展脉络出发,首先介绍行业的几个重点流派。随后将结合快手中的实际需求场景,讲述在技术落地过程中对疑难关键问题的思考和处理方案。同时,多模态大模型训练过程中的规模效应、模型选择、数据构造、训练范式等方面的探索也会被介绍。最后,结合短视频社交平台业务属性和创作者生态的主要关注目标,本次分享中将讨论未来多模态理解数据的发展方向和更多的应用前景。
演讲提纲:
- 多模态理解技术的发展历史
- 多模态理解技术中的几项代表性工作
- 业务及技术挑战(效果方面及性能方面)
- 工业界自研多模态模型和开源多模态模型的对比思考
- 如何训练多模态大模型
- 总结展望
听众收益:
- 了解多模态理解技术及案例
- 了解快手AIGC背后多模态理解技术的实践经验
- 了解前沿多模态理解技术与业务结合的方案和思考
by 邵帅
腾讯混元
专家研究员随着生成式多模态大模型技术的爆发,游戏行业正经历从“人工密集型”到“AI原生驱动”的颠覆性变革。面对高成本、长周期、创意同质化的行业瓶颈,AIGC通过文本、图像、视频、3D、代码等多模态生成,已实现美术、设计、开发的效率提升。然而,游戏美学、风格一致性控制、物理规则、生成内容版权争议等问题仍待解决。本次分享将介绍腾讯在AIGC x 游戏领域的技术进展和业务实践。
演讲提纲:
- 游戏创作的痛点与AIGC的机遇
- 生成式大模型赋能游戏的核心技术
- 生成质量与游戏美学
- 文生图与图生图的对比和思考
- 实时生图的技术难点和优化
- 图生视频的技术难点和优化
- 实时交互式视频生成的技术难点和优化
- 头部企业的工业化实践
- 交互逻辑的升级
- 生产工具的升级
- 未来展望:游戏创作的AI原生时代
听众收益:
- 了解头部游戏公司的AIGC技术落地方法论
- 预判游戏行业与AIGC融合的未来发展方向
关注主办方(InfoQ)
联系我们
交通指南
上海中优城市万豪酒店
Shanghai Marriott Hotel Pudong South
地址:上海市浦东新区沪南公路7688弄1号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手