格灵深瞳研发副总裁,拥有十余年AI工程化经验,曾带领团队研发推理引擎、向量数据库以及数据与训练平台等核心基础设施。现聚焦于AI Infra方向,负责AI模型的训推优化与应用落地工作。
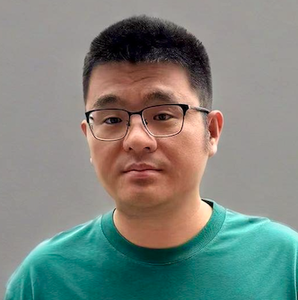
专题演讲嘉宾:闫梓祯
格灵深瞳研发副总裁
by 闫梓祯
格灵深瞳
研发副总裁当前企业级Agent评测面临两大断层:通用Benchmark脱离垂直场景业务目标,生成效果无法量化决策价值。本人在教育、金融、轨交运维等严肃场景中,探索出一套融合领域知识、多模态感知与决策链追溯的评测体系。本次分享将解析如何通过动态数据沙盒、决策链可解释性验证、业务指标映射模型,解决“高分低能”痛点,并推动Agent从对话能力向决策智能进化。
演讲提纲
- 企业Agent评测的难点:
- 数据真空:研发阶段无法提前获取真实数据
- Agent的效果没有统一的标准,依赖人的“感受”,难以衡量实际价值,长尾场景无法模拟
- 现有评测机制的介绍和问题:
- 通用benchmark难以反映真实业务需求
- “高分低能”
- 自动化评测系统:
- 数据的模拟和生成
- 多维度指标的构建
- 迭代过程中评测的原则
- 严肃场景实战案例:
- 结合业务Agent实践分享
您认为,这样的技术在实践过程中有哪些痛点?
严肃场景下,Agent评测过程和结论仍然需要业务专家的review,无法完全脱离人
您的演讲有哪些前沿亮点?
针对企业的Agent自动化评测的流程与方法
- 垂直领域评测的独特性:严肃场景约束:教育-体育中考/高铁检修/银行等场景对容错率要求极高,需结合传感器融合与时序推理能力验证。
- 决策智能的量化评估
- 从生成质量到决策价值
- 传统指标:关注响应相关性、流畅度
- 决策指标:动作执行闭环率(如AI教练纠正动作后学生体能达标率提升)、异常处理时效(轨交Agent故障响应缩短)
- 可解释性验证工具链:展示决策链追溯界面,证明评分结论如何关联到视频动作分割、传感器时序对齐等底层证据
- 低成本动态评测系统
- 业务指标映射:将“体育考试效率”转化为“单日考生吞吐量”“误判率”等可量化Agent指标
听众收益
- 了解toB场景下,Agent构建和评测的难点
- 如何构建符合需求场景的评测集
- 如何在评测分数的指导下,迭代智能体的开发
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手