凭借近十年硅谷顶尖科技企业历练,成功打通AI技术全栈能力。前后分别在Google X Lab、Mineral.ai等公司分别负责核心AI系统/应用的研发,深度贯通Infra 、底层算法(大模型训练/推理等)、系统工程(异构计算、弹性架构)与AI 产业应用研发,构建了“理论创新-工程落地-生态反哺”的完整技术闭环。目前在GMI Cloud负责云平台产品的研发工作。
GMI Cloud 推理实践:Inference Engine在全球范围内的大规模集群调度和优化
所属专题:AI Agents 能力构建与全球推理加速
嘉宾 : YuJing Qian | GMI CloudVP of Engineering
会议室 : 201AB
讲师介绍
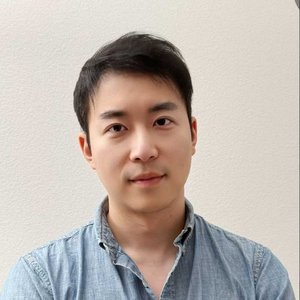
专题演讲嘉宾:YuJing Qian
GMI CloudVP of Engineering
议题介绍
地点: 201AB
所属专题:AI Agents 能力构建与全球推理加速
演讲:GMI Cloud 推理实践:Inference Engine在全球范围内的大规模集群调度和优化
随着AI的迅猛发展,出海企业面临全球多推理集群分散部署的难题。不同国家和地区异构算力资源的差异,以及传统调度模式下资源碎片化、任务协同效率低等问题,导致推理性能无法满足全球化业务需求。尤其在跨境实时交互场景中,各集群孤立运行,严重制约了 AI 服务的响应速度与用户体验。为打破出海算力调度瓶颈,满足全球化业务对推理性能的严苛要求,GMI Cloud推出Inference Engine推理引擎(简称IE)。本演讲将深度拆解该引擎面对热门大模型推理优化架构逻辑和技术实践,目前已成功上线、优化基于H200的Qwen 3、DeepSeek全系列、Llama 4等热门模型,并实现全球快速扩容。
演讲提纲:
1. 详细阐述 Inference Engine 各组件的设计思路,包括组件的功能、相互间的协作方式,以及如何适应全球多推理集群的复杂环境。
2. 介绍基于 Dynamo 的推理引擎实施 P/D 分离的具体架构设计过程,分析分离前后的性能变化,以及这种实践在优化推理过程中的重要作用。
3. 探讨 KVCache 的池化策略,说明GMI Cloud推理引擎如何通过优化访存方式提高数据访问效率,减少推理过程中的延迟,提升整体性能。
4. 深入讲解GMI Cloud推理引擎优化器的工作原理,展示其在优化推理过程中的具体应用,包括对模型结构、计算资源等方面的优化策略。
5. 介绍 GMI Cloud 平台上 Inference Engine 的一键式优化部署实现方式,阐述部署过程中的关键步骤和技术要点,以及如何确保部署的高效性和稳定性。
听众受益:
1. 了解基于dynamo PD分离实现的最佳实践
2. 获取如何将GPU资源最大化的架构方案
3. 了解“可节省开发者大量时间和成本”的引擎优化工具
4. 了解在出海场景下最优化的推理解决方案
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手