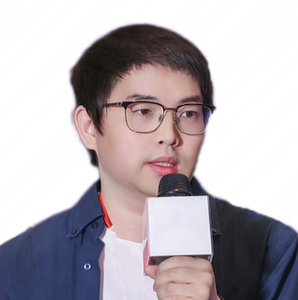
网易有道机器翻译及大模型业务负责人,承担多项技术攻坚项目,为有道翻译,有道智云,词典笔等产品提供人工智能技术支持,产品服务近亿用户;在NLP领域国际顶级学术会议上发表多篇论文,担任ACL、EMNLP等顶级会议的审稿人,拥有多项发明专利的授权。
讲师介绍
议题介绍
地点:203
所属专题:AI 驱动的智能硬件创新
演讲:LLM技术在有道词典笔上的应用实践
本次分享将聚焦端侧大模型,深入探讨其落地过程中的挑战与实践。通过大模型摩尔定律及相关技术阐述原因,并对比端侧 AI 与云侧 AI 的优劣,介绍端侧 AI 应用场景及有道教育智能硬件特点。端侧大模型落地面临算力、内存、功耗、成本、算法质量、多应用部署等挑战,需平衡各项指标。以有道子曰大模型为例,分享云侧、云端结合、端侧 LLM 三种落地模式。在端侧大模型算法方面,详细介绍模型压缩技术及 LLM 带来的变化与新问题,通过实验确定蒸馏、DPO、词表裁剪、量化等方案,并对推理进行性能优化,端侧大模型成功落地有道词典笔 X7、X7 Pro,开启词典笔部署本地大模型新时代,未来还计划扩展功能。
演讲提纲
- 有道智能硬件应用介绍
- 端侧大模型面临的挑战
- 有道子曰大模型的落地模式
- 端侧大模型的算法优化与推理性能提升
您认为,这样的技术在实践过程中有哪些痛点?
端侧大模型落地面临多方面挑战。算力和内存上,与云侧相比差距大,如端侧 RK3562 芯片对比云侧 4090GPU,算力低千倍以上,内存低 20 多倍。功耗方面,端侧设备如手机、词典笔需考虑待机时长,优化底层 AI 引擎与上层 APP 功耗难度大。成本限制下,为有市场竞争力需降低成本,可能导致所选芯片更弱。此外,要保证模型质量,且端侧设备常部署多个应用,各模块抢资源,需综合优化满足用户体验。
您的演讲有哪些前沿亮点?
为解决端侧内存限制问题,采用模型压缩技术。以有道子曰大模型为例,运用蒸馏技术,引入片段级语料并确定合适训练集规模,有效提升模型效果。采用 DPO 算法进行强化学习,进一步优化模型性能。通过词表裁剪,在保证模型质量的同时减少内存占用,并选用 AWQ 量化算法,在量化过程中兼顾模型精度与内存优化 。
听众收益
- 理解端侧模型与硬件深度融合的关键路径,助力本地智能化部署。
- 了解端侧大模型的技术挑战与应对策略,掌握行业最新趋势。
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手