本专题聚焦于大模型服务背后的智算基础设施与基础大模型研发中的前沿技术与实践。内容... 展开 >
大模型智算与开发落地实践
会议室:百乐园出品人:王浩 博士
- Topic 1
曾奥涵
智谱 AI GLM 模型预训练 & 基础设施负责人 - Topic 2
张跃伟
阿里巴巴 行业大模型智算技术负责人 - Topic 3
- Topic 4
张宇鹏
百川智能 算法专家 - Topic 5
商恒超
华为 翻译中心高级工程师
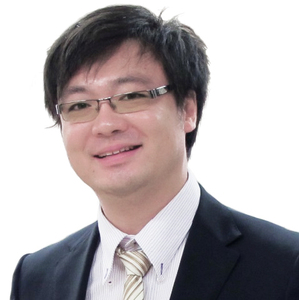
专题出品人:王浩 博士
阿里云智能政企事业部大模型智算负责人
现任阿里云政企事业部行业大模型首席科学家,负责政企AI大模型智算产品研发。曾任阿里巴巴达摩院人工智能实验室天猫精灵智能语音助手产品算法负责人。之前曾是360搜索首席科学家以及中国科学院教授,成果大多发表在人工智能国际顶级会议和期刊:KDD、NeurIPS、SIGIR、AAAI、IJCAI、WWW、ICDE、ACM MM、ECCV、ICCV、TOIS、TKDE、TPAMI、TIP等。
地点:百乐园
专题:大模型智算与开发落地实践
本专题聚焦于大模型服务背后的智算基础设施与基础大模型研发中的前沿技术与实践。内容涵盖AI基础设施的构建、大模型的研发经验,以及应用落地的开发实战。通过深入探讨大模型AI Infra的设计、训练与推理架构优化,并结合多场景、多行业的应用案例,旨在为开发者、研究人员和技术专家提供有价值的参考,推动智算技术在算力基础设施建设及业务场景创新应用中持续释放价值
by 曾奥涵
智谱 AI
GLM 模型预训练 & 基础设施负责人智谱 GLM 技术团队专注于面向通用人工智能(AGI)的基础模型研发,早在 2022 年就训练并开源了媲美 GPT-3 性能的中英双语预训练模型 GLM-130B,后续发布的 ChatGLM 开源模型系列在 Hugging Face 社区上获得了超过一千万的下载量;2024 年 8 月,GLM 团队发布的旗舰模型 GLM-4-Plus 在 9 月的 SuperBench 大模型评测中位列世界前三。
智谱这些模型展现出来的卓越性能离不开海量互联网数据和算力训练。与此同时,大语言模型的兴起给训练基础设施带来全新的挑战,包括对算力、大规模数据处理量、复杂的系统管理等需求。针对自身的特定需求,我们从零开始构建了一套大模型原生的训练基础设施。针对大规模训练稳定性、多算力集群数据流转、平台易用性等进行了一些优化,本次演讲将分享平台构建中的经验与心得体会。
演讲提纲:
- 大模型时代的算力需求和平台特征
- 算力基础设施概述
- 大模型训练流程介绍
- 现有开源工具对比
- GLM 训练基础设施的挑战与演进历程
- 易用性挑战
- 资源管理挑战
- 多云异构挑战
- 大模型原生训练基础设施的系统设计
- 核心功能抽象
- 核心资产抽象
- 训练稳定性保障措施
- 多云架构下存储的复杂度管理
- 总结展望
听众收益:
- 了解构建大模型原生基础设施的关键技术和挑战
by 张跃伟
阿里巴巴
行业大模型智算技术负责人模型量化通过降低权重精度减少计算量与内存占用,加速推理过程并降低能耗,对于提升大模型在资源受限设备上的部署效率至关重要。以往 PTQ 量化方法忽略不同层权重对量化精度的敏感性,且在超低比特量化下(2-3位)精度损失严重,论文针对这两个问题,提出 AMLQ( Adaptive Mixed precision and Low-rank Quantization error reconstruction) 量化方法,极大减少模型量化的精度损失,并提高推理速度。量化方案详情可参考:https://openreview.net/pdf?id=T5pGDydMkS
演讲提纲:
- 大模型在推理实践中的挑战
- 大模型量化技术
- AMLQ:低比特无损量化
- 大模型推理和量化展望
听众收益:
- 深入了解无损量化技术的最新进展
- 启发听众对于无损量化技术未来研究方向及应用场景思考
研讨问题:
- 如何看待当前算力瓶颈对大模型训练的限制?是否有新的技术或架构可以突破这一瓶颈?
- 随着大模型的规模不断扩大,数据和计算资源之间的平衡如何保持?未来的 Scaling Law 是否需要考虑更多的资源优化策略?
- 现有的 AI 芯片架构(如 NVIDIA 的 GPU 和 Google 的 TPU)在应对推理和训练需求时,是否会面临效率和性能的瓶颈?
- AI 芯片的硬件与软件结合(如 CUDA、TensorRT)的优化是否会影响竞争格局?新的计算框架和工具是否有可能成为行业标准?
by 张宇鹏
百川智能
算法专家演讲主题聚焦于优化模型训练中的数据质量控制,以提高模型在有限资源下的表现。背景方面,许多轻量化模型如 Phi 系列,通过严谨的质量控制,在较少数据和较低算力(FLOPs)支持下,达到了显著的效果提升。当前开源数据集的趋势集中在增多 Tokens 和更精细化的质量筛选,以获得更小、效果更佳的数据集。此外,去重策略需要根据具体业务需求定制,更高比例的去重未必能带来更优结果,且数据质量这一概念难以仅依赖人类偏好定义。
解决方案上,提出了基于模型自我学习能力和人类标注结合的数据筛选策略,从模型自身、人类反馈及自我学习三个角度确保数据质量。研究发现,基于知识类别的分类采样在数据组织上优于单一领域粒度采样,并能在多样化数据需求中获得更佳表现。进一步地,通过小模型拟合 Scaling Law 的方式确定数据配比,大幅减少了对大模型实验的依赖,降低实验成本。整体实施效果验证了通过精细化的数据控制,模型在有限资源下的表现显著提升,形成了模型训练中的新策略与实践。
演讲提纲:
- 为什么数据质量重要
- 开源数据集时间线,token 数越来越多,少量高质量精选数据
- 主流数据处理Pipline
- 为什么要去重?
- 去重率越高效果越好吗?
- Quality Filter
- 人工选择
- 模型选择
- 自我学习
- Knowledge Classification
- Scaling Laws for Data Mix
听众收益:
- 了解融合人类反馈与模型自我学习的数据优化方法
- 学习数据质量控制与筛选新思路
by 商恒超
华为
翻译中心高级工程师随着 ChatGPT 的出现,大模型获得了前所未有的热度,但关于大模型研究主要聚焦在高资源语种上(如英文、中文),对中低资源语种的支持相对较差。如何在中低资源语上进行大模型业务落地,是一个非常有价值且值得探索的问题。
本次分享将介绍华为翻译中心以翻译技术为出发点,提升大模型在低资源语种的表现,并且以阿语和泰语为例,详细介绍模型的适配、翻译技术的应用、以及业务场景的落地等。
演讲提纲:
- 多语言大模型现状
- 盘古多语言大模型支持阿语、泰语的实现
- 盘古多语言大模型的落地应用
- 多语言大模型的问题与未来探索
听众收益:
- 了解如何低成本实现大模型向中低资源语种的能力迁移
- 了解传统翻译技术在多语言大模型优化时的应用
- 了解多语言大模型的RAG和Agent落地实践
关注主办方(InfoQ)
联系我们
交通指南
北京丰大国际大酒店
Beijing Fengda International Hotel
地址:北京市大兴区荣华中路20号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手