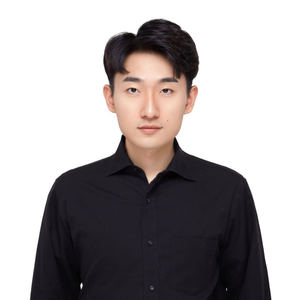
2023 年 7 月加入百川,参与一系列开源闭源模型的构建,百川预训练数据方向负责人,曾在 2019 年加入腾讯,参与腾讯混元大模型构建。
讲师介绍
议题介绍
地点:百乐园
所属专题:大模型智算与开发落地实践
演讲:百川智能预训练数据策略的探索与实践
演讲主题聚焦于优化模型训练中的数据质量控制,以提高模型在有限资源下的表现。背景方面,许多轻量化模型如 Phi 系列,通过严谨的质量控制,在较少数据和较低算力(FLOPs)支持下,达到了显著的效果提升。当前开源数据集的趋势集中在增多 Tokens 和更精细化的质量筛选,以获得更小、效果更佳的数据集。此外,去重策略需要根据具体业务需求定制,更高比例的去重未必能带来更优结果,且数据质量这一概念难以仅依赖人类偏好定义。
解决方案上,提出了基于模型自我学习能力和人类标注结合的数据筛选策略,从模型自身、人类反馈及自我学习三个角度确保数据质量。研究发现,基于知识类别的分类采样在数据组织上优于单一领域粒度采样,并能在多样化数据需求中获得更佳表现。进一步地,通过小模型拟合 Scaling Law 的方式确定数据配比,大幅减少了对大模型实验的依赖,降低实验成本。整体实施效果验证了通过精细化的数据控制,模型在有限资源下的表现显著提升,形成了模型训练中的新策略与实践。
演讲提纲:
- 为什么数据质量重要
- 开源数据集时间线,token 数越来越多,少量高质量精选数据
- 主流数据处理Pipline
- 为什么要去重?
- 去重率越高效果越好吗?
- Quality Filter
- 人工选择
- 模型选择
- 自我学习
- Knowledge Classification
- Scaling Laws for Data Mix
听众收益:
- 了解融合人类反馈与模型自我学习的数据优化方法
- 学习数据质量控制与筛选新思路
关注主办方(InfoQ)
联系我们
交通指南
北京丰大国际大酒店
Beijing Fengda International Hotel
地址:北京市大兴区荣华中路20号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手