研究方向为数据挖掘与深度学习,主持国家自然科学基金青年基金、CCF- 腾讯犀牛鸟基金和阿里巴巴创新研究计划 (AIR) 等项目,在 KDD、NeurlPS、TKDE、TOIS 等高水平期刊和会议上发表论文 50 余篇,获中国科大“墨子杰出青年特资津贴”资助,担任如 KDD、NeurlPS、WWW 等国际程序委员会委员及 TKDE、TOIS 等高水平期刊审稿人,人工智能智能计算服务专委会委员,相关工作 Google 学术引用 1400 余次。
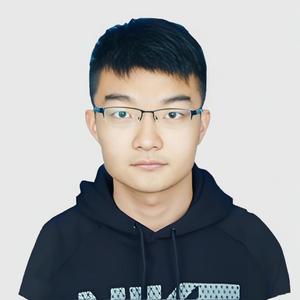
专题演讲嘉宾:王皓
中国科学技术大学特任副研究员
by 王皓
中国科学技术大学
特任副研究员大模型已经广泛应用于推荐系统,它们通过处理海量数据,能够精准地捕捉和预测用户的兴趣偏好,为用户提供个性化的推荐服务。最新的研究工作表明,与传统推荐算法相比,基于大模型的推荐系统在性能上实现了质的飞跃。
然而,大模型的有效性并非没有挑战,例如大模型的训练需要依赖于高质量的数据。数据的质量直接影响到模型的学习和预测能力。数据的收集、清洗和处理过程复杂且成本高昂。
我们通过在序列推荐中针对用户数据生成、用户多行为分析及推荐系统中的大模型架构等多方面优化,提升了推荐性能,本次将重点分享这些实践。
演讲提纲:
- 传统推荐 vs 大模型推荐
- 大模型推荐相关工作
- 大模型中推荐数据生成
- 多行为推荐大模型
- 实践观察与结论
听众收益:
- 了解大模型在推荐系统相关现状
- 了解大模型在推荐系统中的相关实践尝试与经验
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手