北京大学博士,中科院计算所博士后。FlagEval 核心贡献者,主要研究多领域、多维度的基础模型评测方法及工具。
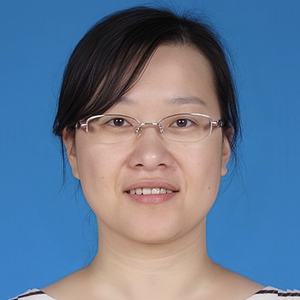
专题演讲嘉宾:杨熙
智源研究院智能评测组负责人
by 杨熙
智源研究院
智能评测组负责人大型语言模型 (LLMs) 在各种任务中取得了卓越的性能, 并在现实世界中得到了广泛应用。然而,LLMs 容易出现幻觉, 生成与已知知识相冲突或不忠实于原始信息来源的内容,影响了 LLMs 在很过高厉害场景上的应用。现有的幻觉基准主要关注句子或段落层面的幻觉检测, 忽略了对话层面的评估、幻觉定位和原因解析。为了缓解现有幻觉评估的局限性, 我们提出了 HalluDial, 第一个全面的大规模自动对话级幻觉评估基准。利用 HalluDial, 我们对 LLMs 在信息搜索对话中的幻觉评估能力进行了全面的元评估, 并引入了一个专门的判断语言模型 HalluJudge。HalluDial 的高数据质量使 HalluJudge 在幻觉评估中取得了优异或有竞争力的性能, 有助于自动评估 LLMs 中的对话级幻觉, 并为这一现象提供了宝贵的实验验证基础。
演讲提纲:
- 研究背景
- 幻觉问题的定义与危害
- 幻觉检测技术的现状与挑战
- 幻觉检测工具构建
- HalluDail 评测集的构建
- HalluJudge 模型构建
- 实验结果
- 不同大模型的整体表现对比
- 模型在不同类型测试上的得分分析
- 典型案例分析和展示
- 总结与展望
听众收益:
- 深入理解幻觉现象
- 掌握对话级幻觉评估的新方法
- 探索幻觉原因与解决方案
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手