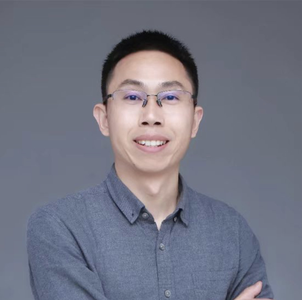
英特尔数据中心和AI事业部首席工程师。2007年硕士毕业于中国科学技术大学。精通英特尔软件架构、英特尔产品与技术以及IA平台性能优化。在英特尔工作期间,为国内主流ISV开发出基于IA平台的云计算产品过程中提供关键支持,并优化了多家主要互联网公司的核心产品,使其性能提升数倍。对PyTorch,Tensorflow等AI框架有深入研究,拥有10年以上软件优化经验。
讲师介绍
议题介绍
地点:钻石厅B
所属专题:AI全栈解决方案及行业实践
演讲:xFT解锁至强算力,释放AI潜能
在过去的两年中,无论是开源还是闭源的大型语言模型,都在多种任务上展现出了卓越的性能。这些模型为了充分发挥其潜力,通常依赖于配备了大量显存的GPU,以便最大化硬件的计算资源。然而,GPU显存的物理限制经常迫使开发者采取复杂的软件设计策略,以提高模型的训练效率和推理速度。此外,在当前国际环境的复杂多变背景下,GPU资源可能并非总是可用或可靠。在这种情况下,Xeon CPU作为一种广泛可用的计算资源,成为了一个实用的备选方案。虽然CPU在原始计算能力上可能不及GPU,但是通过精心设计的优化技术,CPU同样能够有效地执行大型语言模型的推理任务,确保在缺乏GPU的情况下,这些强大的模型依然可以得到广泛的应用。
在本次演讲中,我们将深入讨论如何根据Xeon CPU的特性进行优化,并展示一系列策略,以高效地在Xeon CPU上部署和运行大型语言模型。通过这些优化技术,我们旨在最大化CPU的特性,以支持复杂的大型语言模型,为缺乏GPU的环境提供强有力的技术支撑。此外,我们还将探索在CPU与GPU混合计算环境中,如何有效地利用CPU辅助GPU,以最大化整个系统的资源利用率和提升计算效能。
演讲提纲:
- 引言
- 当前大型语言模型的发展动态
- 大型语言模型对软硬件的挑战
- 针对Xeon CPU的优化策略
- Xeon CPU架构特点
- 并行计算优化:包括并行化、向量化、矩阵化等
- 内存管理优化方法
- 如何在混合计算环境中最大化CPU性能
- 优化前后性能的比较分析
- 在Xeon CPU上部署和运行大型语言模型
- 最佳部署实践
- 性能调优案例分析
- 优化成果演示
- 结论与展望
- 优化Xeon CPU对大型语言模型推理的重要性
- 对未来硬件和软件设计优化的前瞻
听众收益:
- 学习到如何针对特定硬件平台(如Xeon CPU)进行性能优化
- 获得实际操作的最佳实践和优化建议
- 了解行业内的最新研究成果和发展趋势
- 对如何评估和提升自己项目中的模型性能有具体的指导意义
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手