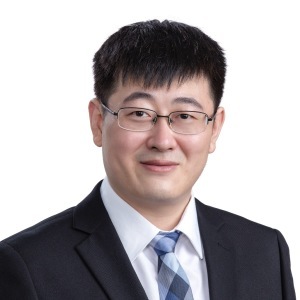
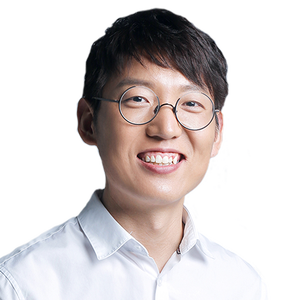
冯佳时,字节跳动研究科学家。现任字节跳动豆包大模型视觉基础研究团队负责人。曾任新加坡国立大学电子与计算机工程系助理教授,机器学习与视觉实验室负责人。研究方向包括深度学习与计算机视觉。目前主要研究多模态基础模型、生成模型、3D 建模。曾获得麻省理工科技评论 35 岁以下创新者(亚洲),ACM MM 最佳学生论文奖,ICCV TASK-CV 讨论会最佳论文奖,CVPR2021 最佳论文奖提名。曾担任 CVPR、ICML、ICLR、NeurIPS 等会议的领域主席。
讲师介绍
议题介绍
地点:钻石厅 C
所属专题:主题演讲
演讲:大语言模型在计算机视觉领域的应用
近年来,大语言模型 (LLMs) 在文本理解与生成领域取得了显著进展。然而,LLMs 在理解和生成自然信号(例如图像,视频)等,还处在比较早期的探索阶段。本次演讲将介绍字节跳动视觉基础研究团队在这个方向的探索与进展,包括 LLMs 在图像理解与视频生成上的阶段性结果。
演讲提纲
- 计算机视觉领域的一些基础问题
- 当前LLM 在解决计算机视觉问题的局限
- 基础研究团队的思路和研究方向
- 项目分享1: LLM 在图像理解上的应用
- 项目分享2: LLM 在视频生成上的应用
- 总结与展望
听众收益
- 企业内部的一些技术进展与研究方法
- LLMs 在计算机视觉领域的应用方法
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手