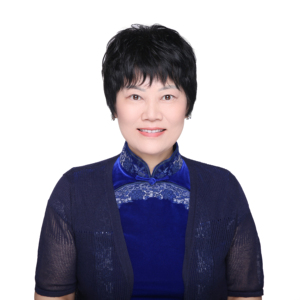
北京大学,计算机学院二级教授,博士生导师。自 1984 年考入北京大学,分别获得学士、硕士和博士学位。2000 年至今历任三届教育部高等学校大学计算机教学指导委员会委员,ACM/IEEE CC2020 计算学科规范执委,中国计算机学会 CCF 杰出教育奖获得者,机器学习领域最好的会议 ICML2014 最佳论文奖获得者。所主持的“数据结构与算法”被评为国家级精品课程、国家级优质资源共享课、国家级精品在线开放课程、首批国家级一流本科课程。研究方向为招文本挖掘、图机器学习、教育大数据等,发表论文 300 余篇,谷歌学术被引 18000 余次,H 因子 47。目前主持国家重点研发课题和自然科学基金面上项目以及头部公司合作项目,进行前沿探索,解决实际问题并且重视科研成果的转化落地。
讲师介绍
议题介绍
地点:钻石厅 A
所属专题:大模型数据集构建及评测技术落地
演讲:全方位评测神经网络模型的基础能力
现有的数据集主要集中在检验模型解决专家级别难题的能力上,难以反映模型在基础知识方面的掌握情况。由于缺乏和人类表现相关的数据,因此科学家也不可能获取到更具实际意义的模型表现参考,严重阻碍了人工智能的健康发展。
为了攻克这些局限性,我们团队成功构建了首个多模态 STEM 数据集,并且在此基础上实现对大语言模型与多模态基础模型的评测。评测的结果发现,即使是目前最先进的人工智能模型,其 STEM 基础水平也存在较大的提升空间,尚不具备解决更有难度的现实问题的能力。也就是说,与人类智能相比,目前人工智能的水平还有一定差距。此外,团队还提出了一个新的社会学科数据集 Social,包含较大规模的文本评估数据,可用来评测大语言模型的社会学科基础能力;团队还设计了一种多智能体交互的方法,能够增强大语言模型在 Social 数据集上的表现。这些数据集可以进一步推动当前多模态大模型的研究。
演讲提纲:
- 当前视觉多模态大模型评测面临的问题
- 视觉多模态大模型 STEM 数据集与评测方式介绍
- 近期方法在STEM数据集上的评测结果
- 大语言模型社会规范评测数据集 SocialNorm 介绍
- 大语言模型能力提升:SocialAgent 方法介绍
听众收益:
- 了解多模态评测相关进展探索
- 了解大语言模型通用智能体方法进展探索
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手