清华大学计算机系博士后,新加坡国立大学计算机学院博士后。研究工作包括多模态大模型、信息抽取、知识图谱,重点关注构建高效可信的多模态大模型,实现深度图文理解。曾以第一作者 / 共同一作 / 通讯作者在人工智能国际顶级会议 ACL、EMNLP、NAACL、CVPR、ICCV、ECCV、ICLR、NeurIPS、ICML 及国际顶级期刊 Nature Communications 上发表论文 10 余篇,论文入选 ICLR Spotlight、ECCV Oral、Nature Communications Editors' Highlights 等亮点推荐专栏,相关成果 Google Scholar 引用量 3000 余次。曾获清华大学计算机系优秀博士及本科毕业生、清华大学综合优秀一等奖学金、腾讯犀牛鸟精英人才培养计划一等奖学金等。曾任中国中文信息学会青年工作委员会学生执委会副主任。博士学位论文《基于多模态大模型和结构化知识的图文理解方法研究》获 2023 年度吴文俊人工智能科学技术奖优秀博士学位论文奖。
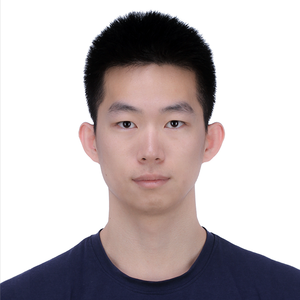
专题演讲嘉宾:姚远
面壁智能研究员 & 清华大学计算机系博士后
by 姚远
面壁智能
研究员 & 清华大学计算机系博士后多模态大模型的能力突破,正在成为人工智能发展的前沿制高点。尽管多模态大模型的能力在迅速增长,但在其迈向实用化过程中仍面临严峻挑战:(1)参数规模大,计算成本高;(2)图像感知分辨率严重受限;(3)英文多模态能力强,中文多模态能力弱;(4)幻觉频繁,难以置信。在本次分享中,我将简要介绍我们在这些方面的最新工作。基于这些技术,我们构建了高效端侧多模态大模型系列 MiniCPM-V。最新发布的 MiniCPM-V 2.0 总参数量 2.8B,具备以下特点:(1) 性能领先,在 OpenCompass 榜单总计 11 个常用评测基准上综合得分优于 17B-34B 主流模型;(2) OCR 能力突出,TextVQA 场景文字理解能力与谷歌 Gemini Pro 相当,OCRBench 性能取得开源社区最佳水平;(3) 高清图像编码,支持 180 万像素高清任意长宽比图像无损编码;(4) 可信行为,在 Object HalBench 达到和 GPT-4V 相当的低幻觉率;(5) 双语支持,具有领先的中英双语多模态能力;(6) 高效计算,可在安卓和鸿蒙系统手机端部署运行。MiniCPM-V 2.0 在国际开源平台 HuggingFace 60 万余模型中,连续多天登上 Trending 榜单前三名。自 2024 年 2 月发布以来,相关开源多模态大模型累计下载次数 10 万余次。
演讲提纲:
- 多模态大模型迈向实用化的挑战分析
- 团队近期前沿探索
- 端侧基座大模型构建
- 高清图多模态大模型
- 多模态能力跨语言泛化
- 多模态人类反馈强化学习
- 高效端侧多模态大模型系列 MiniCPM-V
听众收益:
- 了解当前多模态大模型在实用化过程中所面临的挑战,包括参数规模、计算成本、图像感知分辨率、语言能力等方面的限制
- 了解针对参数规模和计算成本的优化策略、图像感知分辨率的提升技术、语言能力的加强方法等
关注主办方(InfoQ)


联系我们
交通指南
北京乐多港万豪酒店
Beijing Marriott Hotel Changping
地址:北京市昌平区南口路29号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手