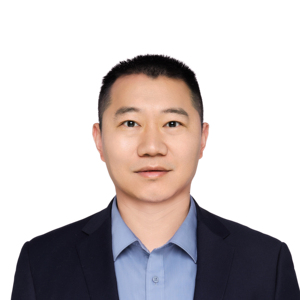
专题演讲嘉宾:王育军

小米语音技术负责人

技术委员会 AI 实验室声学语音方向负责人。先后在学术界和工业界从事声学语音方向 20 年。国家知识产权局中国专利审查技术专家。主要研究兴趣包括声音的感知,理解,生成与展现。先后就读于清华大学和伯明翰大学。后就职于 NEC,鲁汶大学,百度等机构。

团队简介:
声学语音团队成立于 2017 年,下设语音理解、生成与测量三个领域,包括语音识别、声音分析还原、阵列拾音、语音唤醒、声纹识别、通话降噪、主动降噪、声学测量、声音视觉跨模态感知理解、口语评测、语种识别、声音情绪识别、语音合成、声景合成、音乐生成、声音复刻、虚拟形象生成以及空间音频 17 个子方向。为小米的手机 AIoT 平台 79 个设备品类,5312 个智能终端,日均提供语音服务 12.6 亿次。先后获得 7 项国内外声学语音挑战赛冠军。在国际行业会议上发表论文 43 篇。


by 王育军

小米
语音技术负责人

声音是人与人,人与自然交互的重要模态之一。对声音的理解和生成贯穿这个交互的过程,也是从声音种提炼信息并还原和展现成新信息的过程,可以用声音模态的编码和解码来表述。编解码范式已经是大模型时代的 Magic Word。这个范式已经造就了成功的各种语音应用案例,比如 OpenAI 或者字节的语音合成,OpenAI 和 Meta 的大模型语音识别,以及小米和 Meta 的声音理解。

这些应用需要不同层面和不同粒度的声音编解码。在编解码两端都需要模态内部更强的自我解释能力。为此,我们一直坚持探索声音基础模型的建设,来关注声音的自我解释能力,从而助力语音识别,语音合成以及声音的还原或降噪。

演讲提纲:

  1. 小米的声音基础模型的演进
  2. 声音基础模型如何从编解码两侧精准助力声音的理解与生成
  3. 挑战与展望

听众收益:

  • 了解声音基础模型如何从编解码两侧精准助力声音的理解与生成

交通指南

北京乐多港万豪酒店

Beijing Marriott Hotel Changping
地址:北京市昌平区南口路29号
  • 微信咨询

  • 电话咨询

    联系电话:13269078023

微信联系我们

如您在购票过程中遇到问题,请扫码咨询票务小助手