本专场将重点关注端到端智能语音交互、全双工、多模态等语音前沿技术,将邀请国内外一... 展开 >
智能语音前沿技术应用
会议室:宴会厅C出品人:王育军
- Topic 1
周力 博士
红棉小冰 技术VP - Topic 2
陈云琳
出门问问 资深语音工程师 - Topic 3
王玉平
字节跳动 产品研发和工程架构部算法专家 - Topic 4
李杰 博士
快手 资深语音算法专家
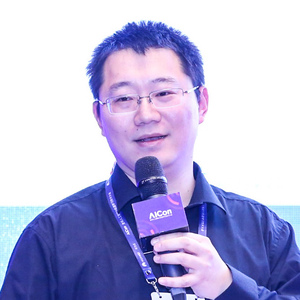
专题出品人:王育军
小米语音技术负责人
2000 年毕业于清华大学自动化系,随后赴英国伯明翰大学电子系学习人机交互。2002 至 2004 年就职于 NEC 电子,从事嵌入式语音识别与语音合成。随后加入中软国际从事声学模型训练技术。2007 年到 2012 年在比利时鲁汶大学电子系从事抗噪语音识别。回国后加入百度语音技术部。2015 年就职于乐视,负责语音识别与自然语言理解技术。2017 年加入小米,负责语音识别与语音合成技术。
地点:宴会厅C
专题:智能语音前沿技术应用
本专场将重点关注端到端智能语音交互、全双工、多模态等语音前沿技术,将邀请国内外一线技术专家为大家分享最新技术进展和实践经验,希望可以给大家带来新的启发。
by 周力 博士
红棉小冰
技术VP人+AI 对话近年来一直保持很高的热度,学术界和工业界在问答、任务完成、开放域聊天等各个子领域都展开了很深入的研究、也推出了形形色色的产品。但是 AI+AI 对话,仅仅在对话系统评测领域有过少量的应用。
本次演讲结合实际C端产品落地的经验,阐述 AI+AI 对话,尤其是 AI+AI 语音对谈技术,可在游戏、社交、陪护等场景对普通用户提供额外的价值。并分别从自然语言处理、语音合成、全双工语音对话等几个技术角度、分析 AI 对谈系统在技术实践上与人机对话系统的异同之处。
演讲提纲:
- 什么是 AI+AI 语音对谈技术?
- AI 对谈技术的应用场景
- AI 对谈落地的 NLP 技术
- AI 对谈落地的语音合成技术
- AI 对谈与全双工人机对话技术的结合
你将获得:
- 小冰在 AI 对谈方向探索的经验,为人工智能产品设计提供新的思路和视角。
- 通过介绍 AI 对谈的技术实践经验,为研发人员的研发路线制定和技术选型决策提供参考
by 陈云琳
出门问问
资深语音工程师近些年来,随着深度学习的快速发展,端到端(End-to-End)语音合成得到了广泛的关注和研究。传统的语音合成声学模型训练的流程复杂,包括 label 设计、问题集设计、HMM-GMM 训练以及决策树聚类等一系列流程。而端到端的声学模型直接使用单一的深度神经网络模型进行建模,极大的降低了模型的复杂度。另一方面,基于神经网络的声码器(Vocoder)在性能上也逐渐超越基于信号理论的传统声码器。端到端声学模型和神经网络 Vocoder 虽然能够合成非常高质量的声音,却面临着计算开销大和使用成本高的问题。如何解决这些难题,有效地将这一系列新技术落地,是语音合成从业者当前面临的最大挑战。
本报告将介绍出门问问近期在端到端语音合成系统上取得的研发成果以及在语音合成技术产品化和 ToB 行业落地的经验。
演讲提纲:
- 语音合成概述
- 出门问问语音合成发展历程
- 出门问问语音合成技术概要
- 出门问问语音合成应用产品
- 出门问问技术最新进展
- MeetVoice 端到端系统介绍
- MeetParameter - 端到端合成框架介绍
- MeetVocoder - 神经网络 Vocoder 框架介绍
- 小数据量端到端语音合成的挑战与解决方案
- 端到端系统的最新研究
- MeetVC
- Speech-to-Sing
- Avatar
- 出门问问语音合成行业实践
- 智能语音播报:车载语音助手
- 配音产品:魔音工坊,赋能音视频创作者
- 声音克隆:个性化定制声音
- 展望与总结
听众受益:
- 了解并探讨出门问问语音合成技术最新进展及方向;
- 了解 TTS ToB 的技术难点和技术方案。
by 王玉平
字节跳动
产品研发和工程架构部算法专家近年来,随着深度学习和人工智能的发展,基于神经网络的 TTS 技术显著提高了合成语音的质量,为了解决实际产品中对语音合成的效果和效率的要求,我们研发了基于神经网络的语音合成系统,包括前端、声学模型和高性能声码器,能极大提升语音合成的效果,并且能保持非常高的效率;同时,为了探索语音合成在娱乐场景下的新玩法,我们也在研究说话人在只有少量数据的情况下,可以合成说话人音色的流利的其他语言的语音,也可以让说话人以说或者唱的形式来进行自由的表达。
本次演讲将介绍字节跳动语音合成团队在语音合成技术与字节跳动平台相结合的一些探索。
演讲提纲:
- 语音合成综述
- 语音合成的历史
- 语音合成的关键模块
- 语音合成相关课题
- 字节跳动语音合成系统介绍
- 语音合成:前端、声学模型、声码器
- 语音转换
- 音色克隆
- 语音合成与平台结合的案例
- 创作工具
- 视频配音
- 未来展望
你将获得:
- 了解字节跳动语音合成团队的技术进展
- 了解语音合成技术在字节跳动的应用场景
by 李杰 博士
快手
资深语音算法专家智能语音技术在快手具有丰富的应用场景,一方面要对每天快手用户产生的海量语音数据进行内容分析,为接下来的信息安全、内容理解、广告与推荐等提供基础服务。另一方面,要赋能快手的众多产品,提升用户与产品交互的便利性和趣味性。大量多样化的场景和海量数据对语音识别的精度与效率提出了重大挑战。近年来,端到端语音识别技术以其框架简洁、高精度、高效率的优势,成为领域研究热点,短短几年经历了多次技术更新与迭代。
关注主办方(InfoQ)
联系我们
交通指南
北京·悠唐皇冠假日酒店
地址:北京市朝阳区三丰北里3号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质
电话咨询
联系电话:+86 13269078023
在报名过程中如有任何问题,欢迎微信扫描二维码联系我们的票务经理