Agent 在演示环境中完成一次任务,并不意味着它能够在生产环境中持续可靠地工作... 展开 >
智能体评测与生产可靠性探索
会议室:待定出品人:陈舒
- Topic 1
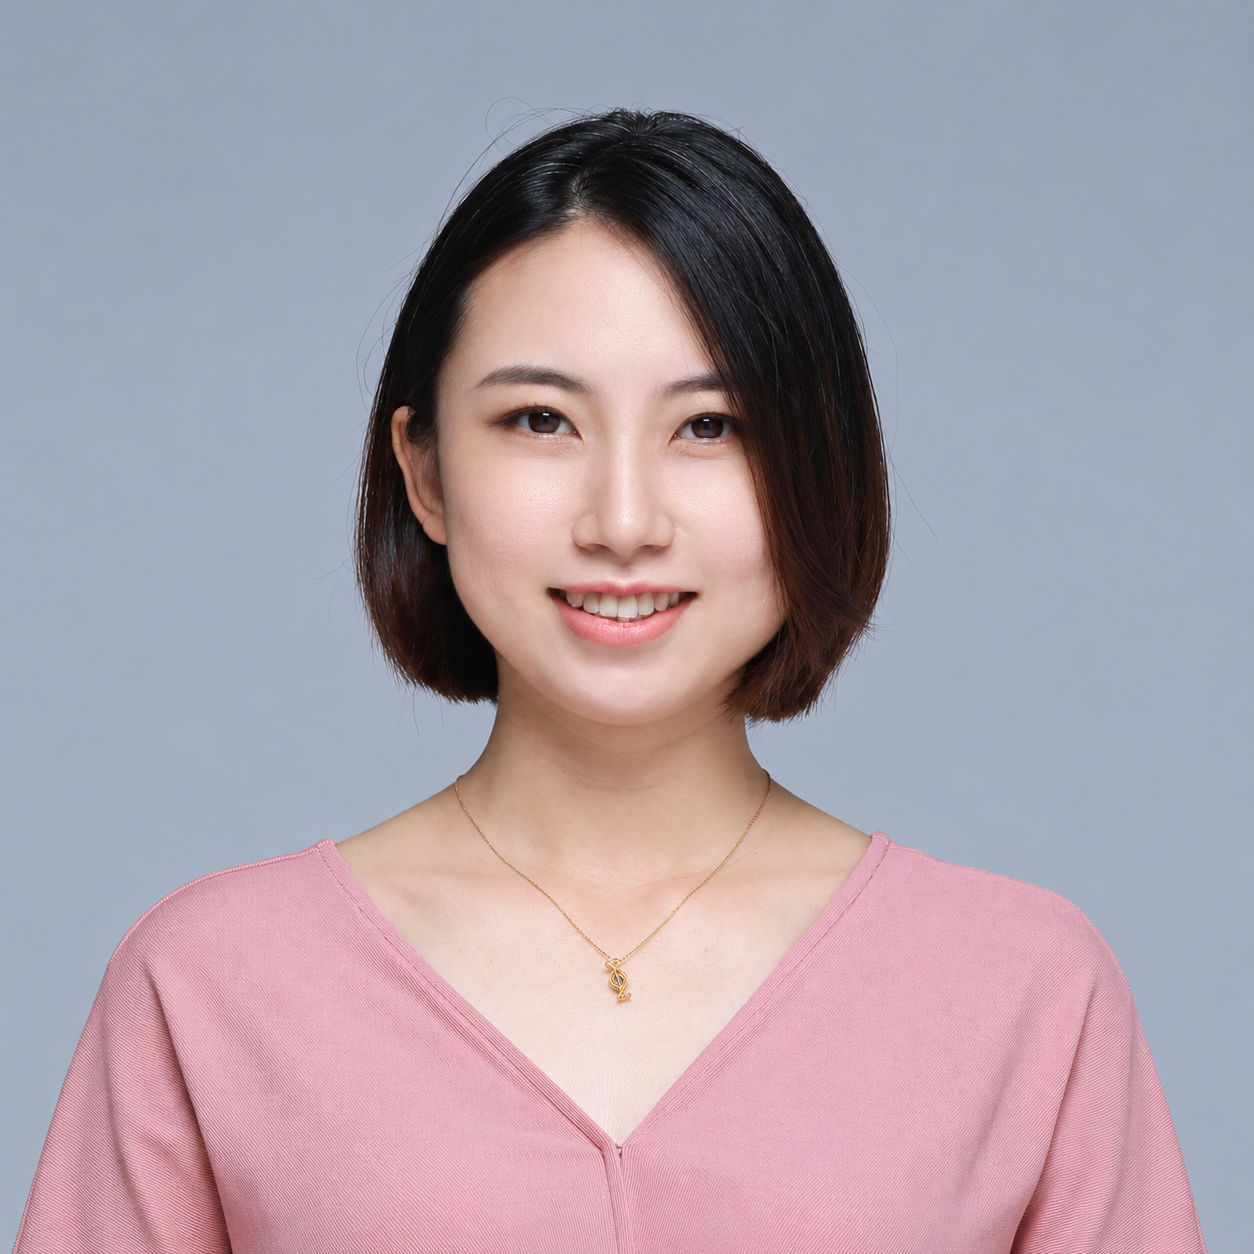
王芷
微软 高级解决方案工程师 - Topic 2
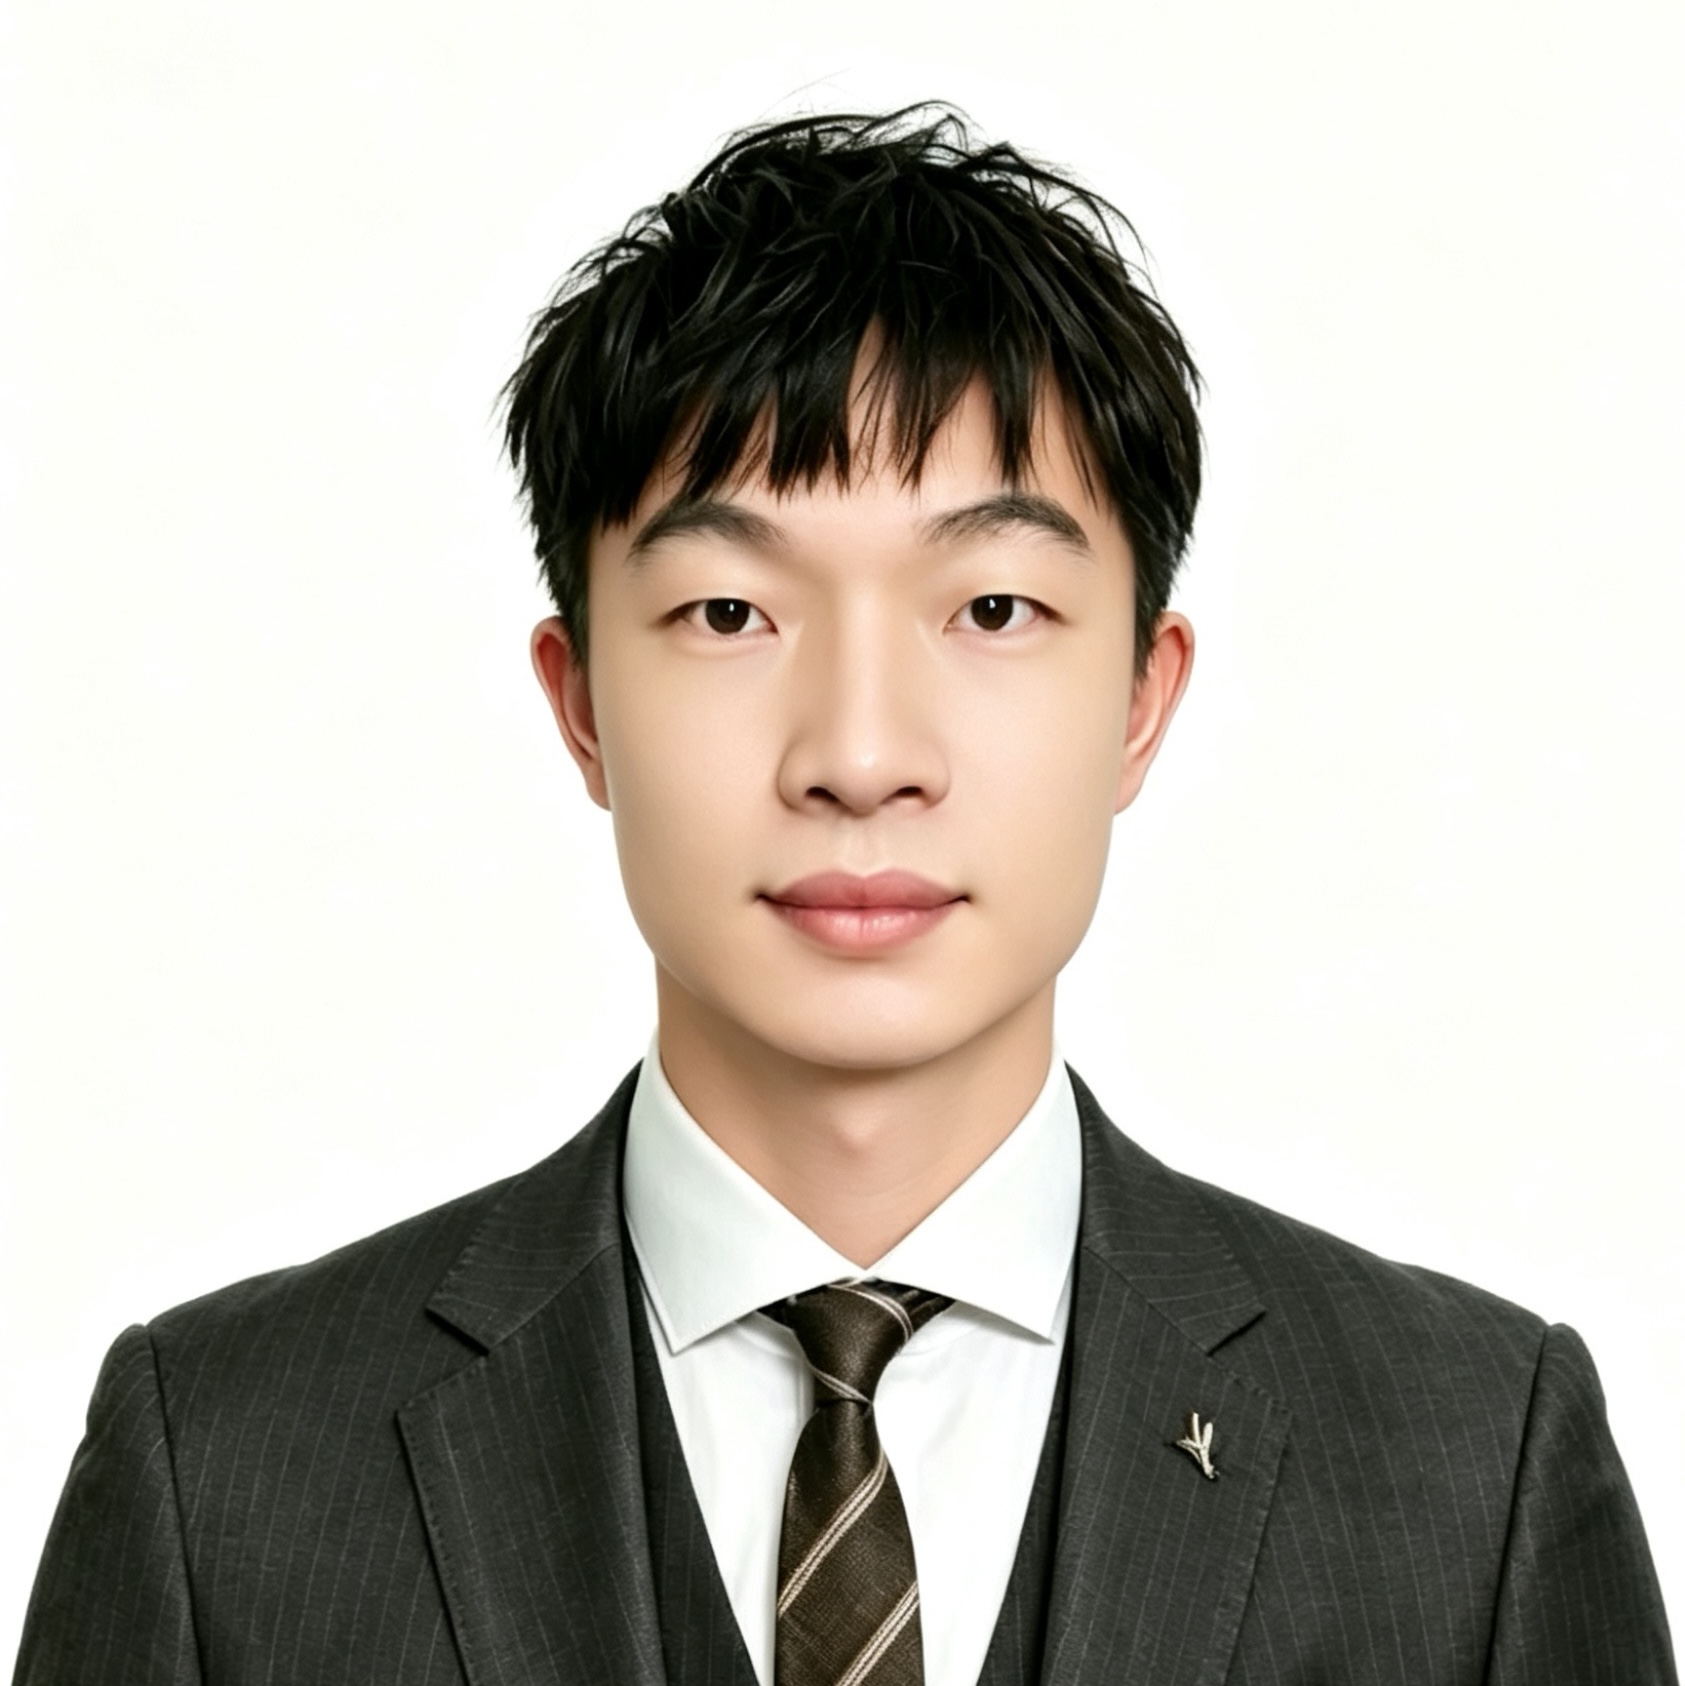
丁湘
快手 测试开发专家
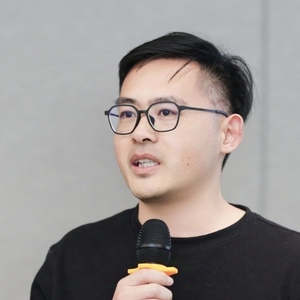
专题出品人:陈舒
飞猪资深技术专家
拥有丰富的大型互联网电商及金融科技行业经验,深耕高可靠、高稳定系统的质量保障体系十多年。曾历任淘宝会员、淘宝店铺、淘宝商品等核心业务,以及智能互联事业部技术质量负责人。近年来,紧跟技术前沿,在AI系统评测领域积累了深厚的实战经验,致力于探索智能化时代AI Native的质量保障新范式。
专题:智能体评测与生产可靠性探索
Agent 在演示环境中完成一次任务,并不意味着它能够在生产环境中持续可靠地工作。本专题聚焦智能体评测与生产可靠性,讨论如何定义任务成功、构建真实业务评测集,并通过 Tracing、Replay、回归测试和质量 SLO 持续发现系统退化。同时关注长任务中断、重复执行、状态污染、工具失效、人工接管、故障恢复与业务补偿,探索如何建立覆盖测试、运行、监控和事故响应的 Agent 可靠性工程体系。
by 王芷
微软
高级解决方案工程师当 Agent 从 Demo 走向真实业务场景,挑战也从“能不能跑起来”逐渐转变为“如何知道它运行得好不好,以及如何持续优化”。
本次分享将围绕 Agent 的 Observability、Evaluation 和 Optimization 展开,从一次 Agent 请求的完整执行链路出发,介绍如何通过 Trace 和运行数据定位 Agent 的问题,如何构建可量化、可重复的评估体系,并进一步从 Prompt、Model、Tool 和 Workflow 等维度持续优化 Agent。
演讲提纲
- Agent 上线之后,真正的挑战才刚开始
- 为什么 Agent 在 Demo 中表现很好,真实场景却可能不稳定
- 面对复杂 Agent Workflow,如何判断问题出在 Model、Prompt、Tool 还是执行链路
- Observe:让 Agent 的运行过程真正可见
- Trace 一次完整的 Agent Execution
- 观察模型推理、Tool Calling、Latency、Token 等关键运行信息
- 从 Trace 中快速定位异常行为和失败路径
- Evaluate:从“感觉不错”走向量化评估
- 建立 Evaluation Dataset 和评估基线
- 从回答质量、任务完成度、工具调用等维度评估 Agent
- 让不同 Prompt、模型和 Agent 版本之间可以量化比较
- Optimize:让数据真正驱动 Agent 优化
- 根据 Trace 和 Evaluation 结果定位优化方向
- 从 Prompt、Model、Tool 和 Workflow 多层面优化
- 综合考虑 Quality、Latency 和 Cost,而不仅仅追求模型效果
听众收益
- 理解为什么生产级 Agent 需要 Observability、Evaluation 和 Optimization
- 掌握通过 Trace 定位 Agent 问题的基本方法
- 理解如何构建 Evaluation Dataset、Evaluator 和评估基线
- 学会从 Prompt、Model、Tool 和 Workflow 等不同层面优化 Agent
- 理解如何在 Quality、Latency 和 Cost 之间进行数据驱动的优化决策
by 丁湘
快手
测试开发专家随着 LLM 在广告私信智能客服规模化落地,评测与生产治理面临多重考验:端到端评测只能判定"结果错",定位不了具体环节;固定评测集评测,模拟不了线上真实多轮对话场景;AI 裁判员人机一致率低,调优成本高;测试环境效果达标,生产环境却不稳定。
本次分享探讨如何构建贯穿评测与生产治理的双闭环体系:通过过程节点埋点结合全链路Trace,基于角色驱动的仿真对话多轮推理评测,以自进化流水线迭代评测规则持续调优裁判员判断依据,压测结合监控巡检保障生产稳定性,最终实现评测与生产治理各自闭合成环,智能客服从"只知道结果错"走向"知道错在哪、兜得住线上"的确定性保障。
演讲提纲
- 广告私信智能客服的评测与治理挑战
- 端到端无法定位归因
- 测试环境评测与线上真实效果脱节
- AI 裁判员人机一致率低、调优成本高
- 测试环境达标不等于生产环境稳定
- 评测治理体系的架构设计与双闭环
- 评测可信链与生产可靠性治理链协同
- 评测体系迭代与生产治理迭代双闭环
- 评测可信链:评测体系构建、可信验证与质量准出
- 评测标准:区分度、稳定性与泛化性验证
- 评测数据集:多源数据供给与仿真用户多轮评测
- 评测对象:端到端与过程环节双轨评测
- 评测裁判员调优:评测规则自进化流水线
- 质量准出门禁:指标阈值判定与人工豁免机制
- 生产可靠性治理链:变更管控、分级保护与闭环改进
- 变更管控与候选版本实施
- 发布前双门禁
- AB 灰度上线
- 在线巡检与归因
- 异常保护与容灾恢复
- 回归改进
- 工程落地与量化收益
- 发布流程嵌入
- 评测侧收益:智能客服 badcase 率从 35% 降至 5%
- 生产治理侧收益:线上处置时效从 30 分钟缩短至 5 分钟,2026 年巡检累计拦截 20 万+ badcase
听众收益
- 一套把评测结果转化为发布决策的工程方法:学习如何将评测分数、Badcase 分类和严重等级等指标转化为可执行的质量准出阈值,设计“默认阻断→工程/算法修复→重走评测→人工豁免留痕”机制,避免评测只产出报告、却没有真正约束发布
- 一条从变更到线上稳定运行的生产可靠性治理路线:掌握“变更管控→测试环境候选版本→发布前双门禁→A/B 灰度→在线巡检与归因→异常保护与容灾恢复→回归改进”的完整链路,可用于盘点团队现状并规划质量与稳定性建设优先级
- 一套 AI 辅助、但保留人工边界的持续迭代实践:学习如何将线上 Badcase、故障归因和处置事件回流为评测集、评测规则和巡检规则;由 AI 辅助规则比对、根因诊断和优化方案生成,同时保留人工门禁、异常豁免和回滚决策,避免自动化失控
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手