企业知识并不只是文档和数据的集合,更需要对产品、客户、指标、流程、规则及其关系形... 展开 >
Knowledge Engineering|让 Agent 理解企业
会议室:待定出品人:盛茂家
- Topic 1
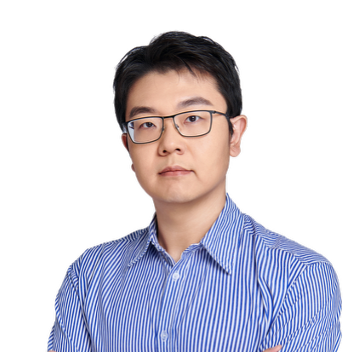
孟嘉
悦点科技 CTO - Topic 2
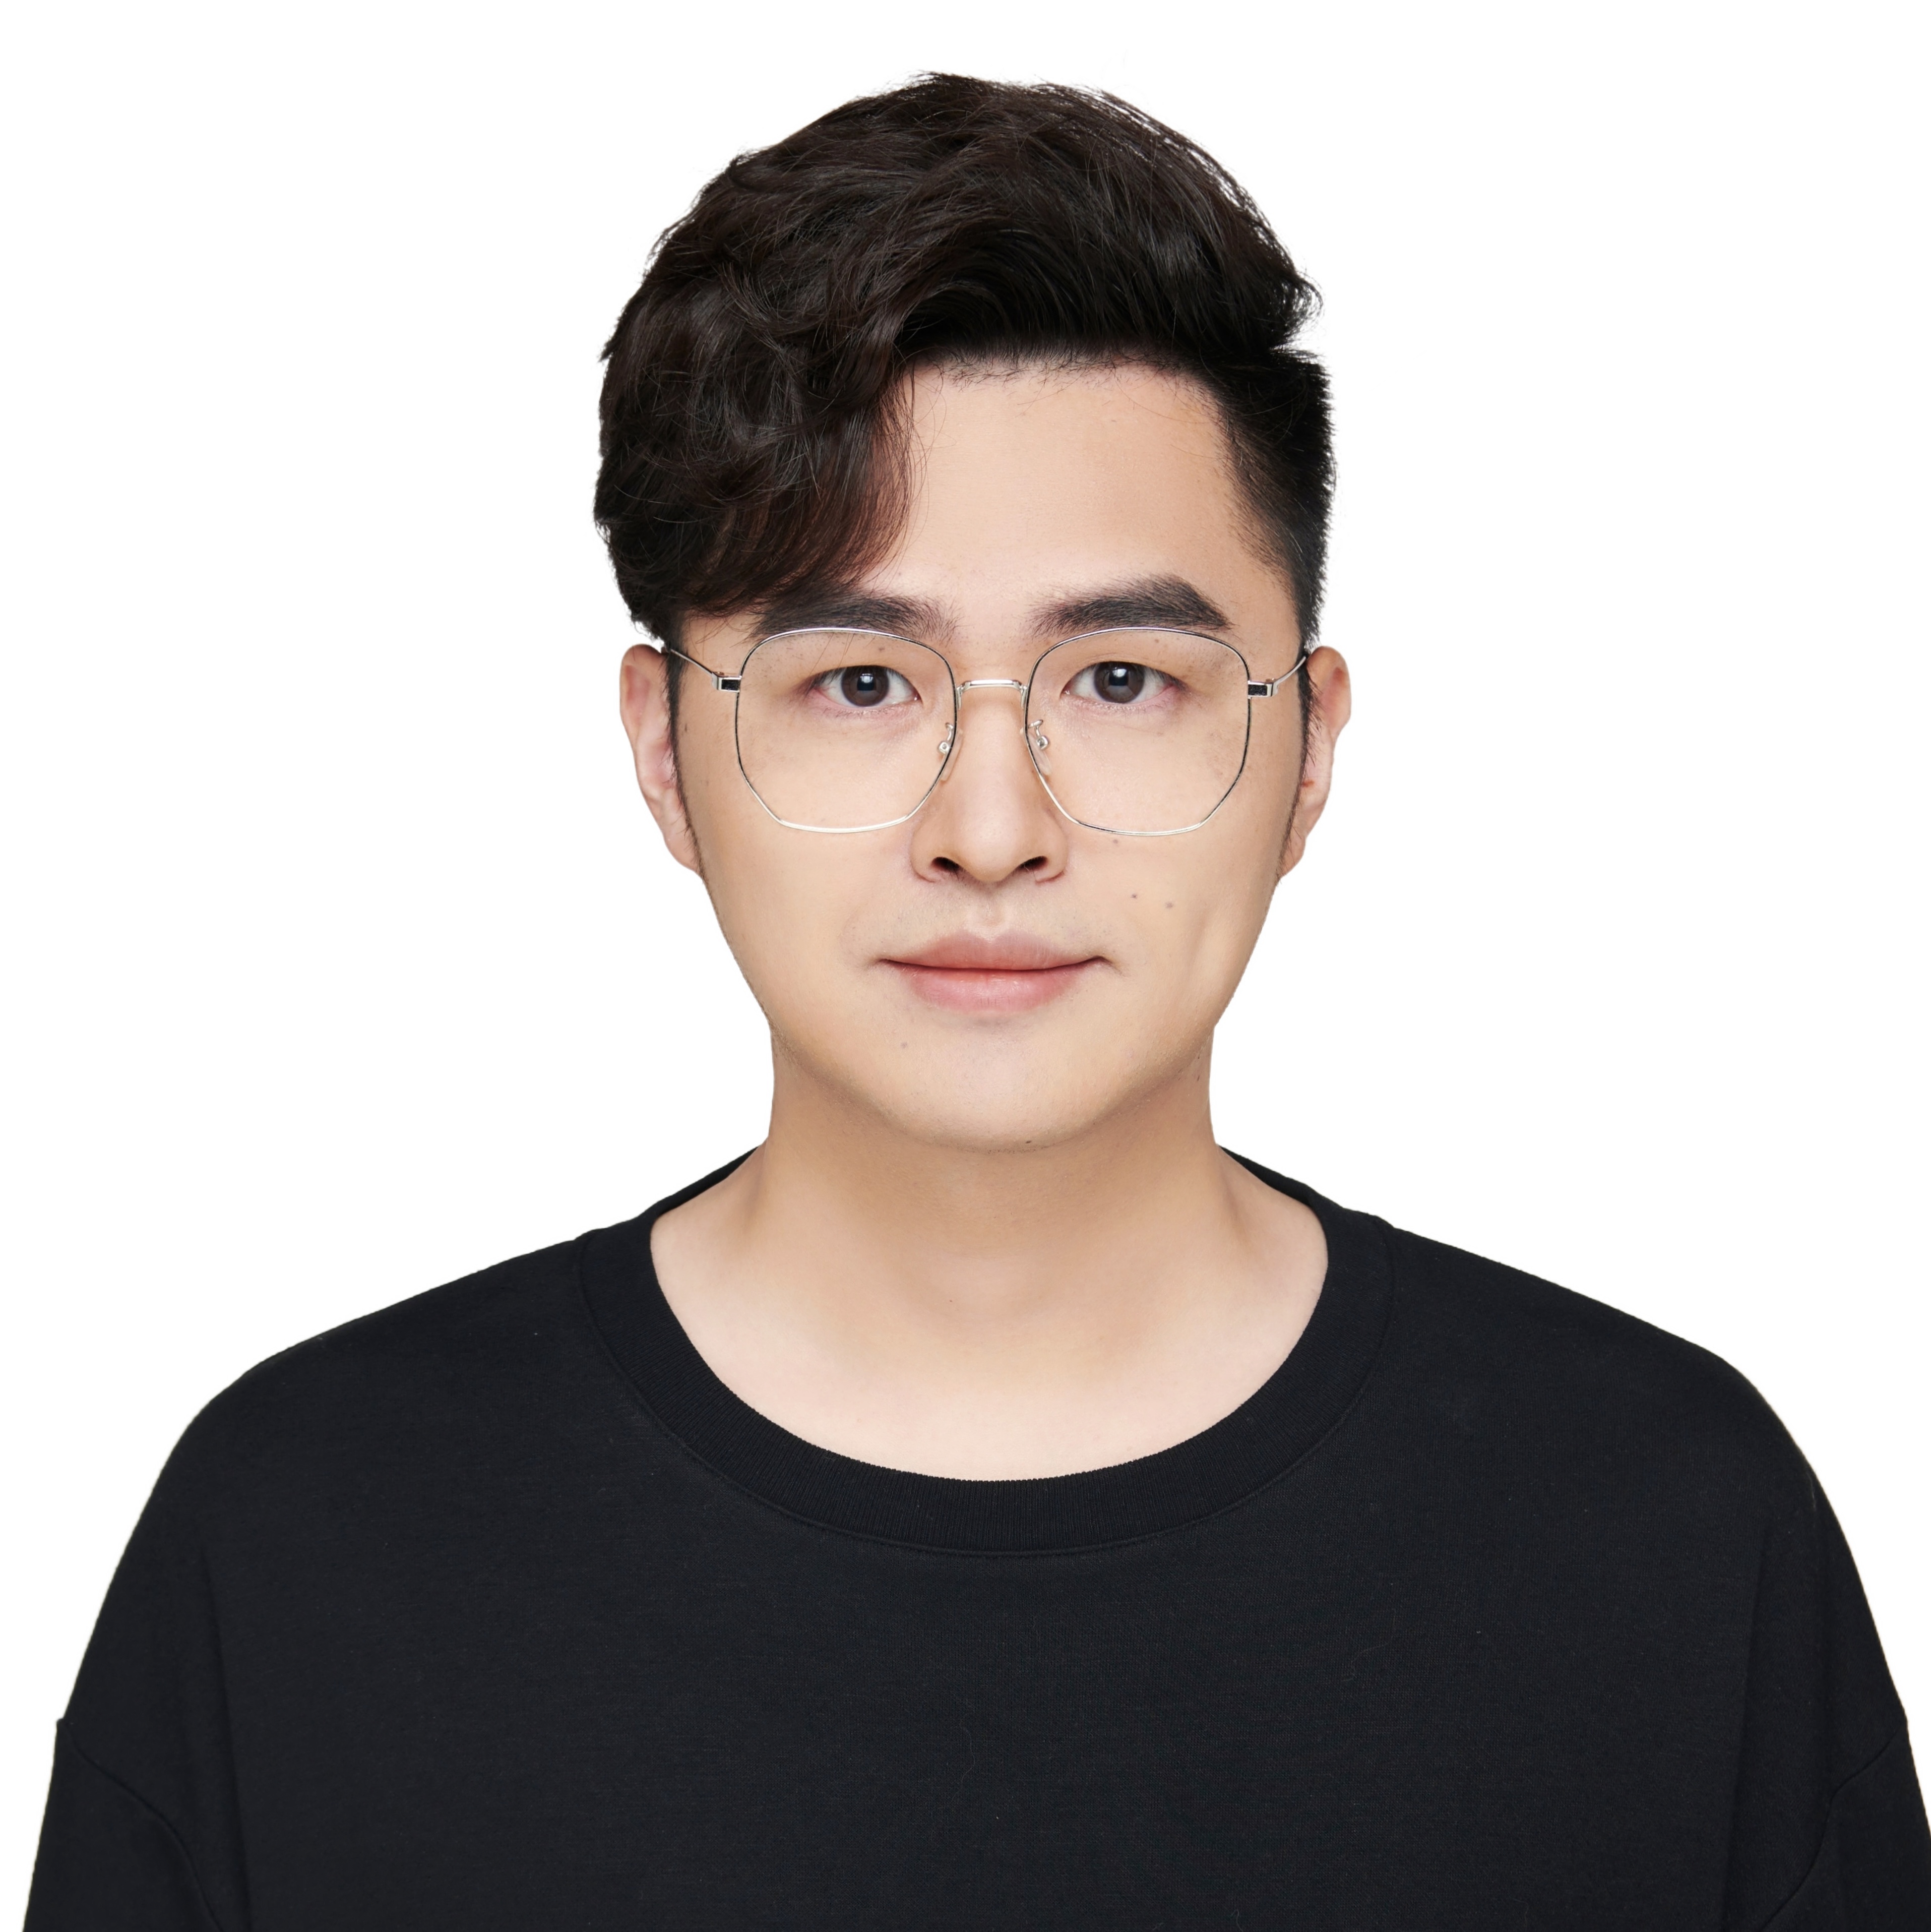
夏温武
阿里巴巴 技术专家 - Topic 3
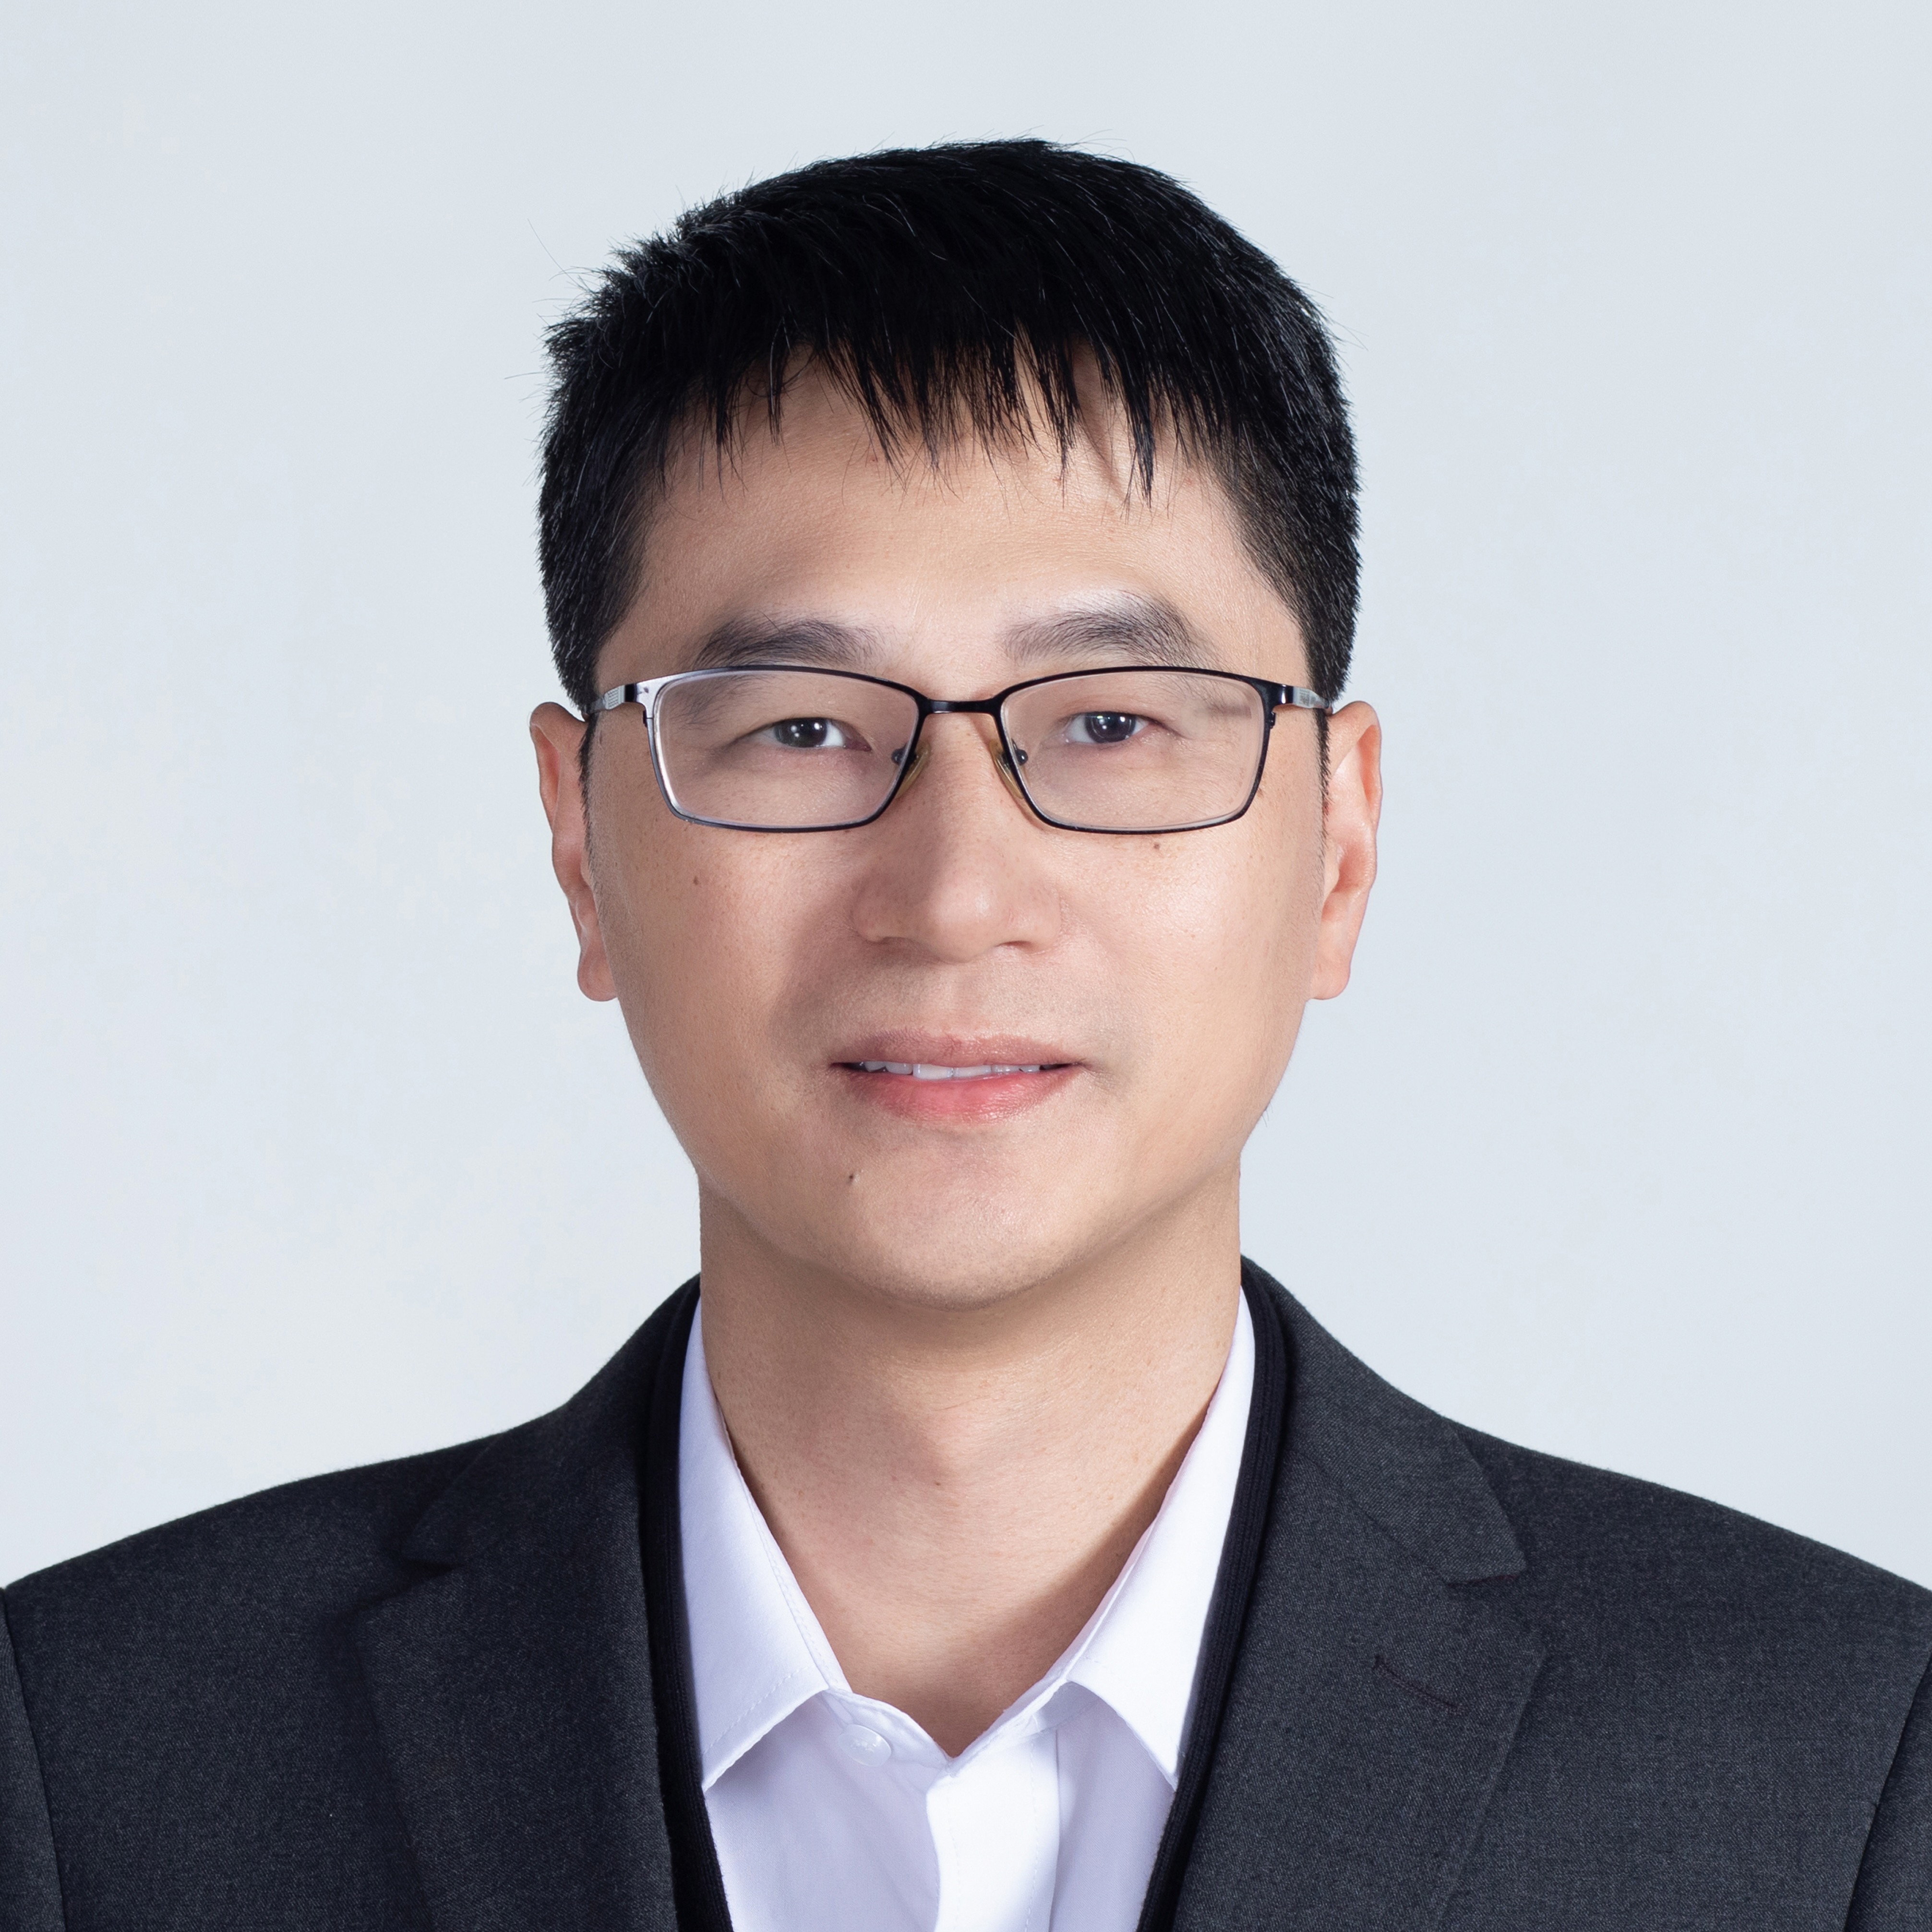
刘勇
中能拾贝科技 创始人兼CTO - Topic 4
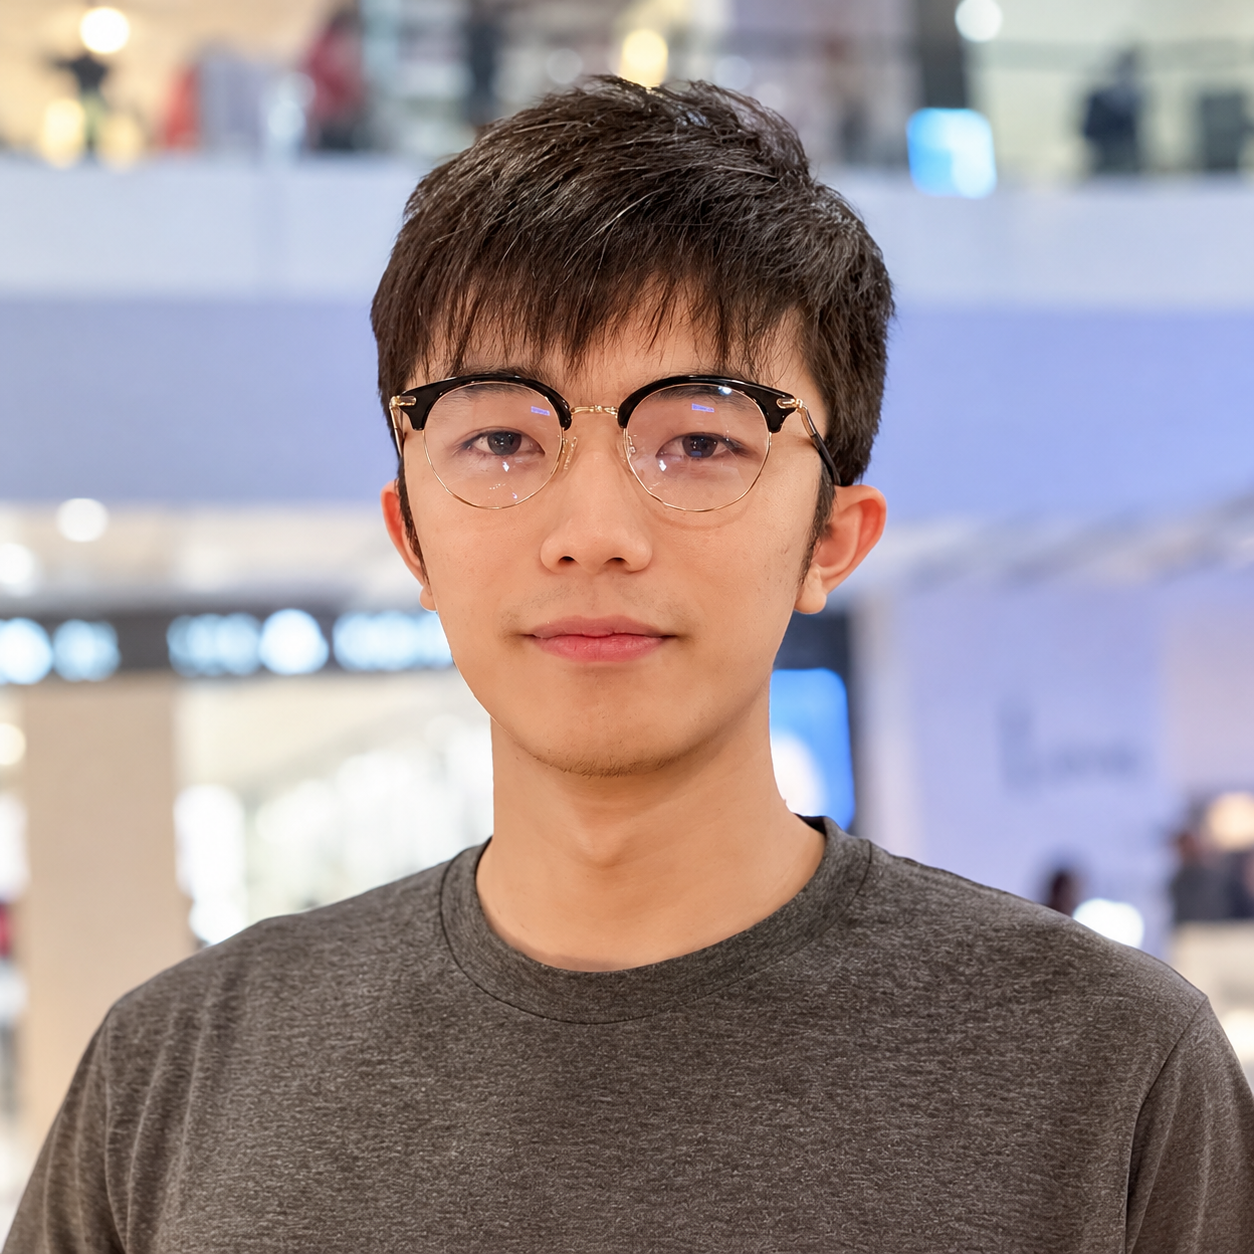
刘智恒
火山引擎 OpenViking 生态负责人 - Topic 5
汪政
携程旅行 商旅 CIO
专题出品人:盛茂家
火山引擎Viking 团队技术负责人
毕业于清华大学电子工程系,先后就职于网易游戏和字节跳动公司,现为火山引擎 Viking 团队技术负责人。作为 VikingDB 向量数据库、Viking 知识库等公有云产品的技术负责人,在非结构化信息索引、高性能检索领域有较丰富的工程研发经验,重点关注 AI Agentic 非结构化信息检索领域。2026 年作为技术发起人创建 OpenViking 上下文数据库开源社区,为知识和记忆问题的解决提供了全新思路。
专题:Knowledge Engineering|让 Agent 理解企业
企业知识并不只是文档和数据的集合,更需要对产品、客户、指标、流程、规则及其关系形成统一表达。本专题重点关注 Ontology 与 Semantic Layer 如何建立企业业务语义,知识图谱如何组织对象与关系,以及多模态知识解析、RAG 与 GraphRAG、Context Engineering、长期记忆和知识治理如何共同为 Agent 提供准确、实时、可追溯且可执行的业务上下文。同时探讨企业知识如何持续更新、授权和评估,让 Agent 不仅能够检索信息,还能够理解业务概念、约束条件与行动边界。
by 孟嘉
悦点科技
CTO企业 AI 用不好 AI 根源不是模型不够强,而是企业知识缺结构、缺约束,AI 需要可靠可信地迭代。本次演讲以「从约束到进化」为主线,讲清 如何利用 Ontology 技术补上这一环。
全篇分四部分:先「重新认识 Ontology」,讲清它是什么、为何在大模型时代回归,如何利用它增强模型的可信与推理能力;再讲「Ontology 的角色与企业知识进化」,说明它如何统一语义、约束推理,让企业知识在专家与一线之间持续流转、越用越强;进而展开「基于本体的 Harness → Loop → Evolve 技术迭代」,展示 AI 如何从收束复杂、闭环执行,走向自我进化;最后以「企业落地案例与分析」,结合制造、能源、轨道交通等真实场景,给出可复用的落地路径。
演讲提纲
1. AI 时代下重新认识 Ontology
2. Ontology 与企业知识进化
3. Ontology-Enhanced Agentic AI 与 RSI 的技术路线探索
4. 企业案例与实践
听众收益
- 认知升级——掌握「连接主义 + 符号主义」这套判断框架
- 方法落地— 落地路径,回去就能动手;、
- 案例信心——通过真实成效,明确自己企业如果想做基于Ontology的AI建设该从哪里起步、大致能带来多少回报
by 夏温武
阿里巴巴
技术专家企业需求从产品、设计流转到研发,常常需要反复确认交互细节和业务规则。设计稿能表达页面样式,却未必能完整说明这些要求;已有的规范、组件和模板,也不容易被准确找到和使用。Agent 参与设计后,同样需要理解这些业务知识,才能生成符合要求的结果。
本次分享将结合淘天 TaoDesign 的实践,讨论设计 Agent 的产品与架构选择、业务知识的组织和使用,以及设计资产与修复经验的蒸馏方法。重点介绍如何让 Agent 在生成和修改时用对规范与模板,如何将任务中的修复经验整理为后续可用的知识,以及如何通过人工复核和回归评测判断这些改进是否有效。
演讲提纲
- 企业需求交付的挑战:设计环节为何反复澄清与返工
- 需求尚未想清楚就开始做稿、已有设计资产难以复用、交互逻辑在交接时遗漏,都可能让问题拖到研发阶段才被发现。讨论这些问题在设计环节的具体表现,以及如何借助可交互设计稿、业务规范和结构化标注,更早确认需求,传递设计知识
- TaoDesign:面向设计领域的产品与 Agent 设计
- 围绕设计师和产品人员生成、修改及交付设计稿的工作过程,介绍 TaoDesign 的产品设计与端—云—沙箱架构。重点讨论哪些操作适合直接修改源码,哪些需要 Agent 处理,以及业务知识如何参与生成、编辑和研发交接
- 知识组织与使用:让 Agent 用对规范、模板和素材
- 设计规范、组件、模板和素材如何组织,Agent 才能找到适合当前任务的内容?结合资源检索、知识摘要和按需读取的实现,介绍如何精简输入,同时保留必须遵守的规则;通过风格约束和模板复用,减少选错资源、漏读规范和重复生成的问题
- 资产与经验蒸馏:将存量材料和执行经验转化为知识
- 结合两类材料介绍知识蒸馏的做法:一类是已有设计稿、规范和业务文档,用于整理风格、模板与使用规则;另一类是生成和修复记录,用于总结问题原因、修改方法及适用条件。讨论如何蒸馏总结多个案例并形成通用规则
- 评测驱动的自进化:用任务反馈改进知识
- 介绍 TaoDesign 如何收集真实任务中的问题,通过评测分析原因,将有效修复经验经人工复核后更新到知识库,供后续任务使用。再通过版本回归检查原问题是否解决、其他场景是否受到影响,让知识更新有依据,改进效果可验证
听众收益
- 了解设计 Agent 的产品与架构选择,以及业务知识如何参与设计和交付
- 学习设计规范、模板与素材的组织和检索方法,以及从设计材料、修复记录中提取可复用知识的做法
- 了解如何结合任务反馈、人工复核和回归评测更新知识,判断改进是否有效、是否影响其他场景
by 刘勇
中能拾贝科技
创始人兼CTO工业OT场景具备高实时性、高可靠性、强物理约束、低容错率的核心特性,通用大模型天然存在的内容幻觉、逻辑不可控、执行失控等问题,成为其规模化落地工业现场的核心技术壁垒。通用大模型的概率生成特性,无法适配工业设备运行、工况调度、故障处置等场景的物理规律与安全底线,极易出现认知偏差、决策失准、执行越界等风险,导致大模型技术长期难以深度落地工业核心生产场景。
本次技术分享聚焦工业OT侧大模型落地的核心技术难题,深度拆解中能拾贝CyberwIIOS工业智能操作系统的底层技术破局逻辑,核心通过三套自研闭环技术机制,解决大模型“幻觉干扰、执行失控、协同低效”三大行业痛点,实现大模型通用能力与工业OT场景确定性需求的深度适配,让大模型的泛化能力、认知能力可落地、可管控、可量产。本次分享核心拆解三大底层技术机制,全程聚焦技术原理与落地逻辑:一是“治幻觉”,通过工业模型多级水合与知识锚定,将概率生成收敛为符合物理规律的确定性认知;二是“防失控”,依托安全护栏与数字孪生沙箱预演,构筑刚性的受控执行底线;三是“强协同”,利用智能编排引擎实现多智能体高效编排。IIOS以系统级底座护航,将大模型的“聪明”安全转化为工业现场的“确定性”生产力。
演讲提纲
- 【痛点剖析】解析OT场景物理约束与通用大模型概率生成的“技术断裂带”
- 提出核心命题:大模型的“聪明”必须被系统级架构所“收敛”,否则无法跨越OT侧的容错红线
- 【治幻觉】详解 CyberwIIOS 的工业模型引擎(IME)
- 分享如何通过本体映射与多模态多级水合技术,将物理机理与专家规则深度注入大模型,将大模型的发散性输出,硬性收敛至符合物理定律与工业规范的安全区间内。
- 【防失控】解读工业逻辑与安全引擎(ILS)的拦截机制
- 阐述智能体指令如何通过逻辑锁、物理盾、时空锚等维度,执行 T1-T3 极速合规校验
- 【强协同】介绍 CyberwIIOS 的智能编排引擎(COE)
- 分享如何通过意图治理、任务治理、资源治理,解决工业现场数百个Agent在并发任务下的依赖冲突、死循环与资源死锁,实现高效、无冲突的群体智能
- 【架构升维】介绍工业大模型走向规模化量产的工程范式
- 输出一套将大模型从“Demo原型”转化为“工业级生产组件”,实现高可靠、高安全、可复制的全流程落地体系
听众收益
- 升维认知:深刻理解大模型在OT侧落地时,所面临的物理约束与概率生成之间的底层矛盾与系统性风险
- 架构视野:掌握“模型水合收敛幻觉”、“沙箱护栏拦截失控”、“编排引擎治理冲突”的系统级AI原生架构设计范式
- 硬核参考:获取大模型从“技术原型”迈向“工业核心生产线”,实现高可靠、高安全、规模化复制的工程实践指南与实战经验
by 刘智恒
火山引擎
OpenViking 生态负责人企业接入 Agent 后,最常见的问题不是模型答不出来,而是:找不到对的资料,找不全该遵守的规则,分不清哪些能看、哪些能做。文档、代码、Wiki、指标和经验散落在不同系统里。向量检索只能捞回相似片段,Agent 拿不到业务概念、约束和行动边界。
本次分享字节开源的 40k+ 星上下文数据库 OpenViking,讲从企业资料到 Agent 可用上下文的完整链路:
-
用 viking:// 目录树,给知识、记忆、技能、规则和实时数据一个统一地址
-
用 L0/L1/L2 分层和目录递归检索,替代平铺切片
-
用上下文编译,把原始资料持续加工成业务知识
-
把规则作为独立的上下文类型,保证该遵守的一条不漏
-
用目录级 ACL 在检索阶段完成授权隔离
-
用长期记忆和 Handoff,让经验跨会话、跨人、跨 Agent 沉淀
分享会结合财经业务知识库、推荐团队、Issue Fix Bot 等真实场景,给出数据和踩坑经验。
演讲提纲
- 为什么 Agent 用不好企业知识:缺的是上下文,不是模型
- Context Database:给企业知识一个 Agent 能读的统一地址
- 从资料到知识:分层理解、上下文编译与规则约束
- 让知识可授权、可实时、可持续进化
- 落地案例与路径:从一个场景的一棵目录树开始
听众收益
- 判断框架:分清 RAG、知识图谱、记忆、上下文工程各自解决什么问题,知道自己企业缺的是哪一层
- 方法落地:一条"接入 → 理解 → 编译 → 规则 → 授权 → 记忆"的路径,回去可以从一个场景开始搭
- 开源工具:OpenViking 开源版可以直接试用,且支持一件启动的云服务和可试用的企业私有化版本
by 汪政
携程旅行
商旅 CIO企业差旅 Agent 的难点不只是检索文档,而是同时理解员工偏好、企业差标、审批条件与实时可订资源。本演讲以携程商旅AgentONE 架构探索为例,介绍如何将业务对象与关系、文档检索和实时工具组合为可执行上下文,使用知识图谱 按城市召回偏好,以共享State融合上下文信息,并由系统注入企业身份,支持多路受控路由,偏好通过单次聚合图查询获取资源,结合交通衔接规则校验,错误触发候选池复用与定向重试。分享从知识问答走向有依据、受约束的差旅推荐的实现路径,以及模拟原型与业务集成之间的工程鸿沟。
演讲提纲
- 为什么“检索正确”仍然不等于“理解企业”?
- 以差旅出行为贯穿案例,拆解四类信息:文档知识、业务关系、实时事实、当前任务约束
- 提出核心方法:文档用于解释,图谱表达关系,工具获取实时事实,代码校验业务约束。
- 先建业务语义契约,而不是先建一张“大而全”的知识图谱
- 从具体任务反推最小业务对象和关系
- 区分“偏好”和“许可”
- 差旅场景下的语义构建细节
- 选型边界:领域对象与接口契约如何承担业务语义表达
- 偏好图谱如何做到“召回相关”,而不是“召回更多”
- Context Engineering:把“这次想要什么”与“长期喜欢什么”分开
- 从合理的方案到有真实依据的方案
- 如何验收“理解企业”:证据、指标与落地边界
听众收益
- 获得可迁移的企业知识分层与选型方法,能判断哪些知识适合文档检索,哪些关系应进入图谱,哪些事实必须实时查询,哪些约束应由业务服务和代码执行,避免用单一 RAG 方案包办所有问题
- 掌握任务驱动的上下文与记忆工程细节,建立从生成结果到业务验收的工程路径。 学会用真实候选池、资源编号和业务规则验证输出,并利用错误证据驱动定向修复;同时明确模拟原型、接口集成与生产成效之间的证据差距
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手