卡内基梅隆大学机器人学博士、清华大学计算机科学与技术博士。曾任平安集团美国研究院院长、Google 资深科学家及 NEC 实验室研究员,深耕计算机视觉、多模态AI、音视频理解等领域,拥有深厚的学术积累及丰富产业化经验。
讲师介绍
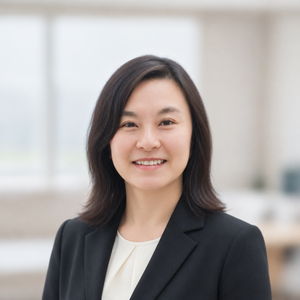
主题演讲嘉宾:韩枚
Clipto 首席科学家
议题介绍
演讲:数据不出端,记忆可调用:Agent 的长上下文从哪里来
大模型越来越会思考,却依然记不住用户。上下文窗口不断变长,但"能塞进去"不等于"记得住":真正有价值的个人与企业信息大量沉淀在会议、通话、视频等音视频中,体量巨大、高度敏感,既难以上云,也无法直接放进上下文。
本次演讲结合 Clipto 服务全球数千万用户的实践,探讨如何在端侧把多年的音视频转化为结构化、可检索、精确到时间码的长期记忆,并在需要时为 Agent 组装出精准的长上下文:数据不出端,记忆却可以通过 MCP 被各类 Agent 安全调用。我们将分享长期记忆与长上下文的分工、端侧多模态索引的工程取舍,以及记忆层在知识工作与企业场景中的落地。
演讲提纲
- 瓶颈正在转移:Agent 不缺推理,缺的是"记得住"
- 大模型推理能力快速趋同,差异化越来越来自对用户的了解。上下文窗口越来越长,但"能塞进去"不等于"记得住":窗口有成本与延迟上限,信息堆得越多,注意力越分散。Agent 需要的不是更大的窗口,而是一个能持续积累、按需调取的长期记忆层
- 长期记忆与长上下文的分工:记忆负责"存与找",上下文负责"用"
- 长期记忆把多年的会议、通话、视频沉淀为分层结构:原始文件 → 时间码片段 → 语义描述 → 实体与事件 → 摘要笔记。任务到来时,再从中检索并组装出精准、可引用的长上下文交给模型。讲清楚两者如何配合:什么该记、怎么检索、如何压缩、怎样保证回答能回溯到原始片段
- 为什么必须在端侧:数据不出端,记忆照样可用
- 音视频体量大、隐私敏感,上云面临带宽、成本与合规压力。分享端侧多模态索引的工程取舍,包括 ASR、视觉理解与向量化的模型组合,以及功耗、增量索引和跨端一致性
- 落地与展望:记忆是用户的资产
- 结合 Clipto 服务数千万用户的实践,覆盖创作者剪辑、知识工作者会议记忆,以及企业培训、客服录音和金融合规等"数据不出端"的场景。同时可以拓展为“共享”记忆:围绕核心事件、组织和家庭,把分散在多人、多设备上的音视频汇聚成一份共同记忆
听众收益
- 掌握构建 Agent 长期记忆的核心方法,让 Agent 从“单次对话”走向“持续理解用户”
- 理解端侧多模态记忆系统的工程实践,解决数据隐私与记忆可用性之间的矛盾
本专题下其他演讲
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手