大模型系统工程聚焦于构建支撑万亿参数模型的完整技术栈,涵盖从底层GPU/NPU集... 展开 >
大模型系统工程
会议室:秦宫出品人:李科
- Topic 1
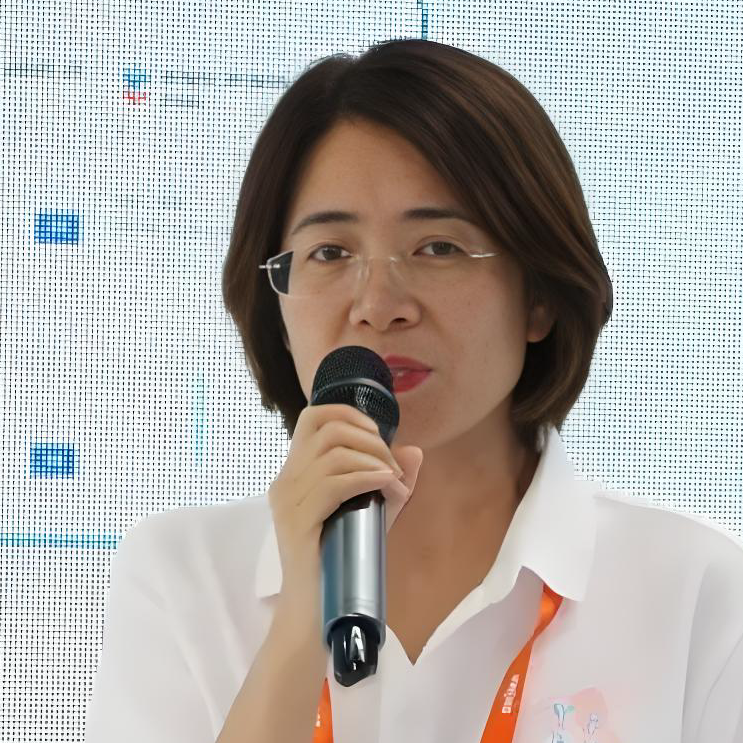
伏光莲
硅基流动 资深产品技术专家 - Topic 2
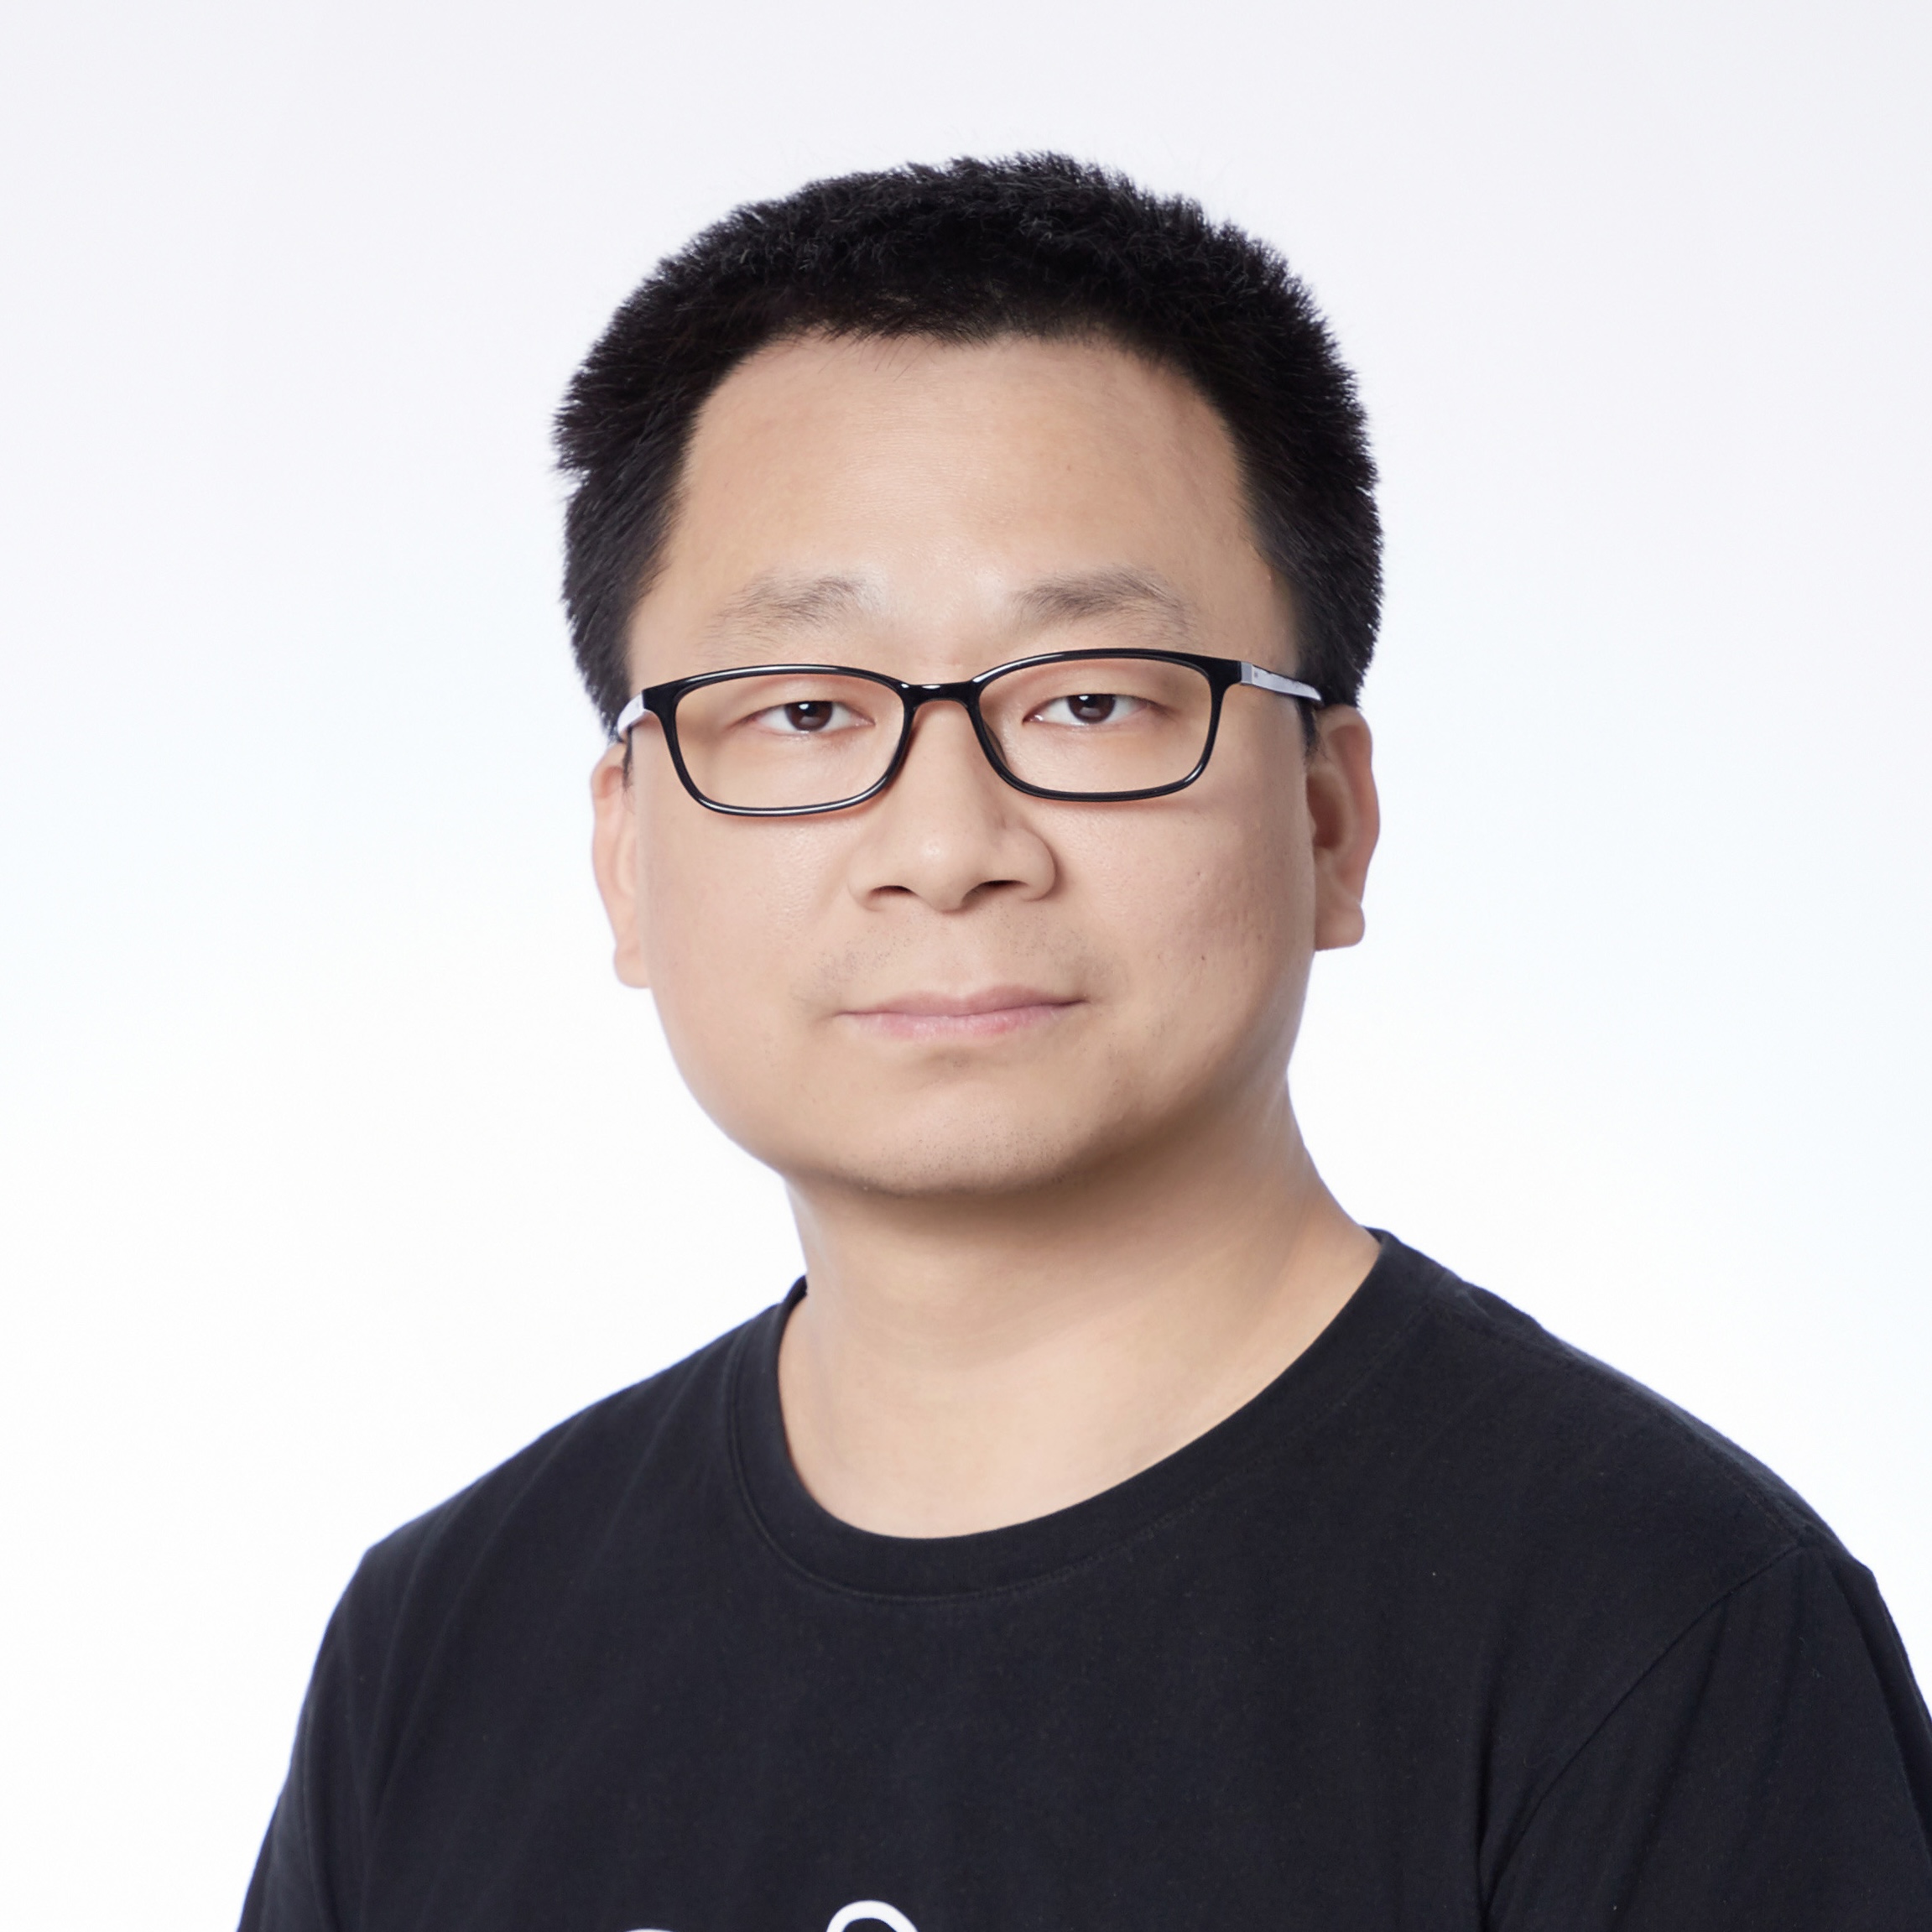
陈聪
蚂蚁集团 高级技术专家 - Topic 3
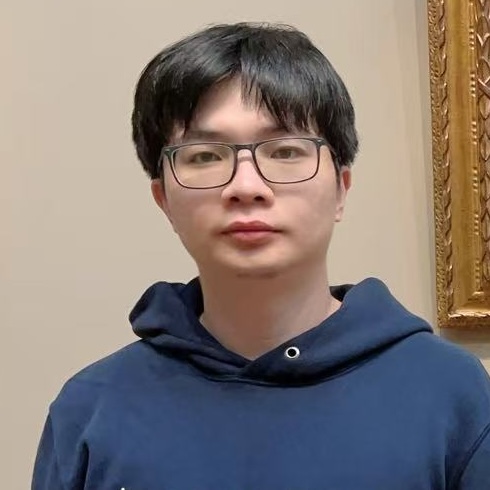
陈明杰
腾讯 专家工程师 - Topic 4
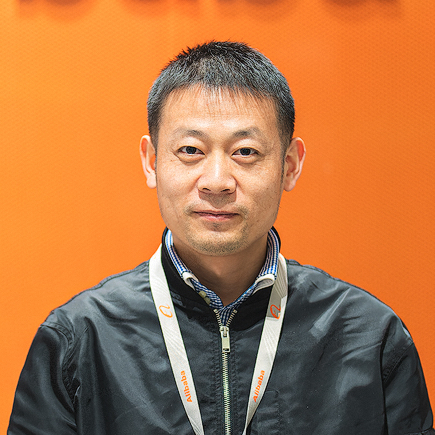
黄涛
阿里云 弹性计算 资深技术专家
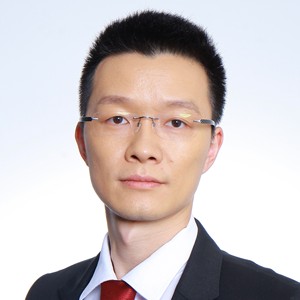
专题出品人:李科
腾讯云TI 平台产品中心总经理
深耕人工智能及互联网领域15年,现任腾讯云TI平台产品中心总经理,全面主导业界领先的一站式机器学习平台——腾讯云TI平台的产品研发与战略规划。
曾于腾讯顶尖AI实验室「腾讯优图」担任算法总监,主导人脸识别、听歌识曲等核心算法的研发与落地;并曾出任企业级SaaS产品「企点客服」的技术总监,负责技术架构设计与团队管理。长期致力于人工智能技术的研究与商业化应用,在计算机视觉、音频处理、GPU加速等领域拥有深厚的技术积累,相关成果成功应用于QQ、QQ空间、QQ音乐、微信等亿级用户产品中。
地点:秦宫
专题:大模型系统工程
大模型系统工程聚焦于构建支撑万亿参数模型的完整技术栈,涵盖从底层GPU/NPU集群、高速网络互联与优化,到分布式存储与数据流水线设计,再到训练框架深度调优、资源调度与集群管理,最终实现计算高效利用与成本控制。本专题系统解析大模型基础设施的各层级核心挑战与工程方案,为AI架构师、工程师及技术决策者提供构建高效、稳定智能计算平台的实践洞见。
by 伏光莲
硅基流动
资深产品技术专家企业 AI 应用正从验证走向规模化,基础设施需要系统性解决算力利用、训练/微调、部署/推理与治理等问题。本演讲聚焦工程实践,围绕异构算力的统一接入与调度到训推一体化的端到端方案,展开国产芯片适配与算子兼容、并行与通信优化(拓扑感知、带宽优先、KV-Cache)、推理成本工程(量化/切分/混部)、以及可靠性与运维(SLO、故障域、观测性)与安全合规(身份、审计、数据边界)等关键议题。结合电力、能源、制造、金融与互联网场景,给出可复现配置、指标与权衡,并复盘典型反模式与踩坑。目标是提供一套可迁移的工程基线,帮助团队在规模化场景下降低 TCO、稳定达标 SLO,加速从 PoC 到生产化落地。
演讲提纲:
- 引言:企业大模型应用的算力挑战
- 大模型算力需求的指数级增长(逆摩尔定律,每3-4个月翻番)
- 当前,企业在推进 大模型规模化工程落地时普遍面临以下挑战:
- 国产芯片模型适配速度慢,拖慢业务创新
- 推理性能与成本难以兼顾,制约规模化应用
- 可靠性要求高,系统容错与运维能力不足
- 模型输出质量与稳定性影响应用可信度
- 安全与合规压力持续加大
- 国产芯片与异构算力整合的必要性与战略价值
- 异构算力整合的技术路径与实践方案
- 硬件层:多元芯片的协同创新
- 国产芯片突破:昇腾等性能接近国际水平
- 异构计算架构:CPU/GPU/FPGA/ASIC的差异化优势与组合策略
- 高速互联技术:PCIe、NCCL、NVLink等提升通信效率
- 软件层:跨平台调度与优化
- 推理加速技术:模型量化、采样、并行、调度与大EP+PD分离策略
- 模型微调:多lora适配
- 异构云模式:解决异构、异域、异属算力的统一管理
- 平台化实践案例
- 未来发展趋势
- 芯片技术:异构GPU集成与存算一体架构突破内存限制
- 算法演进:MoE架构(PD分离,AF分离)与轻量化技术降低端侧部署成本
- 产业生态:算力交易市场与普惠化发展趋势
- 硬件层:多元芯片的协同创新
- 总结与展望
听众收益:
- 了解可落地的“选型—适配—部署—优化”方法:快速引入并筛选模型(模型库+评测基线+Multi-LoRA),统一接入异构/国产芯片并进行推理加速(KV/Prefix/Continuous Batching、PD 分离),附关键指标与权衡,直接用于工程决策与落地。
- 获得稳定性与安全的工程清单:多租户隔离、精细化权限与全链路审计、限流与抗攻击、分钟级恢复与秒级弹性扩缩容;在大规模并发下实现“高性能、低成本、可合规、可运维”。
by 陈聪
蚂蚁集团
高级技术专家当前智算节点的异常发现、定位、自愈主要依赖事后和被动式的监控工具,如DCGM-Exporter、Device Plugin等。这些方法虽已成熟,但普遍存在滞后性,无法在异常发生前有效预防,且本质是通算场景的延续,未能充分适应智算任务对节点稳定性更高的敏感度,导致智算业务面临更大的潜在风险。
本次演讲将深入探讨我们在智算节点压测拦截方面的创新实践。我们利用云原生Kubernetes的强大调度能力,将一系列定制化压测任务赋能到节点上线前、节点故障后、节点空闲时以及重点任务运行前等多个关键场景。通过这种全天候、立体化、且可任意组合的检查机制,我们实现了对智算节点的深度异常发现,远超传统监控手段。实践证明,这套压测体系能有效识别并阻断携带隐患的节点直接影响在线业务,最终显著提升智算系统的整体稳定性和业务连续性。
演讲提纲
- 1智算节点稳定性的挑战与现状
- 智算场景对节点稳定性的极致要求
- 现有异常发现、定位、自愈方法的局限性:
- 事后被动:无法有效预防业务损失
- 通用化:未针对智算特点优化,风险承载能力差异
- 传统工具(DCGM-Exporter, Device Plugin, 日志, nvidia-smi等)的优缺点
- 创新理念:主动式压测拦截
- 从“被动防御”到“主动出击”的思维转变
- 主动出击的一般思路:前置压测、故障预测等,及其优缺点
- 核心实践:基于云原生K8s的智算节点压测体系
- 架构设计:如何利用K8s调度能力编排和自动化压测任务
- K8s赋能下的多场景压测实践与效果:
- 节点上线前压测:源头阻断,直接拦截异常节点,确保新节点健康入池。
- 节点故障后压测:深度诊断,快速定位问题根源,实现节点快速流转(不闲置)。
- 节点空闲时压测:持续巡检,为节点定期体检保鲜,害群之马及时剔除。
- 重点任务运行前压测:重保策略,确保千卡、万卡等关键任务的稳定运行。
- K8s的灵活性:根据实际异常情况、负载情况,实现压测项与异常场景的任意组合编排。
- 智算专属压测项简述与案例分享
- 效果与价值
- 与传统监控手段的对比分析
- 业务稳定性指标的显著提升:故障率降低、MTTR缩短、有效训练时长增加。
- 展望与未来方向
听众收益:
- 基于云原生K8s实现多场景主动式智算节点压测的先进框架与实施思路。
- 学习如何利用K8s的灵活调度能力,实现压测项的任意组合与异常场景的动态编排。
- 了解如何在节点上线前拦截异常、故障后快速定位、空闲时定期体检以及重点任务前重保,全方位提升智算系统稳定性
- 启发性思考如何将主动式压测思维拓展到其他复杂系统稳定性保障中。
by 陈明杰
腾讯
专家工程师基于腾讯内部海量微服务对智能 AI 应用的迫切需求,tRPC-Agent 框架应运而生。当前业务场景不仅需要稳定的工作流编排,更亟需具备自主决策与多智能体协作能力的 AI 系统,以应对复杂多变的真实业务环境。
框架创新性地采用了“自主多 Agent 协作 + 图编排工作流”的混合架构。其核心技术包括:高度抽象的统一模型接口层,兼容业界主流的大模型服务;提供 LLMAgent、Chain、Parallel、Cycle、Graph 等多样化 Agent 执行引擎,内置 React 等 planer 以支持从简单问答到复杂决策流程的各类场景;内置完整的工具调用生态与 RAG 知识管理、可观测、长短记忆模块。
业务实践成效显著:腾讯元宝的深度写作功能通过 GraphAgent 实现自动化流水线,素材处理效率提升 3 倍;腾讯体育的“体育大聪明”应用借助多 Agent 协作,将战报生成时长从小时级缩短至分钟级;AMS 广告报表系统通过智能规划器将业务流程自动化程度提升至 90%。这些案例充分验证了框架在提升开发效率与复杂任务处理能力方面的核心价值。
演讲提纲:
- 什么是 Agent
- tRPC-Agent 开发背景
- tRPC-Agent 方案选型
- tRPC Agent 架构与挑战(整体架构、腾讯内部AI生态的欠缺)
- 核心模块拆解:Agent、Runner、Knowledge、Tool、可观测与记忆
- 业务实践复盘
- 总结与展望
听众收益:
- 了解构建Agent需要解决的核心问题
- 了解腾讯内部Agent的前沿实践
by 黄涛
阿里云
弹性计算 资深技术专家在生产场景中,AI 智能体展现出了长生命周期、突发算力需求、强隔离性以及成本效益并重的多重诉求。本次分享将探讨 AI Agent 对容器基础设施带来的全新挑战,并深入分析如何在新时代下构建支撑 AI 基础设施的新一代容器环境,重点关注 Node-aware 容器场景和 Serverless 容器场景的应用。
具体而言,在 Node-aware 场景中,引入 Pod 级虚拟化,以提供更强的隔离性和秒级启动时间。在 Serverless 容器场景中,则采用容器休眠机制能够实现低成本的快速唤醒。结合可调整的 VPA(Vertical Pod Autoscaler),我们可以根据实际需求动态优化资源配置,并通过镜像缓存技术加速冷启动。本议题将基于真实实践,总结 AI Agent 与推理业务的关键需求,分析容器平台的能力边界,并分享在工程化落地过程中的最佳实践经验。
演讲提纲:
- AI Agent 对容器基础设施的全新挑战
- 需求画像:长生命周期与多会话、成本敏感与弹性、 不可信代码与沙箱隔离
- Node-aware容器场景如何保障AI Agent安全性
- Serverless容器场景支持智能体的实践:安全沙箱运行环境、镜像缓存技术、容器休眠技术、容器柔性技术
- 推理服务基础设施
- 模型服务作为AI Agent的执行大脑,工程化落地中,LLM的规模化部署挑战
- PD分离架构下,RoleBasedGroup(RBG)基于角色的编排、发布管理和故障处理
- 最佳实践
- AI Agent基于容器的实践和架构:基于休眠、唤醒和状态保持的智能体业务实践
- 开源 RoleBasedGroup 在 PD 分离场景的落地与工程化实践
- 总结与展望
听众收益:
- 理解 AI Agent 的运行与成本模型,AI Agent 对容器平台的核心诉求
- 理解基于容器的休眠&唤醒、PVM、柔性变配、镜像缓存、隔离等关键实现思路与取舍
- 学习基于容器的AI Agent工程化落地最佳实践
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Realm Beijing
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手