大模型在实际应用中普遍面临推理成本高、算力需求大... 展开 >
大模型推理优化与边缘 AI 部署
会议室:汉宫 + 明宫出品人:刘峥
- Topic 1
龚睿昊
ModelTC开源社区 负责人 - Topic 2
马腾
阿里巴巴 高级技术专家 - Topic 3
宋晓辉
OPPO AI 中心 大模型算法部 端侧化算法组负责人 - Topic 4
汤雄超
清程极智 CEO
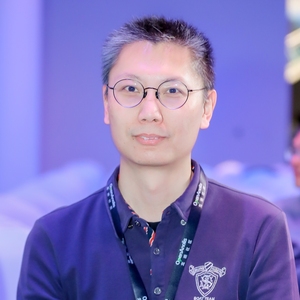
专题出品人:刘峥
阿里云资深技术专家
CCF系统软件专委会委员。2011年加入阿里集团,先后负责操作系统、云计算基础设施相关系统和产品的研发工作,参与Mooncake开源项目的筹建并在SOSP、ASPLOS等学术会议上发表多篇论文。当前主要聚焦AI基础设施、下一代数据中心系统软件的研发工作。
地点:汉宫 + 明宫
专题:大模型推理优化与边缘 AI 部署
大模型在实际应用中普遍面临推理成本高、算力需求大的挑战,成为制约其广泛落地的重要障碍。本专题将重点讨论三方面内容:首先,推理优化技术,包括知识蒸馏、剪枝、量化(4-bit/8-bit)等模型压缩方法,以及 PagedAttention、FlashAttention 等高效推理算法;其次,端侧部署实践,探讨大模型在手机、PC、智能汽车、工业摄像头等边缘设备上的优化与应用,实现低延迟和隐私保护;最后,成本效益分析,通过云端、边缘和混合部署方案的 TCO 模型,为企业提供量化的投入产出参考。
by 龚睿昊
ModelTC开源社区
负责人大模型时代的模型生产成本更加高昂,模型尺寸大、并行规模大、服务并发高,体系化的大模型工具链和系统对于提升模型迭代和研发效率至关重要。
本次演讲将分享在大模型工具和系统建设的实践经验,介绍搭建的大模型训练、压缩和推理部署系列工具,覆盖多种模态和场景,通过分析阐述其中的相关算法创新与系统实现原理,汇报团队在多种模态大模型的训练系统优化、模型压缩算法和大规模并行服务上的系列探索。
演讲提纲:
- 引言:
- 视频、图像、语音、语言多种模态生成式大模型推理的系统挑战
- Light系列推理工具生态
- 核心技术解析:
- 多进程架构:模态伸缩与扩展
- 多维度压缩方法:量化、Token Pruning、稀疏和Cache复用
- 动态扩缩容:大规模服务的实时弹性扩缩容设计
- 实时视频生成:高质量4步蒸馏
- 应用案例
- 视频生成民主化:个人玩家的福音
- 规模服务的降本:组合拳的成本控制
- 未来展望:
- 统一模态的融合设计
- 应用层的系统打通
听众收益:
- 快速了解生成式大模型的核心推理优化技术,掌握各种模态类型的优化异同点,并理解领域发展的最新趋势
by 马腾
阿里巴巴
高级技术专家Mooncake 构建了一个以 KVCache 为核心的云上推理软件栈(AI Stack),通过 Transfer Engine、KVCache Store 与分层上下文缓存等组件,将 Prefill/Decode(PD)分离、异构并行与零拷贝传输(RDMA/GPUDirect)有机结合,显著提升 GPU 利用率与吞吐并降低延迟和内存占用。
该栈在工程化层面与主流推理框架(如 SGLang、vLLM、RTP)深度集成,并且和 Router,Gatway,K8S Deployment 等组件一起组成了推理软件栈。从而支持 Docker 一键部署,KVCache 存储服务化,与网卡 /GPU 虚拟化等等。已在真实业务中实现 QPS 提升超 3 倍、GPU 利用率由不足 40% 提升到约 75%、内存占用下降约 40% 并将延迟减半。
为解决 PD 分离在云原生环境中的部署与运维难题,RoleBasedGroup(RBG)提供基于“角色”的声明式编排、顺序启动、精细扩缩容和智能滚动升级能力,使复杂多角色集群能实现无感变更与快速恢复。配合 AIGW 的全局、缓存感知与多因子路由调度,系统可实现请求级的缓存亲和、过载保护与多租户 SLO 保障,从而在大规模生产环境中将 PD 分离的性能优势持续、稳定地转化为可运维的产能与成本节约。本次演讲将分享这些技术内容的落地实践。
演讲提纲:
- 推理系统当前问题:大模型推理的成本、吞吐与长上下文管理难题;PD(Prefill/Decode)分离带来的资源特性差异
- 核心:以共享 KVCache 为中心,实现上下文复用与内存池化,避免重复计算并提升资源利用率
- Mooncake 核心组件与技术亮点:全链路零拷贝、Multi‑NIC 池化、拓扑感知与容错;支持 eRDMA/GPUDirect
- KVCache Store:透明多级缓存、P2P Store、coro_rpc 控制路径优化与上下文指纹索引
- 分层上下文缓存与自适应批处理,支持 EP/DP/TP/PD 混合并行。与 SGLang、vLLM、LMCache 等框架兼容,提供 whl/docker 部署路径,便于云上规模化落地
- LLM 推理软件栈工程化效能与集成方式:通过 RBG(编排)与 AIGW(调度)协同,来实现生产化保障,提供一键部署的 LLM 推理软件栈
- RBG(Role‑based Pod Group)提供声明式角色模板、DAG 启动顺序、按角色精细扩缩容、智能滚动升级与分级故障恢复。
- AIGW 提供缓存感知全局路由、过载保护与多租户 QoS(基于 Envoy 扩展),实现请求级 KVCache 亲和与 SLO 驱动调度
- 生态、落地路径与演进方向
听众收益:
- 快速掌握以 KVCache 为核心的 PD 分离架构与 Mooncake(Transfer Engine + KVCache Store),理解 RDMA/GPUDirect 零拷贝带来的实测收益
- 学习用 RBG 的声明式编排、DAG 启动、精细扩缩容与零中断升级,配合 AIGW 的缓存感知路由、过载保护与多租户 QoS,把性能稳定转化为生产力
by 宋晓辉
OPPO
AI 中心 大模型算法部 端侧化算法组负责人近两年来小规模模型的性能和端侧算力在高速发展,这为模型端侧化提供了可行性。本次分享介绍 OPPO 大模型端侧化的技术路线,该路线支撑了 OPPO 端侧智慧语音,AI 搜索等线上业务,并在模型压缩,解码加速等方面做到了行业领先水平。
演讲提纲:
- OPPO 端侧化算法技术栈全景:介绍 OPPO 最新模型端侧化算法技术路线
- 稀疏化 & QAT:端到端的量化损失训练,绕过 PTQ 步骤,直接和芯片平台的量化格式打通
- 编解码加速:支持最高 128k 的上下文和最高 240token/s 的通用场景解码速度
- QALFT 框架:自研端侧量化感知训练框架,为业务解耦优化和高效 OTA 升级提供支持
- 总结和展望
听众收益:
- 了解OPPO端侧化团队本年度内最新的技术实践路线
- 了解相对领先的端侧化模型压缩和解码加速技术方案
by 汤雄超
清程极智
CEO在大模型加速落地的同时,异构算力和精度演进让推理在性能、成本以及国产算力适配上压力陡增。本演讲聚焦「量化推理 + 多算力平台适配」,介绍赤兔如何通过「算法 + 引擎 + 算子」联合优化及 Soft Float8→软 FP4 等技术,在国产 GPU/NPU/CPU 上实现通用高效推理。
演讲提纲:
- 行业背景与核心挑战
- 大模型时代的算力需求爆发与多样性算力平台现状
- 大模型推理在多算力平台上面临的性能、成本、适配性痛点
- 硬件异构化(GPU、NPU、DCU、CPU 并存)
- 精度与性能的平衡(FP16 → FP8 → FP4)
- 推理系统复杂化与工程门槛高
- 核心概念解析:量化推理与多算力平台适配
- 大模型量化推理技术定义(如INT8、INT4等)
- 主流算力平台的架构差异与对量化推理的技术要求
- 赤兔量化推理优化技术
- 赤兔的起点:构建「国产算力 + 国产引擎 + 国产模型」闭环
- 背景:海外主流推理引擎(vLLM、SGLang、Ollama)高度依赖 NVIDIA 生态,国产算力适配困难。
- 赤兔选择从「联合优化」出发
- 算法 + 推理引擎 + 算子 联合优化,突破 CUDA native 限制
- 支持昇腾、沐曦、海光、鲲鹏、燧原等多平台
- “m×n 优化爆炸” 到 “m+n 复用” 的设计
- FP8 原生支持到多平台软 FP4 扩展
- 赤兔 Soft Float8 在线转换机制
- FP8 方案扩展至 FP4
- 赤兔的起点:构建「国产算力 + 国产引擎 + 国产模型」闭环
- 赤兔推理引擎的技术架构与创新点
- 面向多算力平台的模块化设计:算力抽象层、量化优化层、推理执行层
- 量化推理优化的核心技术路径优势
- 跨平台优化与工程设计
- Layout as a Type
- 融合算子分发机制
- 混合 KV Cache 管理
- 多并行模式支持(EP+DP+TP+PP)
- 典型场景与行业应用案例
- 未来方向
听众收益:
- 全面了解大模型量化推理在多算力平台上的趋势与技术要点,弄清楚 FP8/FP4、异构算力等对性能、成本、适配性的真实影响
- 获得一套可迁移的工程优化思路,借鉴赤兔在「算法 + 引擎 + 算子」联合优化、Soft Float8 / FP4 以及多并行模式上的实践
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Realm Beijing
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手