在任职期间负责商汤自研深度学习框架及模型生产工具的产品开发与研发管理,主导商汤大模型一体机及大模型专家服务解决方案,将前沿技术转化为市场化产品,在金融、能源等关键行业取得了显著的应用实践成果。作为国产化业务负责人,深度参与并推动了软硬件适配体系的国产化进程,推进落地了多个国家级重大科研项目,为行业的标准化与协同发展贡献了重要力量。取得5项发明专利及2项软件著作权。
讲师介绍
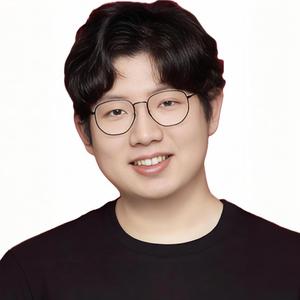
专题演讲嘉宾:刘叶枫
商汤技术产品总监
议题介绍
地点:宴会厅A
所属专题: AI Infra
演讲:大规模异构算力集群的优化与调度实践
随着 AI 大模型迈入“通用人工智能(AGI)”加速发展的新阶段,算力需求呈指数级增长,如何构建具备高性能、高可靠性与可持续性的 AI 基础设施,成为支撑大模型演进的关键课题。尤其在国产化进程加速的大背景下,如何有效调度和利用包括 NVIDIA 及多种国产芯片在内的“异构算力集群”,成为当前业界普遍关注的技术挑战。
本次分享将结合商汤在“大装置 SenseCore”体系下的实战经验,探讨异构算力集群在资源调度与系统优化中的关键技术路径。内容涵盖从底层硬件到上层服务的一体化基础设施架构设计,重点聚焦异构资源的统一管理、弹性调度与高效利用等问题。
演讲将深入解析多芯片协同训练中的核心技术,例如分层集合通信、异步训练、自动负载均衡等,如何帮助系统突破“木桶效应”,实现国产与主流芯片在实际训练与推理中的协同加速,进而支撑如“异构混训”“大规模 EP 推理”等大模型场景的高效落地。
演讲提纲:
- 背景与挑战:介绍AI大模型时代,算力需求猛增,以及管理“国产+海外”混合算力的核心痛点
- 如何构建从基础设施、平台、算法到服务的全栈一体化AI Infra解决方案
- 如何通过大规模的异构集群调度、通信库优化技术、训练推理优化让不同芯片高效协同
- 成果与展望
听众收益:
- 了解当前国产异构算力的现状,并获得务实可行的国产算力适配与优化策略,业务迁移至国产算力的可能性和商业可行性
- 学习提升混合硬件集群效率的关键技术与架构思路
- 洞察AI算力基础设施的未来发展方向与国产化趋势
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手