DeepSeek等开源模型的快速发展,极大的促进了大模型应用的繁荣,大模型推理的... 展开 >
大模型推理性能优化
会议室:第二会议室C出品人:刘童璇
- Topic 1
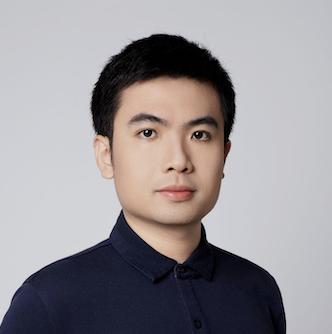
汤雄超
清程极智 CEO - Topic 2
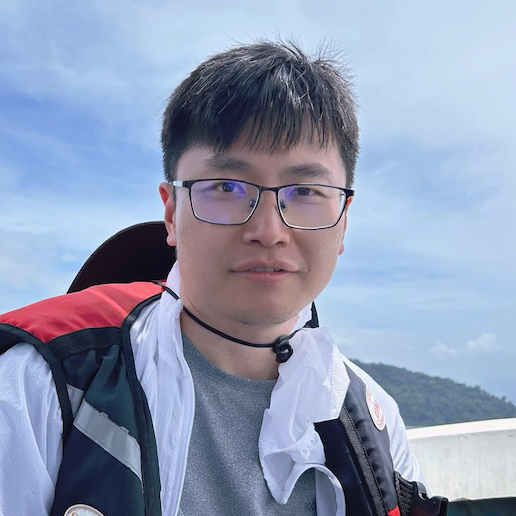
杨培军
京东零售 AI 架构师 - Topic 3
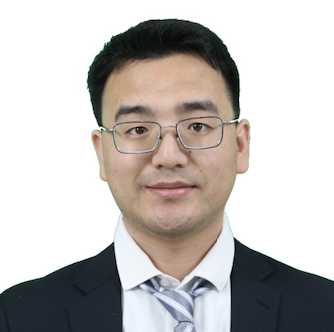
陈波
华为 昇腾推理架构师
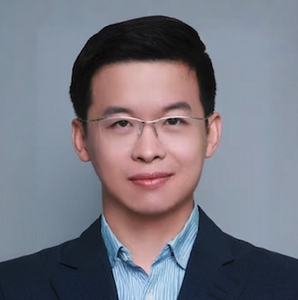
专题出品人:刘童璇
京东零售智能平台部技术总监
刘童璇,京东零售集团智能平台部技术总监,负责推理引擎和服务部,大模型推理引擎xLLM负责人。曾负责推荐深度学习开源框架DeepRec,广泛用于国内各个互联网公司的搜推广场景中。同时参与了多个深度学习开源框架的工作,并在多个人工智能顶会发表paper。
地点:第二会议室C
专题:大模型推理性能优化
DeepSeek等开源模型的快速发展,极大的促进了大模型应用的繁荣,大模型推理的吞吐和延时直接关系到推理的成本和用户的体验。各个公司都在关注如何用好DeepSeek等大模型。本专题将围绕大模型推理引擎的优化,讨论如下方面的话题:
- 分布式优化,包括通信优化、分布式策略优化、EP/DP/TP并行等方面
- 模型优化,包括模型量化、Token剪枝、模型蒸馏等方面
- 请求调度优化,包括continous batching、PD分离等方面
- 计算优化,包括MLA/MoE/Attention计算优化、Triton、FlashInfer、FlashAttention等开源项目
- Runtime优化,包括执行流水线优化、显存优化等方面
- 大模型推理引擎,包括开源或者闭源的大模型推理引擎优化亮点和实践。
通过本专题,听众能够了解到一系列大模型推理优化的技术手段,对大模型推理优化有更深入理解。
by 汤雄超
清程极智
CEO随着国产大模型技术的快速发展,如何利用国产算力芯片高效部署和运行这些模型成为关键问题。当前,FP8 精度模型的推理高度依赖英伟达 Hopper 架构 GPU,这使得国内企业在部署时面临硬件成本高昂、依赖进口芯片等困境。为解决这一问题,清程极智与清华团队联合开源了赤兔推理引擎,本次演讲将分享赤兔推理引擎如何通过底层技术革新,实现了在非英伟达 Hopper 架构 GPU 及各类国产芯片上原生运行 FP8 精度模型,并确保模型精度无损。
演讲提纲
- 赤兔推理引擎的诞生背景
- 问题的提出
- 合作与开源
- 赤兔推理引擎的核心技术革新
- 介绍赤兔推理引擎的底层技术框架
- 如何实现对不同架构芯片的适配
- 关键技术创新点
- 在非英伟达 Hopper 架构 GPU 上的优化策略
- 针对国产芯片的定制化开发
- 确保 FP8 精度模型的无损运行
- 通过技术手段降低硬件成本,提升部署效率
- 赤兔推理引擎的实践与效果
- 在非英伟达H系列GPU芯片上运行 FP8 精度模型的案例
- 对比使用赤兔推理引擎前后的性能提升和成本降低
- 行业意义和未来规划
- 对国产大模型部署的推动作用
- 对自主可控算力生态的贡献
- 未来技术发展方向和行业合作倡议
您认为,这样的技术在实践过程中有哪些痛点?
- 适配不同国产芯片需要时间。
听众收益
- 有限硬件资源下的大模型推理取舍
- 赤兔软FP8方案:软件工程优化弥补硬件不足
by 杨培军
京东零售
AI 架构师随着DeepSeek的爆火,其卓越的性能和成本引起了科技界的广泛关注,同时经过一两年的技术发展,LLM推理加速与部署进入深水区。LLM模型在京东零售内部有大量面向C端用户、B端商家和广告主系统等的落地应用,业务场景提出了较高的SLO要求和成本压力,如何兼顾高吞吐与低时延是迫切要解决的问题。本次演讲将展开介绍这其中面临的技术挑战和核心技术要点,分享可落地的优化实践经验。
演讲提纲
- 京东零售大模型应用场景
- 大模型推理服务落地面临的技术挑战
- 推理服务核心优化技术
- 技术架构与核心功能
- 请求/实例全局调度
- 全异步化运行与多层流水线
- 算子高效执行与显存管理
- 未来优化方向展望
您认为,这样的技术在实践过程中有哪些痛点?
- 要求开发者对CPU/GPU/NPU高性能编程,以及LLM/LVM模型有深刻理解和技术掌握。
您的演讲有哪些前沿亮点?
- LLM推理仍面临较大的成本压力,结合用户体验SLO要求,如何兼顾高吞吐与低时延目前前沿且迫切要解决的技术难点。
听众收益
- 了解LLM推理在工业界落地的前沿进展、业务落地技术挑战,以及技术解决方案。
by 陈波
华为
昇腾推理架构师在大模型加速部署进入深水区的今天,如何在国产算力平台上高效运行大模型,已成为影响应用落地的重要一环。本次分享将介绍昇腾 DeepSeek 大模型推理架构,性能优化方案及关键优化措施,以及优化建议。
演讲提纲
- 背景缘由
- 大模型推理的计算挑战:参数规模持续增长带来的推理延迟、资源瓶颈问题
- 国产算力平台的适配需求与技术突破窗口
- DeepSeek 模型场景需求与推理优化目标设定
- 昇腾推理解决思路
- 昇腾芯片架构简述与深度学习模型推理特性匹配分析
- 昇腾 CANN 生态支持在推理侧的核心能力
- DeepSeek 在昇腾平台的部署路径与模块解耦设计思路
- DeepSeek 推理加速关键技术
- 大规模专家并行调度优化
- 集合通信(All2all)优化策略
- 异构资源调度与算子融合:
- 效果与总结
- 推理加速前后主要性能指标对比(吞吐、延迟、资源利用率)
- 可推广的优化经验总结
- 对昇腾平台下大模型推理未来演进方向的初步展望
您认为,这样的技术在实践过程中有哪些痛点?
- 部署相对复杂,需要大并发量才能发挥价值。
您的演讲有哪些前沿亮点?
- 大规模专家并行
- 集合通信优化
- 调度优化
听众收益
- 基于昇腾的MoE推理性能优化方案及关键技术
关注主办方(InfoQ)
联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手