中国科学院与美国康奈尔大学联合培养博士,北京大学双学士。现任京东集团算法总监,京东零售数据与算法通道委员,CCF 大赛专家委员会专家、京东赛题全球发布人,QCon大会优秀出品人和明星讲师。兼任中国科学院大学硕士企业导师、北京工业大学硕士企业导师、西安电子科技大学客座教授。在国际顶级期刊发表学术论文数十篇。专注AI技术创新,主持设计了Multi-Agent Planning算法架构并落地京东商家智能助手,擅长多Agent动态规划与协同训练、LLM微调与强化学习。
讲师介绍
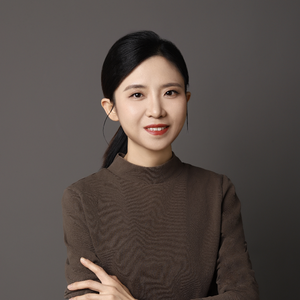
专题出品人:韩艾
京东集团算法总监
议题介绍
地点:第二会议室B
所属专题:AI Agent 构建与多场景实践
演讲:JDAgents-R1:基于强化学习的异构多智能体联合进化算法
多智能体强化学习(MARL)已成为处理日益复杂任务的重要范式。然而,异构智能体之间的联合进化仍面临合作效率低与训练不稳定等挑战。为此,京东提出了一种面向MARL的联合进化算法框架 JDAgents-R1,该方法首次将组相对策略优化(GRPO)应用于异构多智能体的联合训练中。通过迭代优化智能体的大语言模型(LLMs)与自适应记忆机制,JDAgents-R1实现了决策能力与记忆能力的动态均衡,并能有效减少重复推理、加快训练收敛。在通用场景以及商家定制化场景中的实验表明,JDAgents-R1在基于更小规模开源模型的情况下,依然能够达到与大规模语言模型相媲美的性能表现。
演讲提纲
- 多智能体训练技术
- 多智能体应用案例
- LLM决策与Memory进化
- 多智能体强化学习
- JDAgents-R1: 联合进化算法方案
- 多智能体协作
- GRPO联合训练算法技术
- Memory更新技术
- 电商领域落地实战
- 通用与垂直领域任务
- 商家多智能体联合进化
- 未来展望
您认为,这样的技术在实践过程中有哪些痛点?
- 多个大模型联合训练的信息通信难题:多卡多机,如何实现模型斩断与更新?
- 智能体memory进化:memory会干扰决策质量,如何评估memory的增减?
您的演讲有哪些前沿亮点?
- 多智能体联合进化的算法设计,符合复杂多智能体场景的online learning需要
- 决策与记忆机制联合更新
听众收益
- 多智能体如何协作
- 多个模型训练的更新策略
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手