本专题将通过深入探讨多模态大语言模型的核心优势与实际应用案例,介绍多模态技术如何... 展开 >
多模态大语言模型的崛起与应用
会议室:大宴会厅出品人:高杰 博士
- Topic 1
刘广
智源研究院 技术经理 - Topic 2
赵晨旭
明略科技 多模态大模型部门负责人 - Topic 3
谢榛
阿里云 高级算法专家 - Topic 4
牛建伟
蔚来汽车 座舱智能感知团队负责人
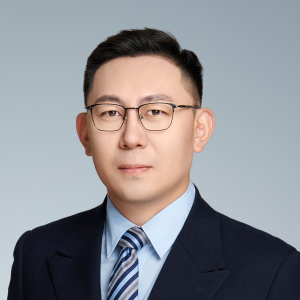
专题出品人:高杰 博士
蔚来汽车人工智能研发负责人 & 高级总监
博⼠毕业于中国科学院声学研究所,有 20 年语⾳处理、⾃然语⾔处理和机器学习的相关⼯作经验。现任蔚来座舱⼈⼯智能研发负责⼈。历任腾讯搜索部⻔语⾳研究员,负责语⾳搜索研发⼯作;任微软 STC 语⾳科学家,负责基于分布式计算平台的超⼤规模语⾳识别模型训练系统,语⾳助⼿ Cortana 研发⼯作;任阿⾥巴巴资深算法专家,是达摩院语⾳实验室创始团队成员,负责阿⾥巴巴⾃然对话系统 NUI 核⼼算法研发、平台化、产品化和商业化的⼯作,负责各 AIoT 各种场景下的落地:包括汽⻋、电视领域、⼿机 App 领域(⾼德 /⼿机淘宝 /⽀付宝)等的落地。
地点:大宴会厅
专题:多模态大语言模型的崛起与应用
本专题将通过深入探讨多模态大语言模型的核心优势与实际应用案例,介绍多模态技术如何通过处理和融合多种数据类型,推动行业创新,优化业务解决方案,并加速实际业务场景中的落地与实践。聚焦多模态大语言模型在电商、营销、设计、视频创作、动画制作、和文本分析等领域的应用。
by 刘广
智源研究院
技术经理Aquila-VL-2B 是 2B 级别 SOTA 的多模态模型。该模型基于 Llava-onevision 的训练思路,引入多分辨率来提升对图像内容的理解。在本次分享中,主要介绍了模型数据集的构建和处理过程,包括多种数据来源数据的格式统一以及数据选择,针对弱项的数据合成等。此外,还讨论了对训练效率和框架的提升,在 FlagScale 框架上实现了相对 Deepspeed 训练效率 1.7 倍的提升。Aquila-VL-2B 的创新之处在于系统化的构建了多模态模型的数据,训练以及评测的 pipline。
演讲提纲:
- 多模态模型挑战
- 缺乏大规模高质量开源数据
- Aquila-VL-2B效果
- SOTA性能展示
- 推理能力分析
- 流程概览
- 架构与思路
- 训练关键步骤
- 数据处理
- 格式统一与数据选择
- 数据合成技术
- 模型训练
- 多分辨率理解
- 训练效率提升
- 效果评估
- 量化评估方法
- 总结与展望
听众收益:
- 多模态数据集构建以及数据合成的先进方法
- SOT A多模态模型的训练方法
by 赵晨旭
明略科技
多模态大模型部门负责人多模态内容资产,包括以“视频、图像”为主要形态的商业传播内容与广告等,不仅是中国品牌的宝贵资产,也是其出海传播,讲述品牌故事、输出情感文化的载体。这些内容能否被全球消费者们所正确理解,是企业亟待解决的问题。
一方面,中国品牌成功出海,需要理解品牌内容在不同文化背景下所产生的情感反应,并采用全球消费者可以接受的方式,讲述中国品牌和中国故事。
另一方面,中华文化走向世界,也需要借助国际受众易于理解的方式,对外讲述和传播我们的文化精髓。
要实现上述的目标,中国品牌已经开始应用生成式人工智能 (GenAI) 技术,构建面向全球的多模态内容的生产能力,但由于目前 AI 在解读人类的主观情感方面有较大空白,在全球化的传播应用中,仍面临着现实中的技术挑战。最基础的问题是缺少中国品牌全球化的“内容资产数据集”。
目前缺乏这方面的研究,没有可以进行评测的基础,大多数现有的基准都存在几个缺点:1)模态数量有限,题目多为选择题,难以测量逻辑推理过程;2)视频中的内容和场景过于单调,仅涉及对视频内容的客观描述;3)对于视频的理解停留在客观层面,无法量化评估人在观看视频时的主观感受。
为了弥合与实际应用的差距,明略科技引入大规模的视频主观多模态评估数据集 Video-SME。通过收集不同人群在观看相同视频内容时脑电图 (EEG) 和眼动追踪区域的真实变化,设立了新的任务和协议,分析和评估不同受试者对相同视频内容的认知理解程度。
技术层面上,目前国内外对于 AI 的研究大多停留在解析客观事物的层面,比如解析视频中的人物、场景、故事情节等,但是缺乏有效的手段让 AI 理解人的主观感受,比如年轻人观看某段视频时会产生何种情绪,老年人观看某段视频时是否能够准确理解内容,不同国家用户观看某段视频时是否能够理解文化含义等。让 AI 理解和模拟人类的主观感受,是 AI 产生自我意识的开端,是通用人工智能(AGI)重要的组成部分。在该领域投入科研力量,探索能够让 AI 感知到人类主观感受的有效手段,有机会实现对于国外 AI 技术的弯道超车。
依托于新的评测标准,明略科技创新研发了超图多模态大语言模型 (HMLLM) ,探索不同人口统计、视频元素、脑电图和眼动追踪指标之间的关联。HMLLM 可以弥合丰富模态之间的语义差距,并集成帧与帧之间的信息以执行逻辑推理,我们在 Video-SME 和其他基于视频的生成性能基准上设计了实验,大量实验评估证明了该方法的有效性。
演讲提纲:
- 无论有多少亿个参数,大语言模型都无法具有主观感知能力
- 什么是主观感知能力
- 机器模拟人的主观感受有什么意义
- Video Subjective Multi-modal Evaluation Benchmark(Video-SME)
- 现有公开多模态视频评测标准的局限性
- 真实采集人的脑电、眼动模态
- 数据集构建与评测标准制定
- 超图多模态大模型
- 超越Foundation Model
- 超图多模态大模型构建
- 评测主观指标
- Video-SME实验结果
- Video-MME实验结果
- 其他多模态与情感类数据集实验结果
- 机器模拟人类主观感受的应用
- 实际应用效果展示
- 未来工作介绍
听众收益:
- 走进多模态视频理解全新的未知领域
- 探索机器具备主观感受的全新课题
by 谢榛
阿里云
高级算法专家在过去的一年里,多模态大模型因其广泛的潜在应用而受到了前所未有的关注。此次演讲旨在概述当前多模态模型的发展状况,遇到的问题和挑战,并通过具体案例深入探讨该领域的最新进展。将结合团队近期的两个工作——CityLLava(2024CVPR AI city challenge Track 2 winner)与IVTP(ECCV2024),来详细介绍行业多模态模型的迭代范式及其训练与推理过程中的加速优化技术。希望通过本次分享,能够为参会者提供一个多模态大模型领域的全面视角,激发更多关于未来发展方向和技术革新的思考。
更多详细内容可参考:
- https://www.ecva.net/papers/eccv_2024/papers_ECCV/papers/02577.pdf
- https://github.com/alibaba/AICITY2024_Track2_AliOpenTrek_CityLLaVA
演讲提纲:
- 多模态模型现状概述
- 多模态概述及架构发展
- 多模态能力场景
- 行业多模态模型迭代范式
- 行业多模态场景难点
- 数据构建方法
- 模型微调范式
- 多模态训练及推理加速技术
- 多模态训推加速方法概述
- IVTP:指令指导的视觉Token 剪枝技术
- 多模态总结展望
听众收益:
- 深入了解多模态大模型的进展
- 启发行业多模态模型高效迭代和训推加速技术相关思考
by 牛建伟
蔚来汽车
座舱智能感知团队负责人从2023年6月开始,蔚来座舱智能化团队开始研发面向智能座舱应用场景的多模态大模型的技术预研工作,经过1年多的系统搭建、数据集构建和训练部署方案的实践,取得了一些技术进展和一定的多模态大模型的应用认知。分享包括对于车载场景的算法适配的训练流程、数据采集筛选和清洗方法、多分辨率以及多VIT encoder的模型改进方法、端侧部署的具体实践情况。同时作为多模态模型的一部分也会简要介绍在语音大模型方面的一些最新进展。本次分享主要涉及多模态大模型技术落地车载场景的业务实践和技术挑战。
演讲提纲:
- 大模型在座舱智能化上的定位和价值
- 更自然、主动的交付方式
- 更好的易用性
- 蔚来多模态大模型的介绍
- 模型方案
- 应用场景和结果展示(守卫大模型、NOMI(语音大模型)、视觉理解能力)
- 视觉模态模型的技术实践
- 训练关键流程
- 数据构建方案
- 多分辨率、多ViT encoder对性能的影响
- 视觉特征压缩
- SFT调优(多task的选择)
- 技术难点和挑战
- 听觉模态模型的技术实践
- 训练关键流程
- 多语言识别上对数据筛选和模型结构的改进优化
- 技术难点和挑战
- 端侧部署实践
- 端侧部署方案介绍
- 端侧部署的现状和挑战
- 总结和展望
听众收益:
- 了解面向智能座舱的多模态大模型的车企技术实践和技术进展
- 了解多模态大模型的技术重点和业务挑战
关注主办方(InfoQ)
联系我们
交通指南
北京丰大国际大酒店
Beijing Fengda International Hotel
地址:北京市大兴区荣华中路20号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手