在生产环境里的模型参数和用户数据的数据量越来越多,也越来越大,无论是大模型离线计... 展开 >
性能优化与资源统筹|ArchSummit
会议室:百味园出品人:于佃海
- Topic 1
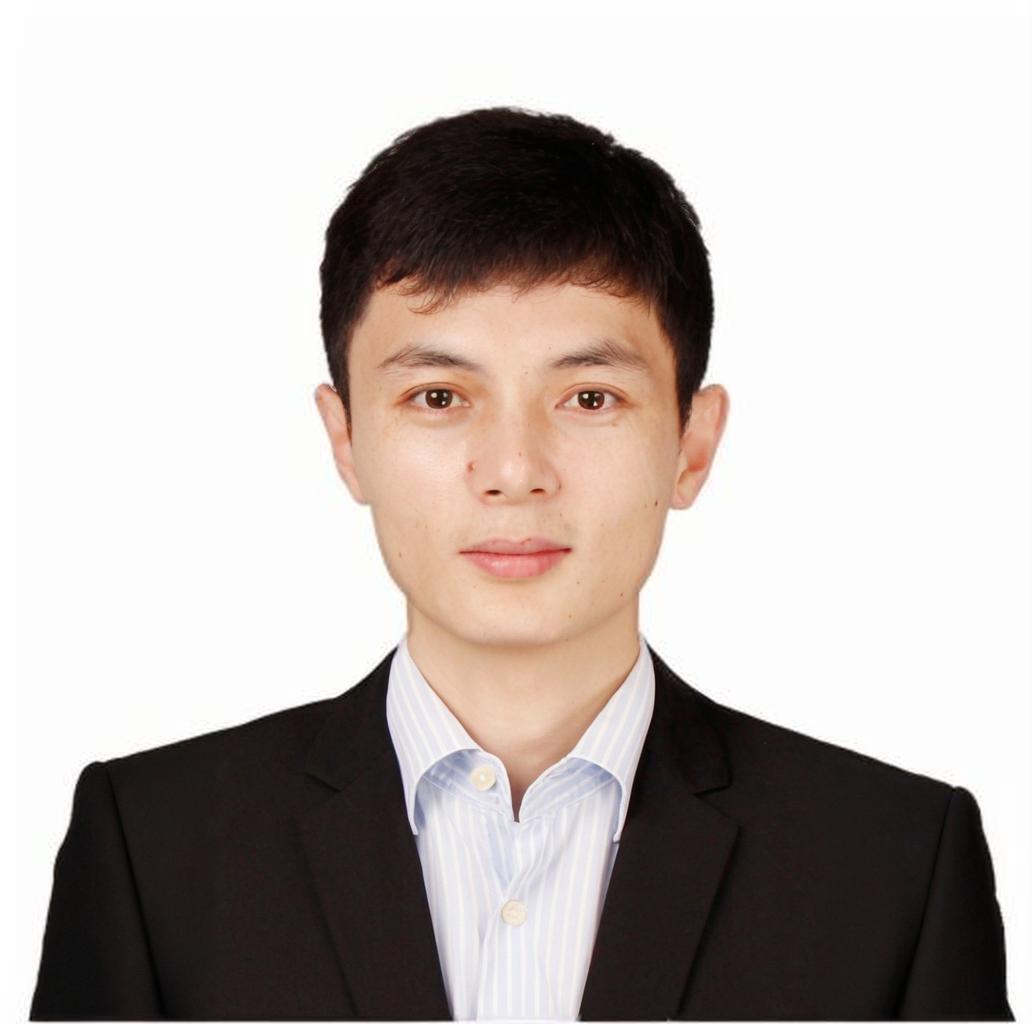
丁虎平
阿里国际 AI Business 智能计算负责人 - Topic 2
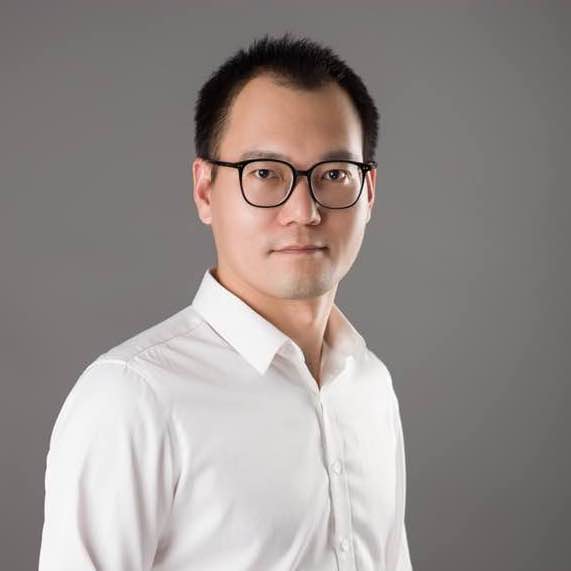
张文涛
焱融科技 CTO & TGO 鲲鹏会学员 - Topic 3
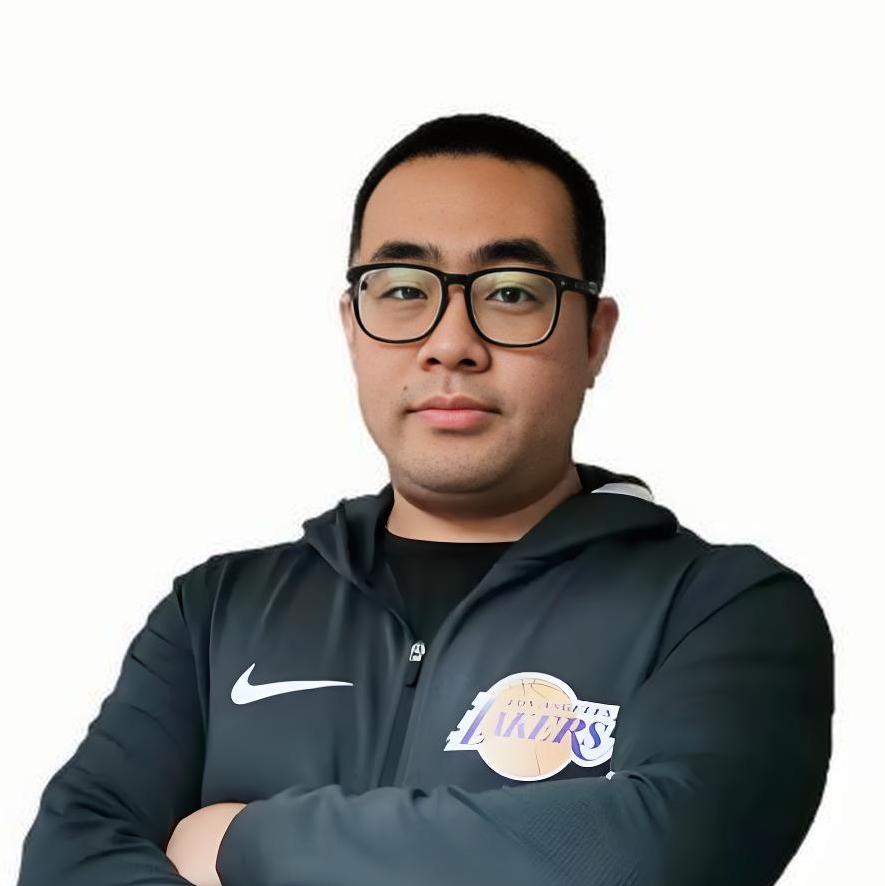
王天庆
贝壳找房 容器团队负责人
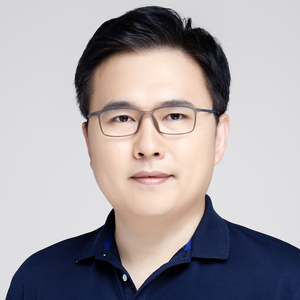
专题出品人:于佃海
百度飞桨平台总架构师
于佃海,百度飞桨深度学习平台总架构师,百度集团机器学习TOC主席。2008年从北京大学硕士毕业后加入百度,长期从事从事机器学习、深度学习相关的技术研发和应用工作。目前作为总架构师整体负责飞桨平台架构设计和技术开发,同时负责文心大模型的大规模分布式训练、推理部署等相关工程架构工作。曾主持及参与多项国家科技计划项目课题研究。曾获北京市科学技术进步奖一等奖、中国电子学会科技进步一等奖、世界互联网大会领先科技奖。中国计算机学会授予于佃海2019年CCF杰出工程师奖,以表彰他在机器学习大规模产业应用方面做出的重要贡献。
地点:百味园
专题:性能优化与资源统筹|ArchSummit
在生产环境里的模型参数和用户数据的数据量越来越多,也越来越大,无论是大模型离线计算还是在线推理,对资源的需求越来越吃紧,传统的服务对耗时性能也越来越敏感,包括搜推广和传统服务都进一步与大模型结合(一些场景和环节调用),加剧了资源和耗时等性能问题,但 IT 成本需要得到控制,因此性能优化上需要越来越深入去研究,从系统层面的深入到线程协程去扣代码细节,资源上需要进一步统筹GPU/VRAM和CPU/DRAM。
by 丁虎平
阿里国际
AI Business 智能计算负责人在跨境电商的场景下,有着不同的地域和文化背景,以及多语言的需求,场景比较复杂,业务模型也非常地多样化。同时庞大的市场规模,对模型服务的吞吐量、实时性以及服务成本也提出了很高的要求,如何做好模型服务优化成为一个很重要的话题。本次演讲,我们将从跨境电商的场景出发,与大家交流在模型服务优化方面的一些实践,包括资源管理、任务调度、模型推理等方面。
演讲提纲:
- 跨境电商业务介绍
- 跨境电商场景面临的挑战
- AIDC AI团队的模型服务框架
- 模型推理优化
- 任务调度优化
- 计算集群资源管理优化
- 总结与展望
听众收益:
- 了解跨境电商场景的业务和挑战
- 交流模型服务优化方面的技术和实践经验
by 张文涛
焱融科技
CTO & TGO 鲲鹏会学员MLPerf 是由图灵奖得主大卫·帕特森(David Patterson)联合谷歌、斯坦福大学、哈佛大学等顶尖学术机构共同发起的国际权威 AI 性能基准测试,被誉为全球 AI 领域的“奥运会”。MLCommons 组织在 2023 年首次推出了 MLPerf 存储基准测试(MLPerf Storage Benchmark),这是首个也是目前唯一一个开源、公开透明的 AI/ML 基准测试,旨在评估存储系统在 ML/AI 工作负载中的表现。这一基准测试为 ML/AI 模型开发者选择存储解决方案提供了权威的参考依据,帮助他们评估合适的存储产品。2024 年 9 月 25 日,最新 MLPerf Storage v1.0 Benchmark 结果(https://mlcommons.org/benchmarks/storage/)发布。本次演讲重点介绍 MLPerf Storage Benchmark 工具是如何模拟 ML/AI 模型,AI 存储要如何优化才能更好的满足 ML/AI 工作负载对性能的要求。
演讲提纲:
- MLPerf 历史背景介绍
- MLPerf Storage Benchmark 3 类模拟模型的介绍
- 分析 IO 模型和对存储的挑战
- MLPerf Storage Benchmark 测试数据解读
- 常见的优化解决方案
听众收益:
- 了解 MLPerf Storage Benchmark 工具的作用
- 了解 ML/AI 工作负载的 IO 类型
- 学习如何选型智算中心存储解决方案
by 王天庆
贝壳找房
容器团队负责人随着大模型的广泛应用和种类的增加,企业对 GPU 算力的需求日益增长。然而,GPU 资源的异构性、跨多云及跨地域部署的复杂性,使得资源利用效率面临严峻挑战。企业亟需解决如何高效分配算力资源并提升利用率的问题,以支持大模型的快速发展和业务场景的实际落地。
为应对这一挑战,我们基于云原生技术,以 Kubernetes 为核心,构建了一个支持多租户的一站式机器学习平台。该平台不仅实现了统一的资源调度和存储管理,还能方便用户快速获取多种算力资源,同时支持用户将闲置资源出借以创造额外收益。从技术运营和技术深度两个层面,这一方案全面提升了算力资源的利用效率,为企业提供了强有力的支撑。
本次演讲将从两个方面展开,一是多租户环境下的算力分配策略,二是提升算力利用率的方法。
演讲提纲:
- 贝壳机器学习平台AIStudio背景介绍
- 产品定位与核心功能
- 算力效率低下的元凶
- 算力资源壁垒
- GPU利用率低并长期闲置
- GPU资源碎片化
- 多租户下算力分配
- 分配机制
- 算力的精细化分配(机器维度、卡维度、算子)
- 算力运营
- 多角度提高算力利用率
- 统一资源池化调度
- 数据调度(基于JuiceFS的存储底座、数据编排和亲和性调度)
- 联邦调度(训练任务、推理服务)
- 闲时复用(虚拟节点、潮汐调度)
- GPU碎片资源优化
- 总结与展望
听众收益:
- 提供了一种适用于企业内部的高效算力分配方案,从技术运营的视角提出了促进算力循环利用的策略,显著降低企业算力成本
- 针对大模型应用场景,阐述其与传统流量调度的核心差异,并明确优化方向,为资源调度提供更具针对性的解决方案
关注主办方(InfoQ)
联系我们
交通指南
北京丰大国际大酒店
Beijing Fengda International Hotel
地址:北京市大兴区荣华中路20号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手