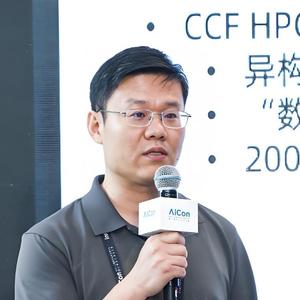
主要负责异构算力集群优化与推理优化 (包括大模型,搜广推等)。有 190+ 中 / 美技术专利,技术领域涉及异构加速,虚拟化,大模型推理优化以及文件系统,企业级存储等。CCF HPC 和存储专委委员,曾在 NVIDIA GTC, CCF HPCChina,LinuxConf, Hadoop Summit, SNIA SDC,Dell EMC World, DataFun 等做技术分享,同时也是“数据密集型应用系统设计” 译者。
讲师介绍
议题介绍
地点:天山厅
所属专题:大模型在企业中的成本优化实践
演讲:大模型推理—显存管理深入优化探索
训练和部署大模型需要巨大的显存资源。为了缓解 OOM 问题并实现更高性能,我们将分享显存优化方面的挑战分析和最新探索,重点包括 vTensor 和 LayerKV 两个方案。
首先,vTensor:一种新 tensor 数据结构,作为 PagedAttention 的替代方案,为模型提供始终连续的虚拟地址。vTensor 可以高效解决推理 KV cache 碎片问题;更重要的是,集成或定制高级 attn kernel(例如 FlashAttn3, 稀疏和量化等)变得非常简单,只需更改 3 行代码几分钟内即可搞定 (对比 vLLM 需要数周时间);
其次,layerKV: 通过细粒度的 layer-wise 显存管理和 CPU offloading,在 QPS 基本持平情况下,可降低高负载下首字延迟多达 69x。
vTensor 和 layerKV 基于 PyTorch、vLLM 实现。对模型透明,精度无损,可以与量化、压缩等有损方案配合使用。本次演讲将分享这些技术实践。
演讲提纲:
- 大模型推理显存挑战
- 显存优化探索
- CUDA VMM
- vTensor: 优化 KV Cache 管理
- LayerKV: 优化 TTFT
- 总结与展望
听众收益:
- 了解大模型显存优化的典型策略和手段,包括有损、无损等
- 理解通过精度无损的优化手段实现敏捷迭代和首字优化:vTensor 可更轻松定制开发 attn kernel(例如集成 FlashAttn3, FlexAttn 等);以及 layerKV 通过细粒度的显存管理来显著降低首字延迟
关注主办方(InfoQ)
联系我们
交通指南
北京丰大国际大酒店
Beijing Fengda International Hotel
地址:北京市大兴区荣华中路20号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手