专题深入探讨大模型的需求分析与数据收集、数据清洗与增强、模型评测与优化,以及技术... 展开 >
大模型数据集构建及评测技术落地
会议室:钻石厅 A出品人:杨熙
- Topic 1
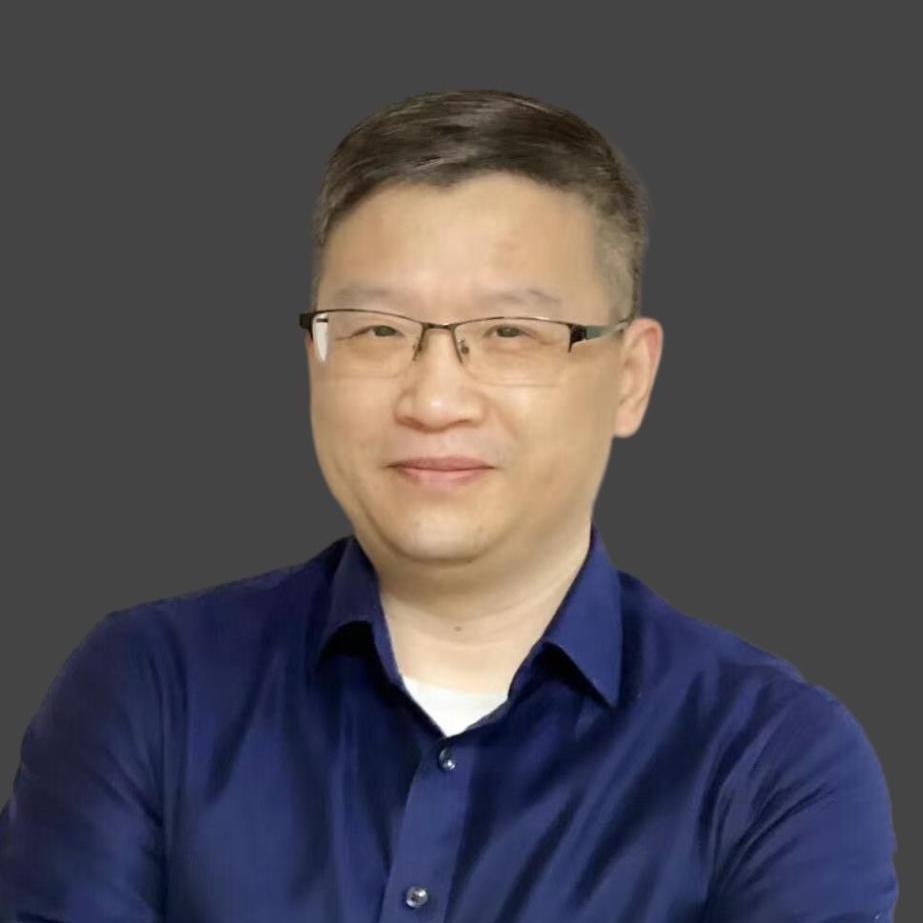
周华
智源研究院 大模型行业应用总监 - Topic 2
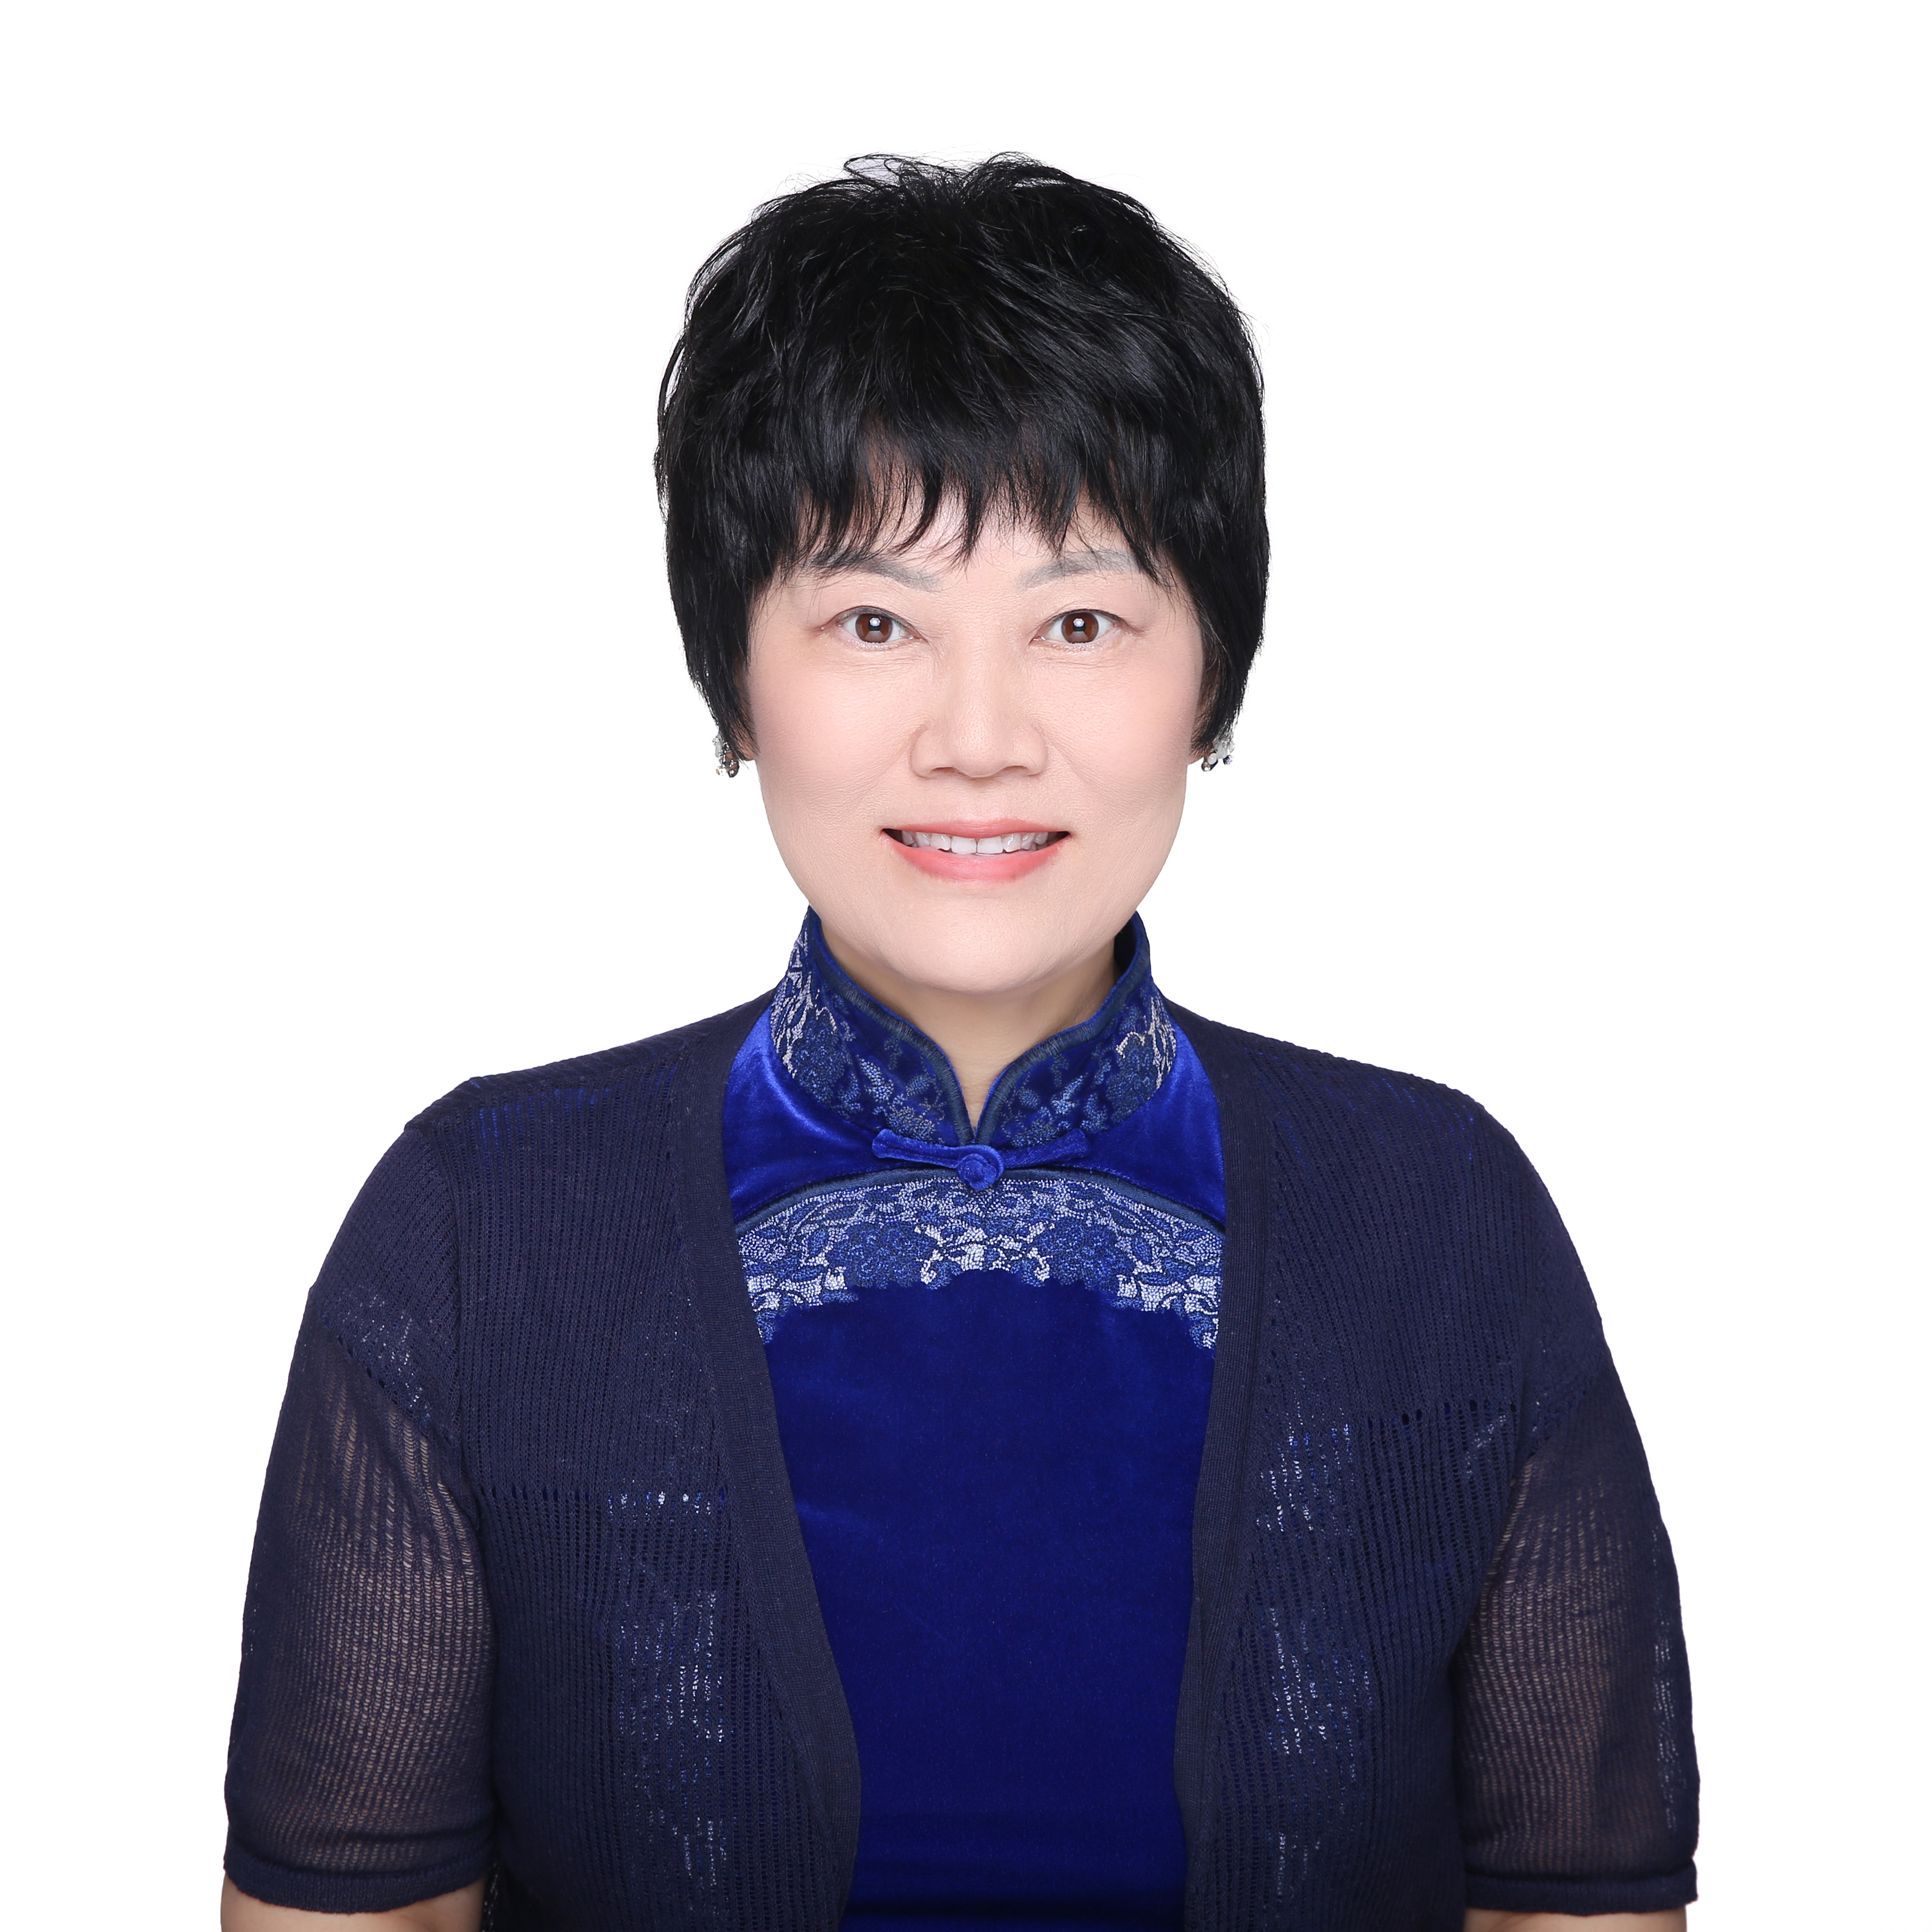
张铭
北京大学 二级教授 - Topic 3
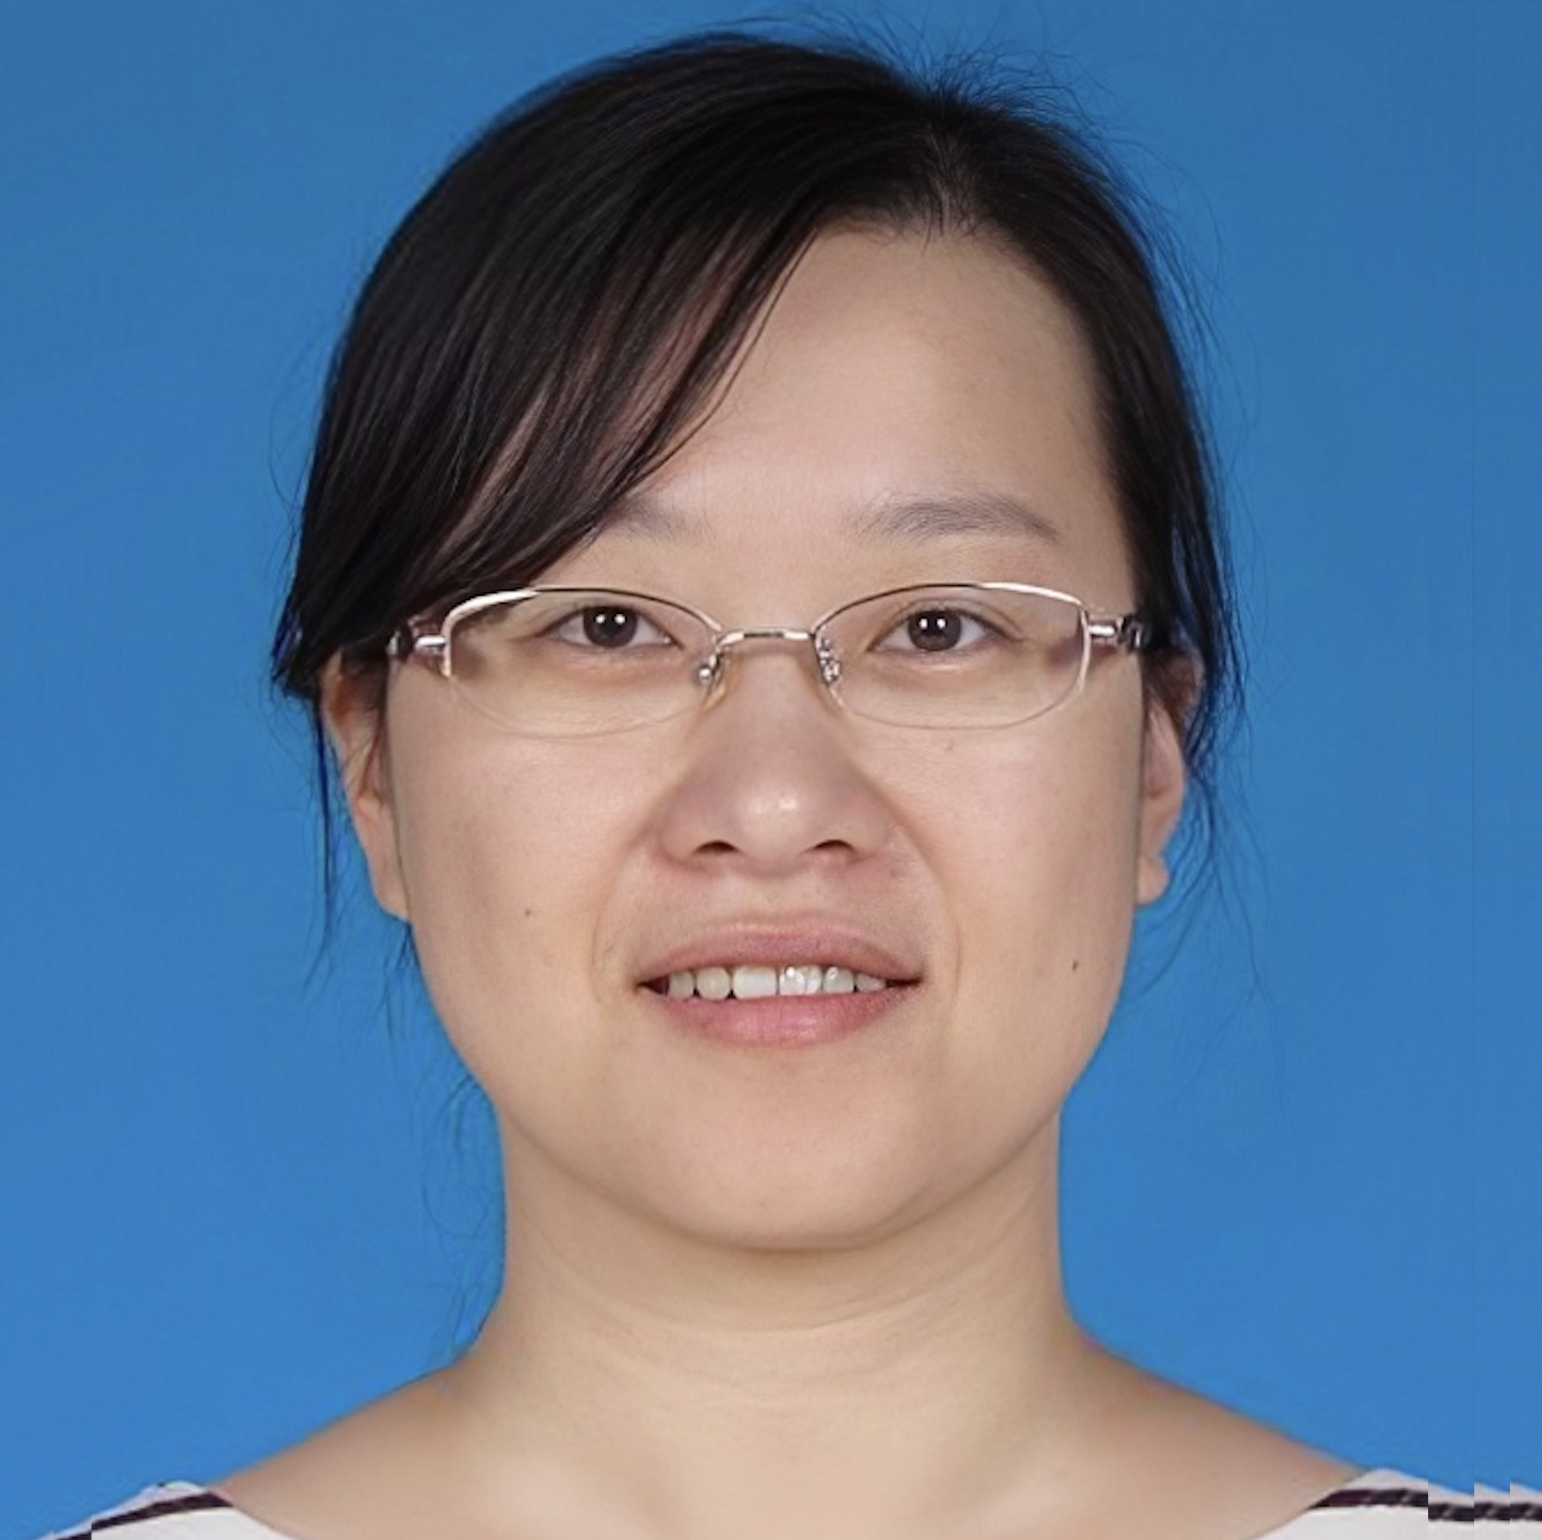
杨熙
智源研究院 智能评测组负责人 - Topic 4
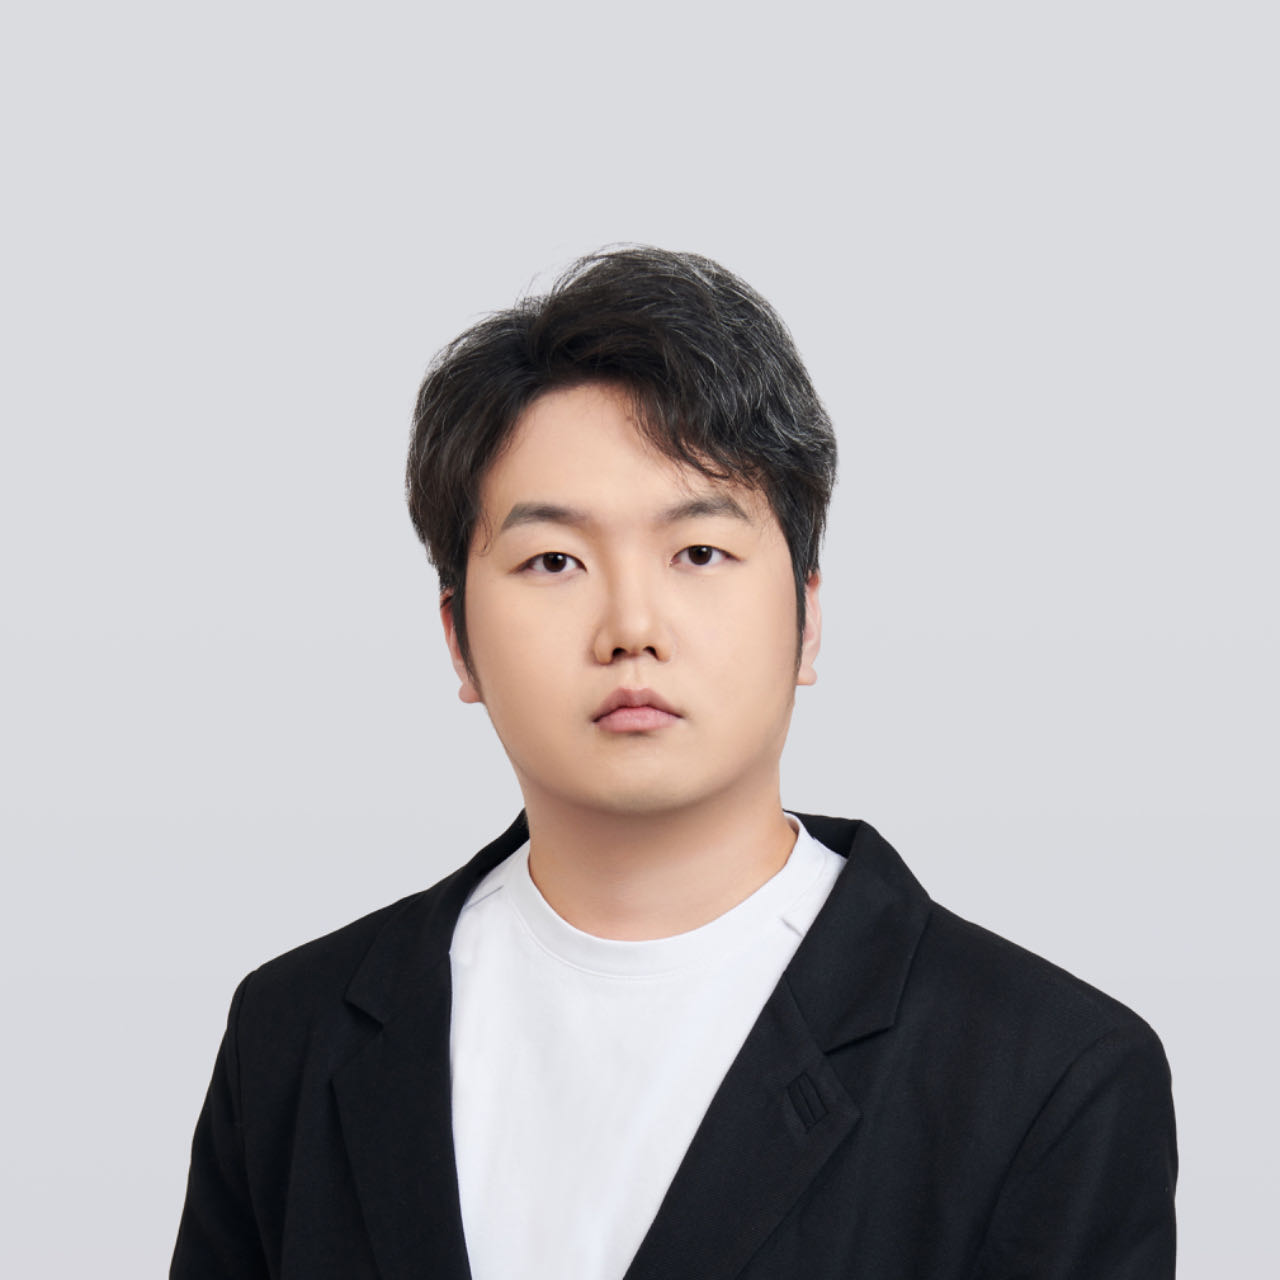
Panda
熊墅科技 CEO
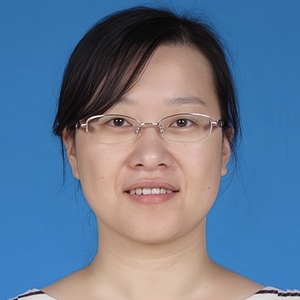
专题出品人:杨熙
智源智能评测组负责人
北京大学博士,中科院计算所博士后。FlagEval 核心贡献者,主要研究多领域、多维度的基础模型评测方法及工具。
地点:钻石厅 A
专题:大模型数据集构建及评测技术落地
专题深入探讨大模型的需求分析与数据收集、数据清洗与增强、模型评测与优化,以及技术落地与维护等关键方向。通过分享高效数据收集方法、先进的数据清洗与增强技术、全面的模型评测与优化策略,以及实际应用中的部署经验,旨在帮助你全面掌握从数据构建到模型评测与优化的全流程技术,推动大模型技术在各行业的应用与创新。
by 周华
智源研究院
大模型行业应用总监近年来,闭源大语言模型(LLMs)和开源社区在通用领域取得了显著进展,甚至在某些方面超越了人类。然而,在医学、政务等专业领域,语言模型的表现仍然不足。
面对决这些挑战,智源研究院致力于推进人工智能大模型在行业应用方向上的最后一公里进程,通过行业合作伙伴联合实验室机制,基于行业数据集构造和示范模型训练实践,提出了数据集构建技术体系,以及包含持续预训练、监督微调(SFT)以及强化学习(RLHF)技术的完整行业模型训练范式,获得了良好的模型性能效果,在大模型行业应用的落地方面为从业者和用户提供有益的参考。
演讲提纲:
- 人工智能大模型在行业落地发展的概括和问题分析
- 智源研究院在大模型行业落地方面的工作思路和研究方向
- 行业数据集构建方法
- 行业模型训练范式
- 实践案例经验分享1:Aquila-Med 示范模型的数据集构建和模型训练
- 实践案例经验分享2:Aquila-SQL 模型的训练和应用
- 总结与展望
听众收益:
- 企业内部大模型构建的方法
- 行业大模型训练的技术经验
- 数据处理的方法和技术体系
by 张铭
北京大学
二级教授现有的数据集主要集中在检验模型解决专家级别难题的能力上,难以反映模型在基础知识方面的掌握情况。由于缺乏和人类表现相关的数据,因此科学家也不可能获取到更具实际意义的模型表现参考,严重阻碍了人工智能的健康发展。
为了攻克这些局限性,我们团队成功构建了首个多模态 STEM 数据集,并且在此基础上实现对大语言模型与多模态基础模型的评测。评测的结果发现,即使是目前最先进的人工智能模型,其 STEM 基础水平也存在较大的提升空间,尚不具备解决更有难度的现实问题的能力。也就是说,与人类智能相比,目前人工智能的水平还有一定差距。此外,团队还提出了一个新的社会学科数据集 Social,包含较大规模的文本评估数据,可用来评测大语言模型的社会学科基础能力;团队还设计了一种多智能体交互的方法,能够增强大语言模型在 Social 数据集上的表现。这些数据集可以进一步推动当前多模态大模型的研究。
演讲提纲:
- 当前视觉多模态大模型评测面临的问题
- 视觉多模态大模型 STEM 数据集与评测方式介绍
- 近期方法在STEM数据集上的评测结果
- 大语言模型社会规范评测数据集 SocialNorm 介绍
- 大语言模型能力提升:SocialAgent 方法介绍
听众收益:
- 了解多模态评测相关进展探索
- 了解大语言模型通用智能体方法进展探索
by 杨熙
智源研究院
智能评测组负责人大型语言模型 (LLMs) 在各种任务中取得了卓越的性能, 并在现实世界中得到了广泛应用。然而,LLMs 容易出现幻觉, 生成与已知知识相冲突或不忠实于原始信息来源的内容,影响了 LLMs 在很过高厉害场景上的应用。现有的幻觉基准主要关注句子或段落层面的幻觉检测, 忽略了对话层面的评估、幻觉定位和原因解析。为了缓解现有幻觉评估的局限性, 我们提出了 HalluDial, 第一个全面的大规模自动对话级幻觉评估基准。利用 HalluDial, 我们对 LLMs 在信息搜索对话中的幻觉评估能力进行了全面的元评估, 并引入了一个专门的判断语言模型 HalluJudge。HalluDial 的高数据质量使 HalluJudge 在幻觉评估中取得了优异或有竞争力的性能, 有助于自动评估 LLMs 中的对话级幻觉, 并为这一现象提供了宝贵的实验验证基础。
演讲提纲:
- 研究背景
- 幻觉问题的定义与危害
- 幻觉检测技术的现状与挑战
- 幻觉检测工具构建
- HalluDail 评测集的构建
- HalluJudge 模型构建
- 实验结果
- 不同大模型的整体表现对比
- 模型在不同类型测试上的得分分析
- 典型案例分析和展示
- 总结与展望
听众收益:
- 深入理解幻觉现象
- 掌握对话级幻觉评估的新方法
- 探索幻觉原因与解决方案
by Panda
熊墅科技
CEO想完成LLM落地的企业和组织往往面临诸多挑战,通用模型并不能很好地完成真实场景中的复杂任务。本次演讲将探讨数据驱动与模型驱动的不同路径,重新解析通用大模型和垂直大模型的区别。通过介绍DataTager的实际案例,来解析半合成数据、数据增强的技术在数据构造阶段的应用,展示如何利用高质量数据提升模型性能,加速大模型在业务中的实际应用。
演讲提纲:
- 当前行业痛点
- Data-centric vs Model-centric
- 重新思考通用大模型和垂直大模型
- 合成数据的概况和风险
- DataTager 的解决方案:半合成数据和数据增强
听众收益:
- 深刻理解数据的重要性:了解高质量数据在大模型训练中的核心作用,以及如何通过优化数据质量提升模型性能
- 掌握实用技术和方法:学习半合成数据、数据增强和数据驱动的技术和方法,提升实际业务应用中的模型效果
- 解决实际问题:通过DataTager的实际案例,学习大模型在具体业务中的落地
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手