本次论坛将全面剖析大模型训练和推理过程中的关键技术与优化策略。我们将深入探讨预训... 展开 >
大模型训练以及推理加速
会议室:钻石厅 A出品人:戴宗宏
- Topic 1
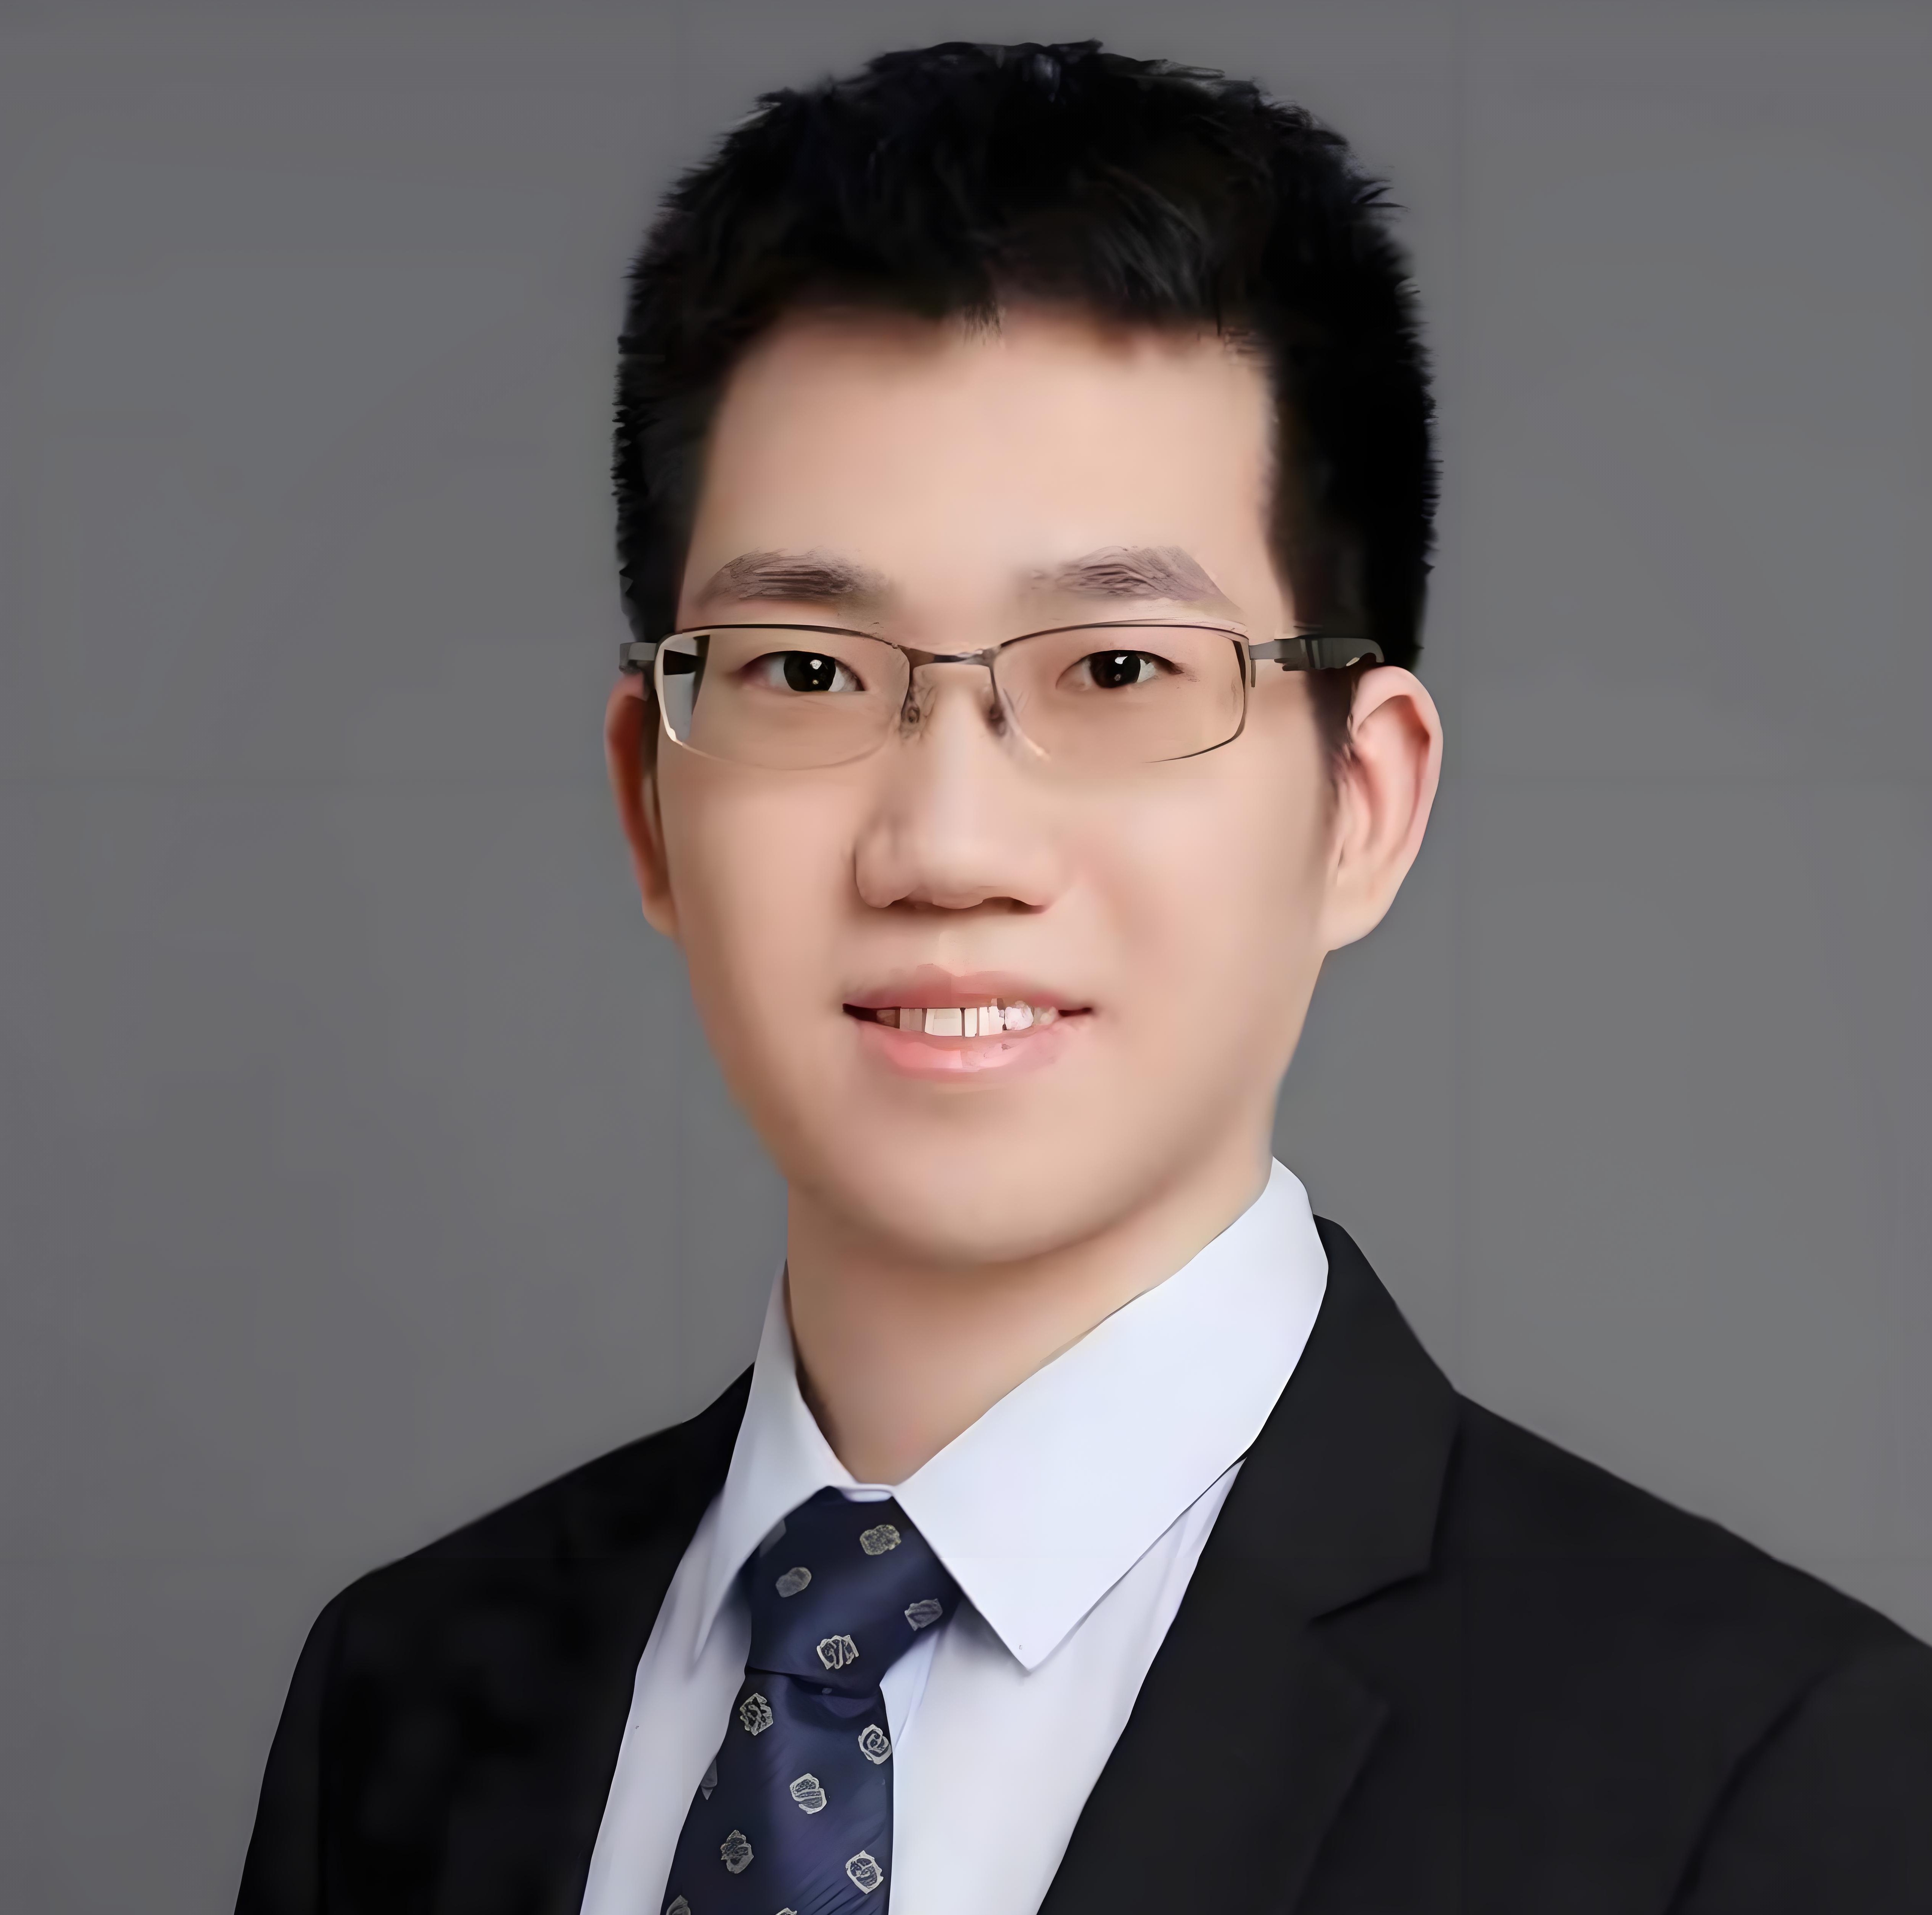
张行程
上海人工智能实验室 AI 训练与计算中心负责人 - Topic 2
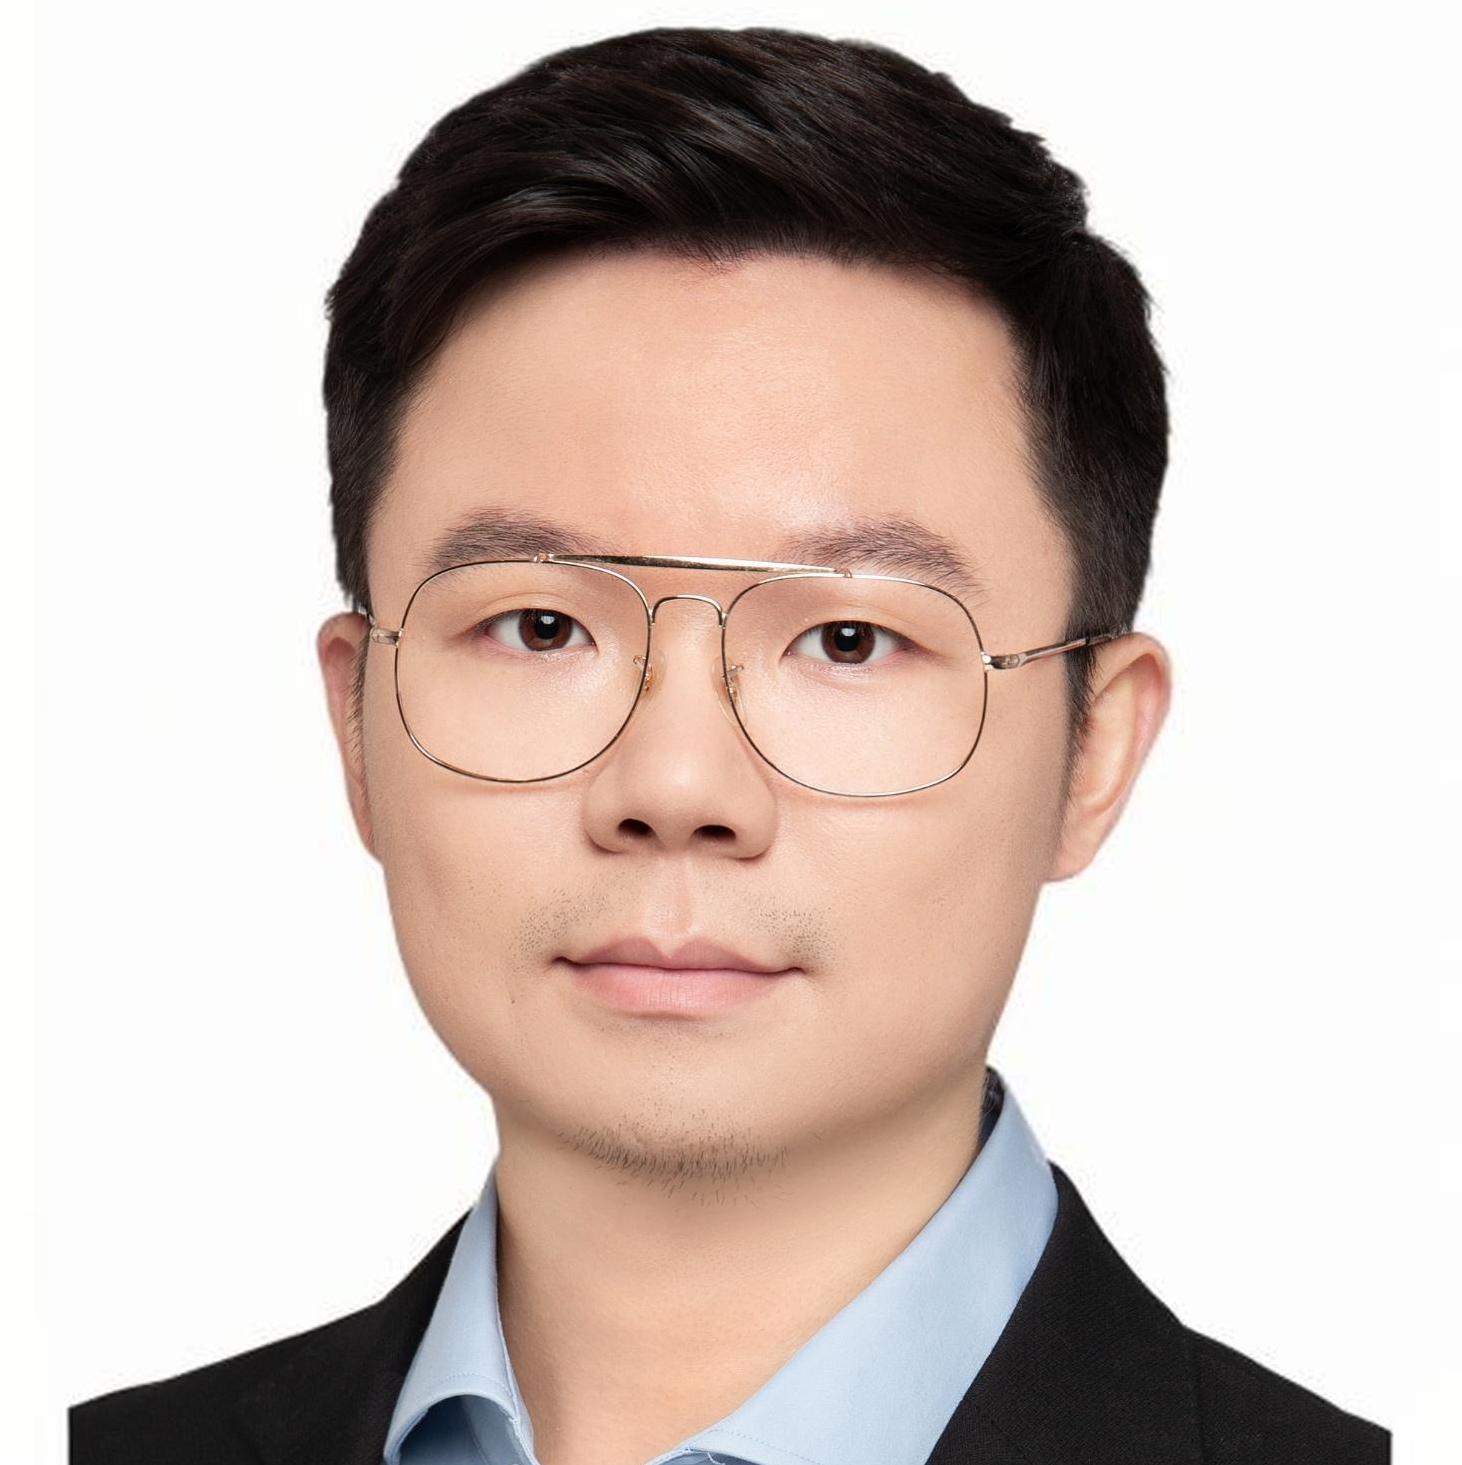
张力寰
零一万物 AI Infra分布式训练优化架构师 - Topic 3
唐飞虎
月之暗面 高级研发工程师 开发者关系负责人 - Topic 4
陈凯
硅基流动 大模型推理云服务负责人
专题出品人:戴宗宏
零一万物联合创始人
目前担任零一万物技术副总裁及 AI Infra 负责人。曾担任华为云 AI CTO 及技术创新部长、阿里达摩院 AI Infra 总监。
地点:钻石厅 A
专题: 大模型训练以及推理加速
本次论坛将全面剖析大模型训练和推理过程中的关键技术与优化策略。我们将深入探讨预训练数据清洗技术、大模型训练框架技术、训练微调方法、训练效率加速方案、大模型量化压缩方案、训练平台容错技术,以及端侧大模型训练和调优技术。与此同时,为提高大模型推理的效率和性能,论坛还将涵盖计算加速、模型压缩、混合精度训练、分布式训练等优化技术。
by 张行程
上海人工智能实验室
AI 训练与计算中心负责人近年来,我国人工智能软硬件均取得了较大发展,逐渐形成了涵盖计算芯片、开源平台、基础应用、行业应用及产品等环节较完善的人工智能产业链。但仍然存在软硬件碎片化的问题,严重阻碍基础设施形成合力,造成当前硬件芯片适配模型支持少、易用性低性能较差、应用场景较为局限的局面。探索人工智能底层技术软硬件适配之路,我国AI芯片待迈出从产线走向应用的坚实一步。本报告介绍实验室对于这一问题的看法、解决思路和技术实践,与参会者共同讨论国产AI生态的破局之道。
演讲提纲:
- 人工智能软硬件适配的困境
- 基于人工智能开放计算体系DeepLink的适配实践
- 初步成效和未来思考
听众收益:
- 深入了解 AI 软硬件生态现状
- 掌握 AI 软硬件适配和性能优化的技术逻辑与原理
- 了解面向大模型的软硬件适配发展方向
by 张力寰
零一万物
AI Infra分布式训练优化架构师本次演讲主要介绍千亿模型训练过程中的训练优化实践经验,如何在 MFU 和 Goodput 两个维度提升模型训练的效率。其中包括分布式训练策略、异步存储 CKPT、FP8 训练经验分享、MOE 训练优化分享等。
演讲提纲:
- 模型训练硬件利用率影响因素
- 提升分布式训练效率
- 异步存储 CKPT
- FP8 训练经验分享
- MOE 训练经验分享
- 总结与展望
听众收益:
- 了解大模型训练优化方法
- 了解 FP8 训练相关经验
- 了解 MOE 训练相关经验
by 唐飞虎
月之暗面
高级研发工程师 开发者关系负责人本次分享将介绍 Kimi 智能助手背后的推理加速方案,以 KVCache 为中心的分离式推理架构,以及在设计时所需要考虑的指标和在真实生产环境中部署的表现。
演讲提纲:
- 介绍 Kimi 智能助手相关简介
- 介绍长文本大模型推理中所遇到的挑战
- 介绍围绕 KVCache 相关的推理优化技术
- 介绍设计分离式推理架构设计时需要权衡的指标
- 线上实际推理结果和测试数据集的表现
- 总结与展望
听众收益:
- 了解一线C端应用的推理实践指导生产,以及 KVCache 相关的长文本推理的相关技术。
by 陈凯
硅基流动
大模型推理云服务负责人大模型推理是大模型应用的重要一环,随着模型尺寸越来变大,应用越来越普及,如何构建一个开发者用得起的模型服务至关重要,为此硅基流动设计了多模态和大语言模型的加速套件,并基于此构建了大模型推理云 SiliconCloud,以提供高性能低成本的推理服务。本演讲分享高性能低成本的大模型推理云的设计思考和最佳实践。
演讲提纲:
- 大模型推理加速背景与挑战
- 硅基流动大模型推理云 SiliconCloud 加速方案
- 多模态加速
- 大语言模型加速
- 云上的演化
- 总结与展望
听众收益:
- 了解 AI Infra 中推理加速的价值和常用方案
- 了解 AI Infra 推理云的实践方案
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手