检索增强生成( Retrieval - Augmented Generation... 展开 >
RAG 检索与生成落地实践
会议室:万豪宴会厅 2出品人:郭瑞杰
- Topic 1
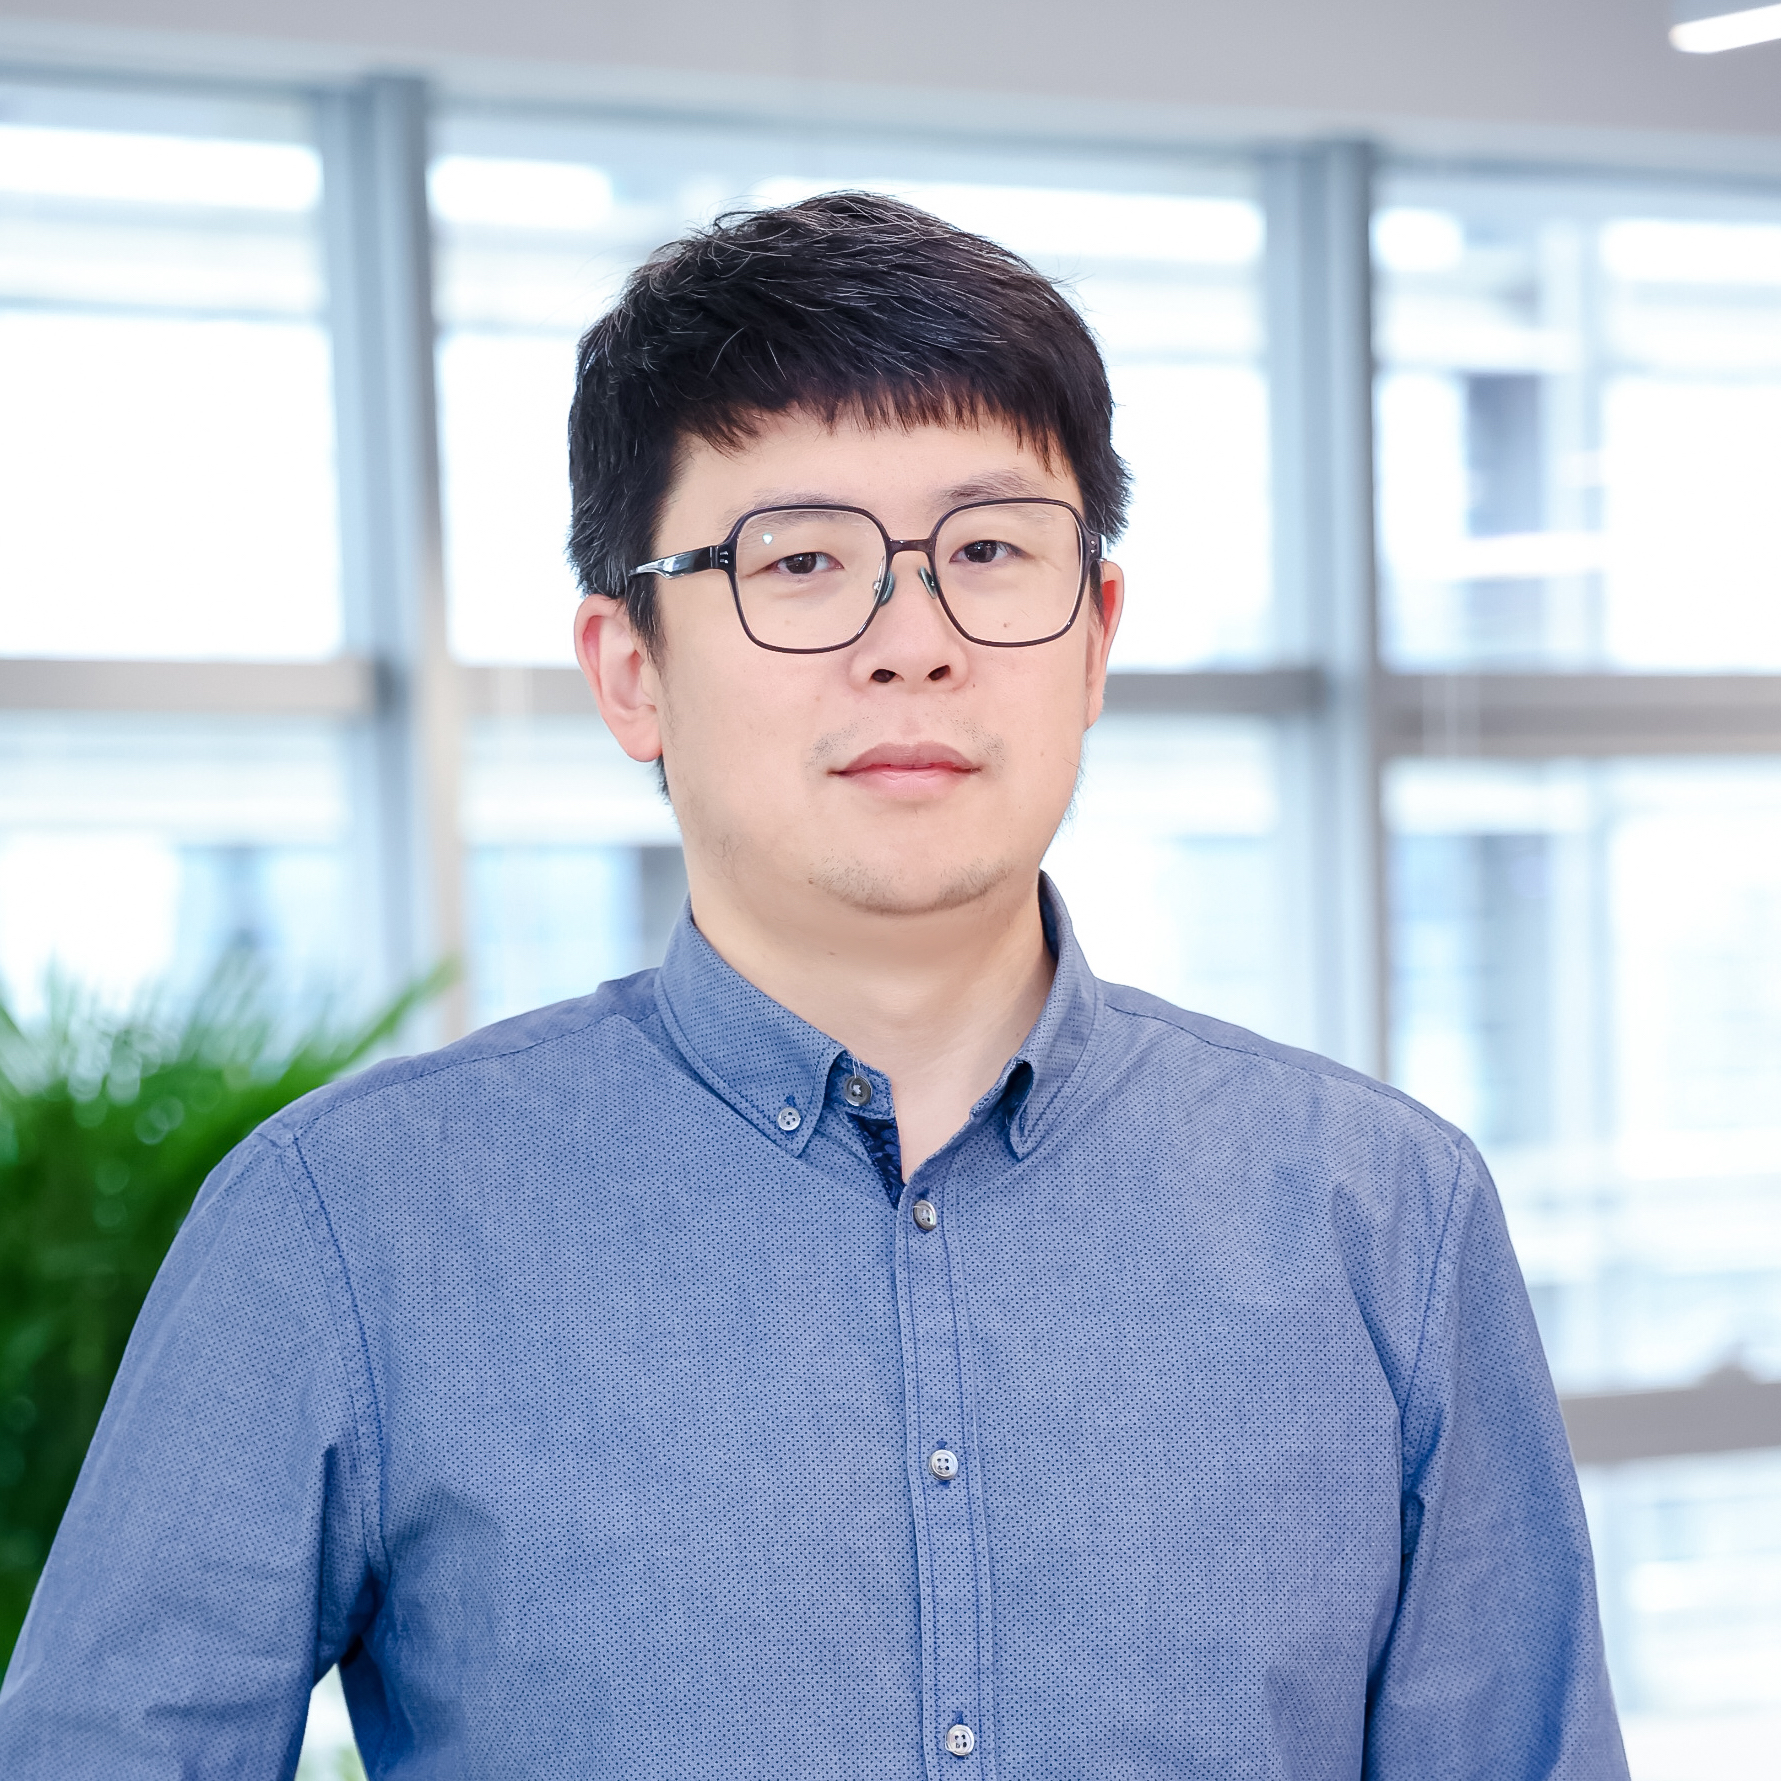
柴思远
智谱 企业商业技术中心的总经理 - Topic 2
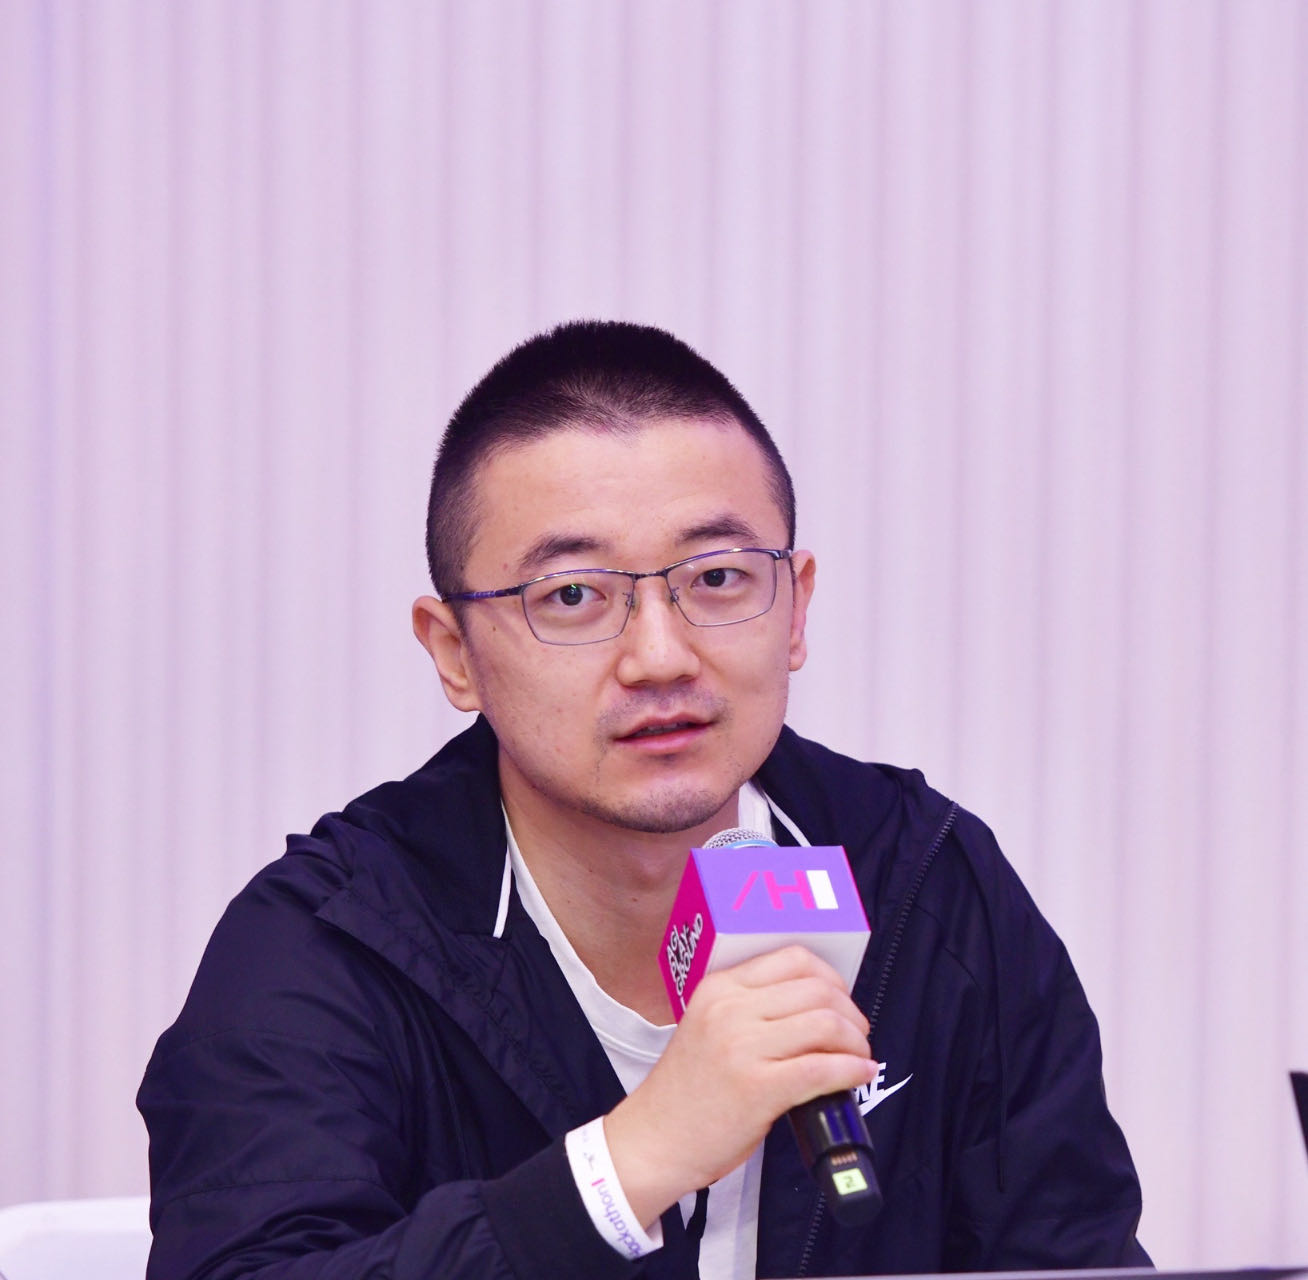
张硕
vivo 互联网产品平台 架构团队负责人 - Topic 3
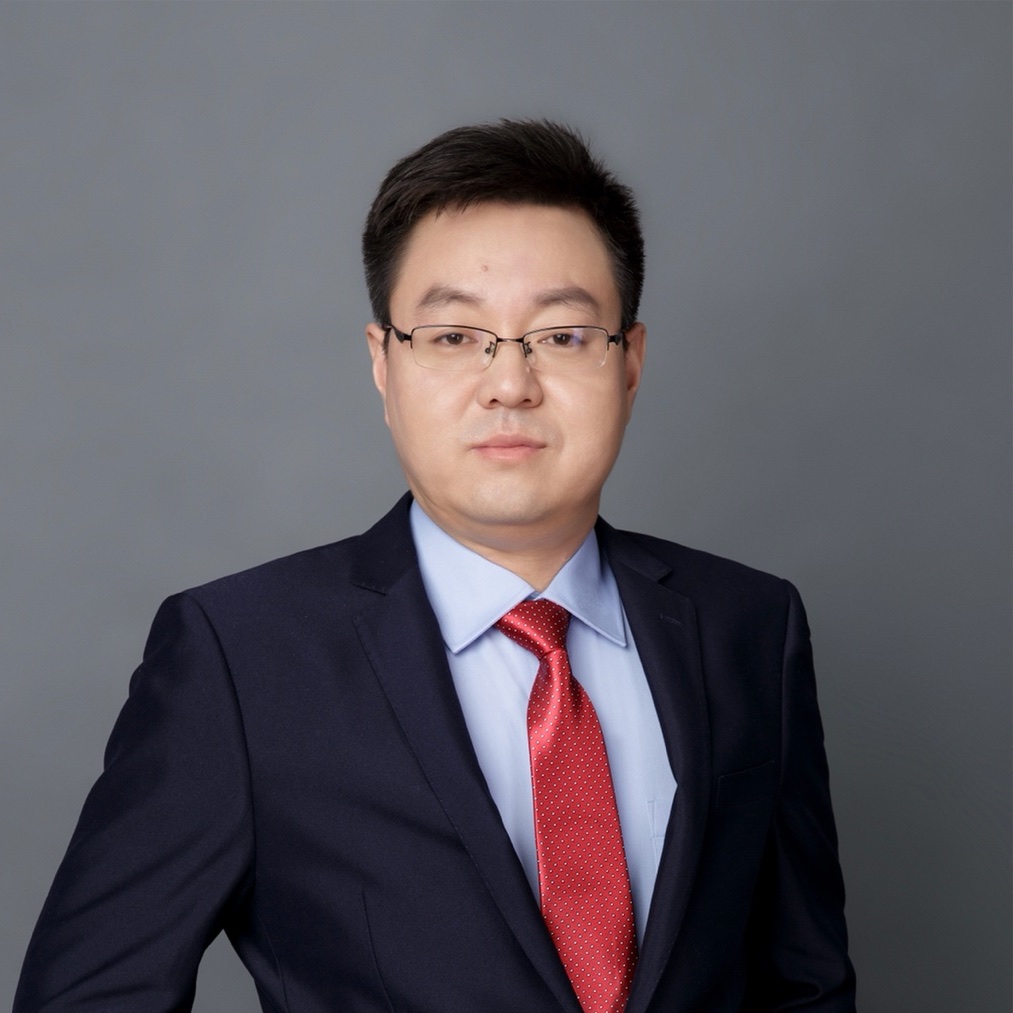
邢少敏
阿里巴巴 OpenSearch 研发负责人 - Topic 4
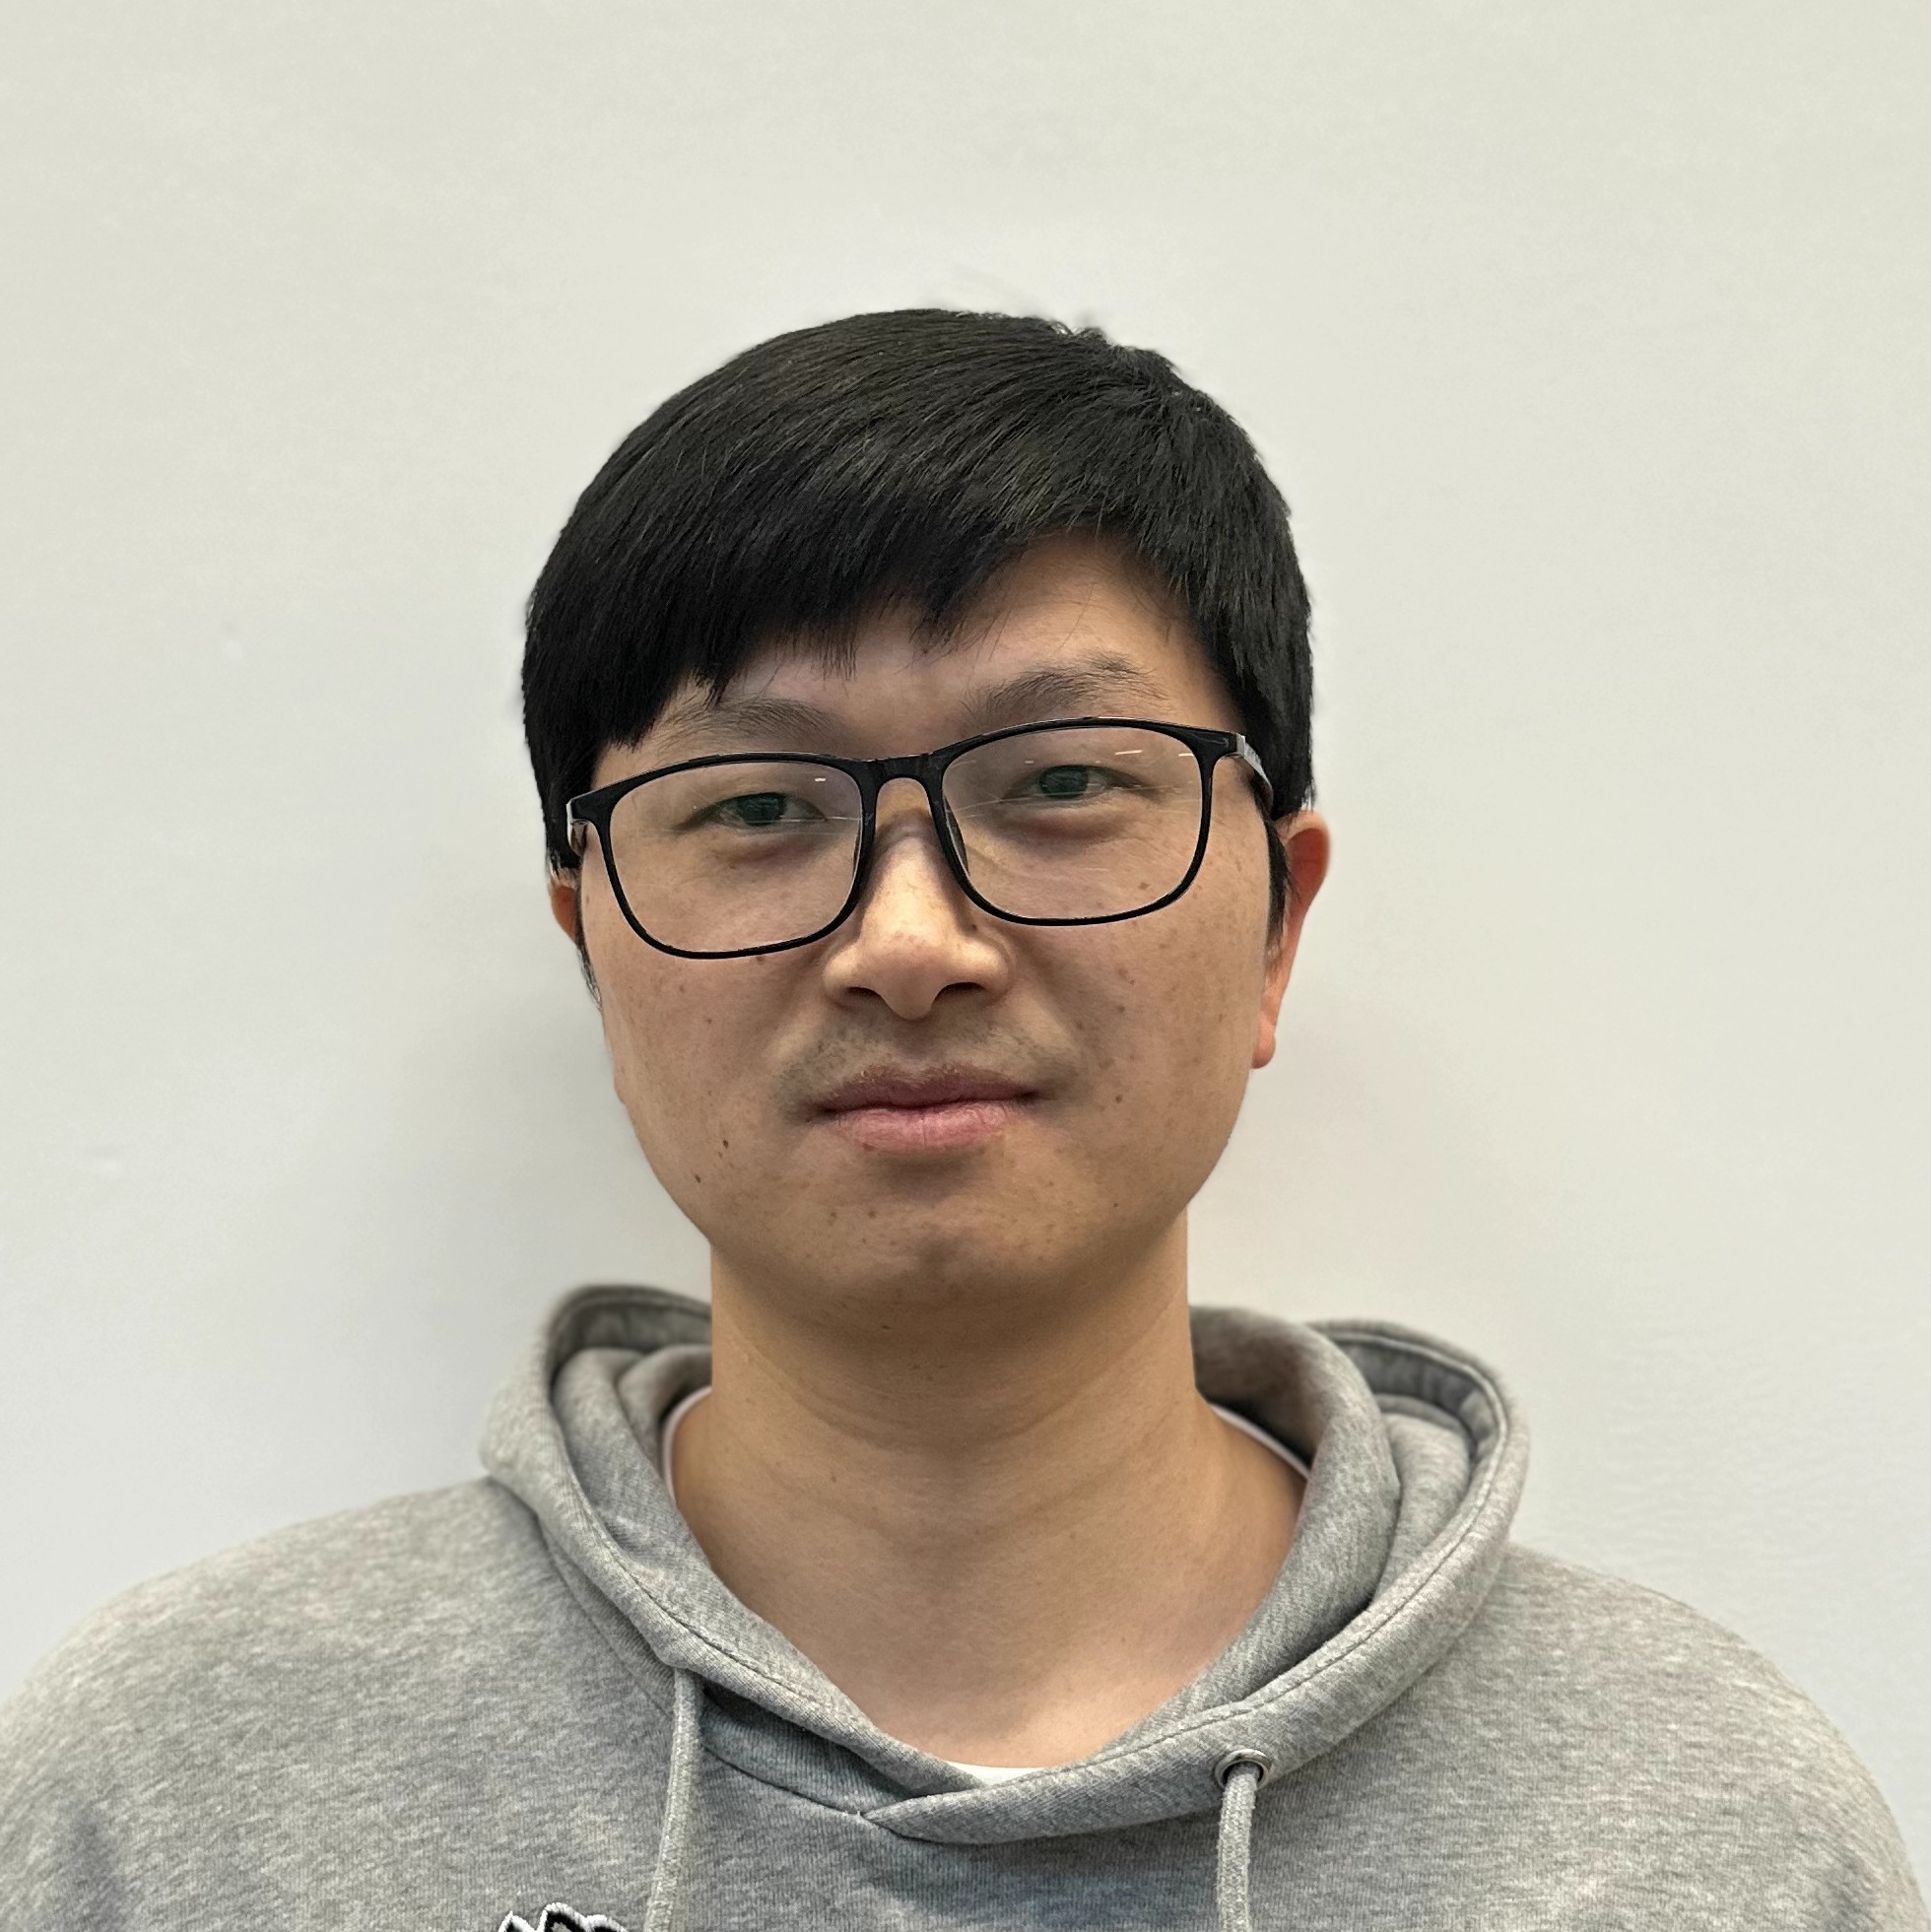
许文敏
火山引擎 A/B测试平台 前端负责人 - Topic 5
王文广
达观数据 副总裁 - Topic 6
唐飞虎
月之暗面 高级研发工程师 开发者关系负责人 - Topic 7
王峰
Jina AI 研发总监
专题出品人:郭瑞杰
阿里巴巴总监 & TGO 鲲鹏会学员
专注搜索和大模型 RAG 应用平台建设,阿里巴巴搜推广工程体系 AI . OS 早期开拓者,曾负责阿里巴巴 iSearch 、HA3 前后几代搜索引擎的架构设计和开发工作,现负责阿里巴巴集团搜索中台业务、阿里云搜索产品线,以及搜索引擎 Havenask(HA3) 开源项目。创建了 OpenSearch LLM 智能问答 ( RAG )、阿里云 Elasticsearch 、智能推荐 AlRec 和图计算等云产品。
地点:万豪宴会厅 2
专题:RAG 检索与生成落地实践
检索增强生成( Retrieval - Augmented Generation , RAG )技术是解决大语言模型幻觉问题、知识更新等难题的有效方法,在学术和工业界得到广泛的关注,并迅速成为研究和应用的热点。本专题将深入分析 RAG 技术在实际应用中遇到的挑战及应对策略。我们将详细讨论如何构建高效的 RAG 系统,包括如何优化信息处理和信息检索的策略,如何提升生成模型的训练和微调效果,以及如何降低 RAG 应用的实施成本等。此外,本专题还将讨论 RAG 在不同行业和场景中的创新应用,呈现在实际工业应用中的最佳实践案例。
by 柴思远
智谱
企业商业技术中心的总经理演讲提纲:
- 大模型 RAG 技术的原理
- 智谱 GLM RAG 技术的应用场景
- 智谱 RAG 技术的挑战
- 智谱大模型 RAG 技术的效果策略
听众收益:
- 了解 RAG 的价值与挑战
- 了解 RAG 的在各行各业的应用场景
by 张硕
vivo
互联网产品平台 架构团队负责人vivo 蓝心九问是一个旨在为 vivo 互联网业务场景,提供 AI 智能体解决方案的一站式平台。平台具备高质量、零代码、可视化 AI 智能体的构建及运营管理能力,高效满足各业务定制化的AI智能体需求。
演讲提纲:
- 蓝心九问产生背景
- 产生背景及面临的场景挑战
- 蓝心九问核心技术方案
- 自研 RAG 实践方案
- Agent 智能体的实践方案
- 行业技术挑战及自研解决方案
- 典型案例分析
- 商业化内容生成
- 客服咨询助手
- 企业内部办公提效
听众收益:
- 大模型在企业应用的技术方案和适用场景
- 大模型应用过程中有哪些挑战和应对方法
- 大模型在企业应用的心得与方法
by 邢少敏
阿里巴巴
OpenSearch 研发负责人本文介绍了 RAG 发展历程、技术原理,并以阿里巴巴搜索产品 OpenSearch 为例,探讨搜索产品如何以 RAG 为切入点,构建一站式对话式搜索服务,以及知识问答场景下的实践经验,同时如何构建面向开发者的 RAG 技术平台。
演讲提纲:
- RAG 产生背景
- RAG 技术原理
- 一站式 RAG 服务实践
- RAG PaaS 平台实践
- RAG 总结和展望
听众收益:
- 了解 RAG 技术难点、最佳实践和应用场景
- 了解 OpenSearch RAG 的技术价值
by 许文敏
火山引擎
A/B测试平台 前端负责人A/B 实验平台目前支撑了字节跳动大部分商业化场景,同时也面向 ToB 多个行业进行外部服务,目前字节内部每天都在运行很多实验,这些实验效果的好坏,都需要通过数据分析师来进行分析。如何让业务的一线产品、运营、开发能够直接了解实验的效果和归因呢?我们引入了 LLM 的 Finetuning,来学会数据科学家的经验,实现对一线用户的实验分析提效。
于此同时,在 ToB 企业应用场景中,如何让没有 AB 经验的用户能够高效的开启实验,我们利用 RAG+LLM 来解决客户的实验咨询以及实验创编的效率。
演讲提纲:
-
业务背景 & 问题
-
字节 A/B 实验平台介绍
-
当前 A/B 实验平台面临的问题
-
-
问题分析 &LLM 方案设计
-
问题分析
-
如何提升实验报告的分析效率
-
如何降低实验创建的门槛
-
-
LLM 方案设计
-
如何设计 RAG 技术链路
-
如何设计 Finetuning 技术链路
-
如何设计 badcase 评估链路
-
-
-
LLM 在业务的结合与落地
-
LLM 与字节对内业务的结合
-
LLM 与 TOB 业务的结合
-
LLM 业务落地数据
-
-
LLM 业务规划
-
场景探索
-
技术优化
-
听众收益:
- 了解 LLM 在业务里面怎么落地
- 了解 RAG+Finetuning 的基本使用
- 了解 A/B 实验如何提升 LLM infra 效率
by 王文广
达观数据
副总裁随着人工智能的快速发展,大模型在自然语言处理、图像识别、语音处理等领域取得了突破性的成果。然而,随之而来的问题是大模型的可控性问题。大模型往往具有巨大的参数量和复杂的结构,导致其决策过程难以理解和解释。这给其在实际应用中带来了挑战。本次演讲将从大模型相关技术和幻觉问题为切入点,探讨如何利用知识图谱技术提高大模型的可解释性、可操作性和可控性。
演讲提纲:
- 大模型的幻觉和知识更新问题
- 知识图谱、RAG 和大模型融合的技术路线
- 大模型的可控生成
听者收益:
- 了解达观数据的前沿技术和成果
- 理解大模型的可控性和知识更新的挑战
- 了解知识图谱和 RAG 技术
- 深入大模型的可控生成方法
by 唐飞虎
月之暗面
高级研发工程师 开发者关系负责人Long-Context 模型是否有潜力替代 RAG(Retrieval-Augmented Generation)是在人工智能领域备受关注的话题。在这次演讲中,我们将深入分析两种技术的发展历程、性能对比、以及如何在实际应用中找到最佳的平衡点。
本次演讲将回顾 Long-Context 技术的发展。这种技术旨在处理和理解长文本数据,通过增强模型的上下文理解能力,使其能够更好地处理复杂的语言任务。接着,我们将比较 Long-Context 与 RAG 技术的性能。RAG 模型通过检索相关信息来辅助生成,而 Long-Context 模型则直接在模型内部处理长文本。我们将讨论这两种方法在不同场景下的优势和局限性。然后,我们将介绍 KV Cache 技术,这是一种优化 Long-Context 模型推理性能的关键技术。KV Cache 通过缓存关键信息,显著提高了模型处理长文本时的效率和速度。最后,我们将探讨在实践开发中如何权衡这两种技术。我们将讨论在不同的应用场景和需求下,如何综合使用 RAG 和 Long-Context 技术来优化产品性能。这将涉及到对两种技术的深入理解,以及如何在实际项目中做出明智的技术选择。
演讲提纲:
- 大模型 Long-Context 技术的发展
- Long-Context 与 RAG 技术的性能比较
- KV Cache 技术是什么?如何帮助 Long-Context 优化推理性能问题
- 实践中的 trade-off,如何综合使用两种技术优化产品。
听众收益:
- 了解 RAG 和 Long-Context 技术各自的背景与挑战
- 了解 Long-Context 技术的优化技术
- 了解实践开发大模型产品中如何在两种技术中进行权衡
by 王峰
Jina AI
研发总监在整合大型语言模型(LLM)到我们的业务流程时,企业经常会遇到一些头疼的问题,比如怎样保持数据的时效性、避免幻觉现象,以及如何保护数据安全。为了解决这些问题,检索增强生成(RAG)技术应运而生,它不仅帮助我们克服了这些挑战,还引领了信息检索的新方向。虽然 RAG 系统及其科普非常流行,但在实际使用中,我们发现它“入门容易,精通难”。目前,业界的讨论主要集中在如何改进内容提取、文档分块,以及 Embedding 模型等技术,但很少有人提到提升搜索准确度的关键步骤——那就是重新排名(Reranker)。我们将结合实际的项目经验,分享 Jina AI 是如何打造更高质量,更快的速度的 Reranker 模型。 从而将 Reranker 整合到 RAG 应用中可以显著提高生成答案的精确度。
关注主办方(InfoQ)


联系我们
交通指南
北京乐多港万豪酒店
Beijing Marriott Hotel Changping
地址:北京市昌平区南口路29号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手