为了促进大模型技术的健康发展和广泛应用,产学研结合的模式显得尤为重要。我们诚挚邀... 展开 >
大模型产学研结合探索
会议室:钻石厅 B出品人:杨萍
- Topic 1
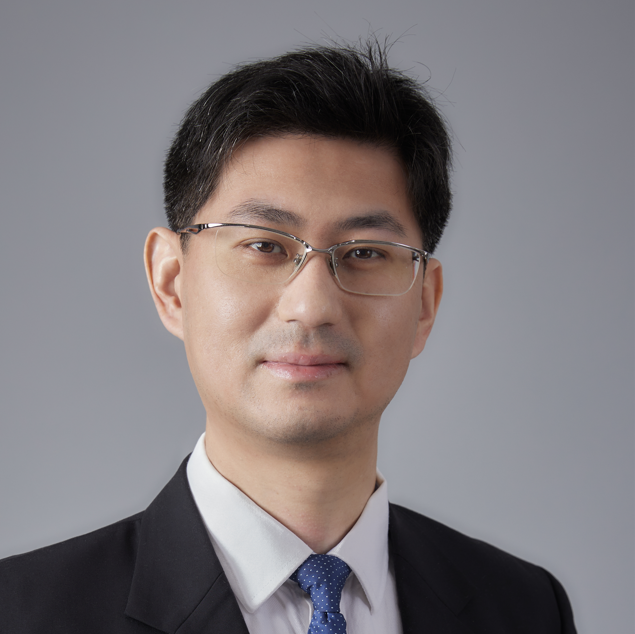
林云
上海交通大学 计算机科学与工程系 副教授 - Topic 2
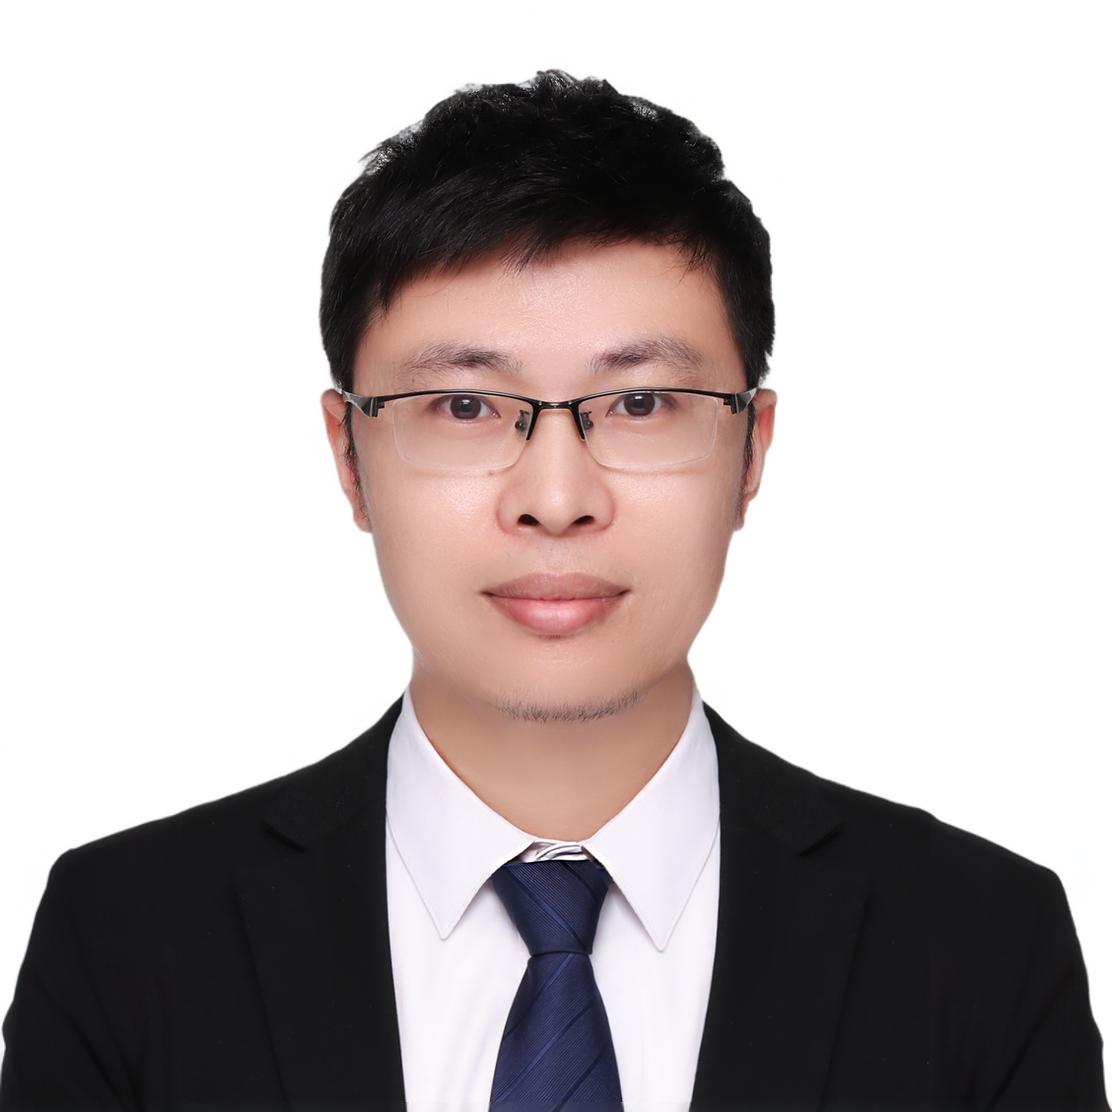
蔡华
华院计算 大模型算法负责人 - Topic 3
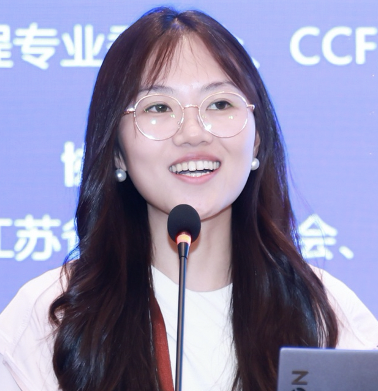
娄一翎 博士
复旦大学 计算机科学技术学院 青年副研究员
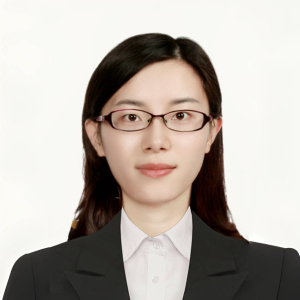
专题出品人:杨萍
字节跳动 Code AI 团队技术负责人
负责代码相关基础技术与智能化建设,曾带领团队孵化并落地多个行业领先的端质量产品,如 Fastbot、SmartEye 等产品。现对当前 AI 技术在提升研发效率方面的应用有深入的理解和洞见。
地点:钻石厅 B
专题:大模型产学研结合探索
为了促进大模型技术的健康发展和广泛应用,产学研结合的模式显得尤为重要。我们诚挚邀请以下领域的专家学者和行业领袖参与本专题:
- 学术研究领袖:分享大模型的最新研究成果,探讨理论基础和技术创新。
- 产业实践先锋:介绍大模型在不同行业的实际应用案例,分析成功经验和面临的挑战。
- 政策与法规制定者:讨论大模型技术的发展对政策和法规的影响,以及如何制定相应的指导原则。
by 林云
上海交通大学
计算机科学与工程系 副教授语言模型正在变革软件开发流程的各个环节,包括了代码的生成、编辑、测试、调试等活动。在开发和训练代码语言模型时,人们需要统一的收集清理数据、训练模型、更新调整等。因此,我们预期,针对模型训练的分析技术将成为新的一层架构来回答“模型是如何产生某个预测的”、“模型预测是如何逐渐训练得到的”、以及“我们应该怎么做去修改和增强某个预测”等问题。
本次演讲以我们 ISSTA’24 的代码编辑工作(一个全项目感知的交互式编辑定位于生成工作)为案例,介绍我们如何分析模型、追溯训练样本、并构建数字孪生环境来测试代码编辑模型。最后演讲将展望 AI 时代,大模型对软件开发范式的影响。
演讲提纲:
- 语言模型在开发任务上的应用与训练范式
- 模型训练中的可解释问题和挑战
- 案例研究:基于语言模型在交互式代码编辑技术
- 面向代码训练的可解释与验证技术
- 训练数据溯源
- 代码深度表征分析
- 数字孪生的模拟编程场景
- 未来技术发展展望
听众收益:
- 通过了解可解释 AI 技术来分析、理解和调试自己所训练的深度模型
by 蔡华
华院计算
大模型算法负责人随着大语言模型(LLM)在自然语言处理和法律推理中的突破性进展,我们正迎来一个法律科技变革的新时代。法律大语言模型能够理解、生成和分析法律文本,全面提升法律服务的效率和公平性。如何将法律大语言模型的认知智能和推理智能应用到行业中,从事更多智能化、精准化的法律服务,是法律科技的重要方向。
在本次分享中,我们将介绍华院计算法律大模型的技术框架、训练评估方法以及在不同法律场景中的实际应用案例,展示法律大语言模型在法律咨询、案件分析和智能审判等任务中的应用。
演讲提纲:
- 法律大语言模型的相关背景和技术进展
- 法律大语言模型的技术应用框架
- 法律大语言模型的训练和评估方法
- 法律大语言模型的落地场景与应用
听众收益:
- 了解华院计算的法律大语言模型应用框架和相关技术
by 娄一翎 博士
复旦大学
计算机科学技术学院 青年副研究员代码静态检查旨在通过对代码进行静态扫描和分析从而尽早发现软件中存在的缺陷。基于分析的传统静态缺陷检查方法通常在代码复杂性高、业务逻辑特定的场景中效果有限(召回率、精准率不足)。而大语言模型的发展正在改变各类软件质量保障技术(包括代码静态检查、测试、缺陷定位、修复等)。
本次演讲将关注基于大语言模型的缺陷静态检测方法,首先总结和梳理目前基于大语言模型的缺陷静态检测技术的类别;然后介绍我们如何利用缺陷历史构建缺陷知识库,并知识库为基础增强大语言模型检测特定类型缺陷的能力;并介绍我们如何利用大语言模型和静态分析的互补性,设计结合大语言模型和静态分析的缺陷静态检测方法;最后演讲将大语言模型时代中缺陷静态检测技术的未来方向和挑战。
演讲提纲:
- 基于分析的缺陷静态检测的问题和挑战
- 基于大模型的缺陷静态检测技术发展
- 利用知识库增强增强大模型的缺陷静态检测能力
- 结合大模型和静态分析方法进行缺陷静态检测
- 未来技术发展展望
听众收益:
- 了解基于大语言模型的静态缺陷检测方法
- 了解大语言模型与传统静态分析方法的互补点以及结合点
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手