本次专场将聚焦 LLM 在多模态领域的应用和创新,探讨如何将 LLM 与图像、音... 展开 >
多模态大语言模型的前沿应用与创新
会议室:钻石厅 C出品人:姚旭晨
- Topic 1
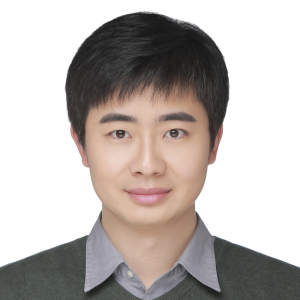
李岩
快手 可图大模型团队负责人 - Topic 2
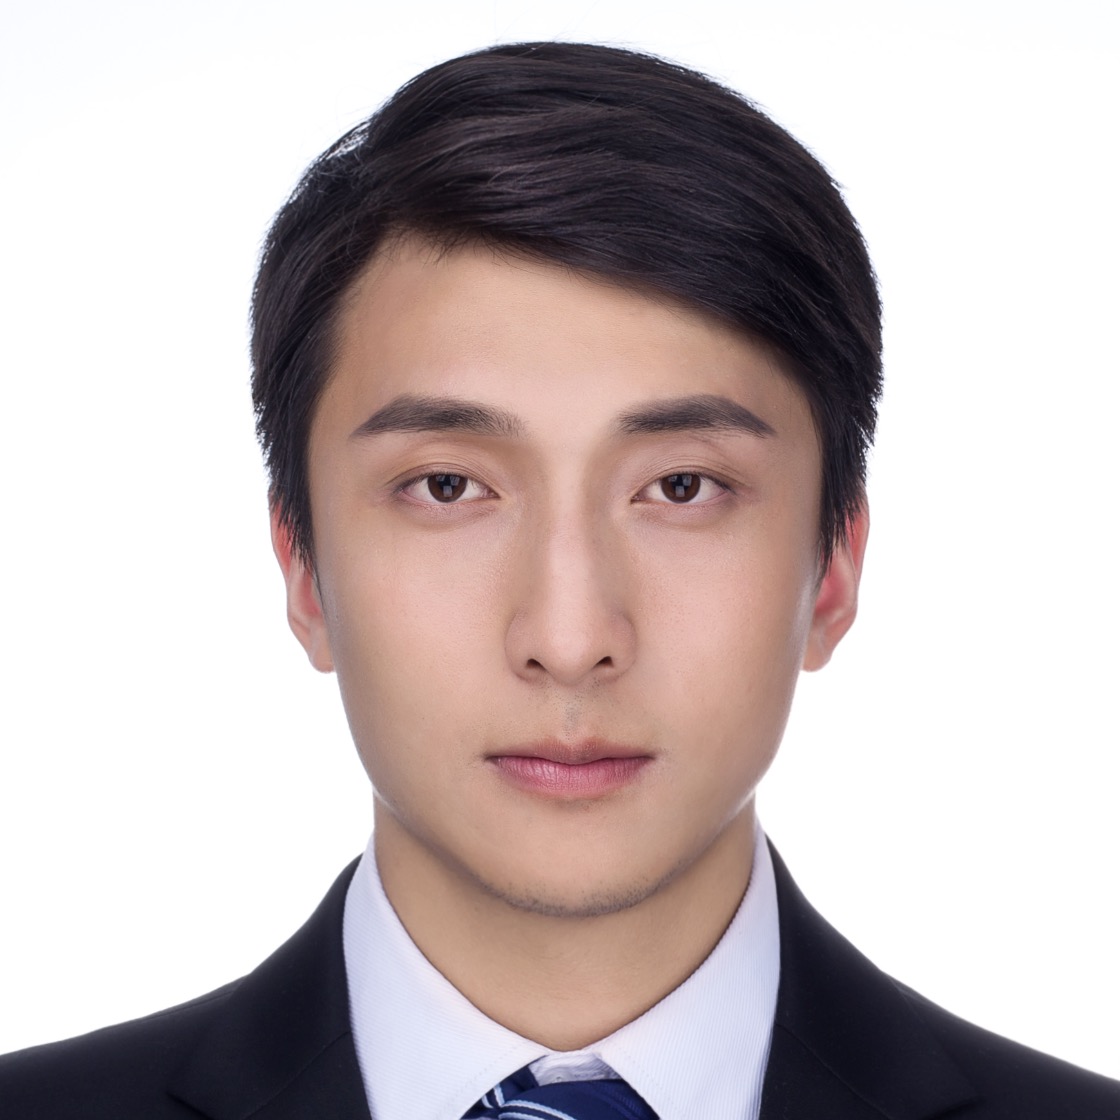
叶剑豪
喜马拉雅 珠峰 AI 算法负责人 - Topic 3
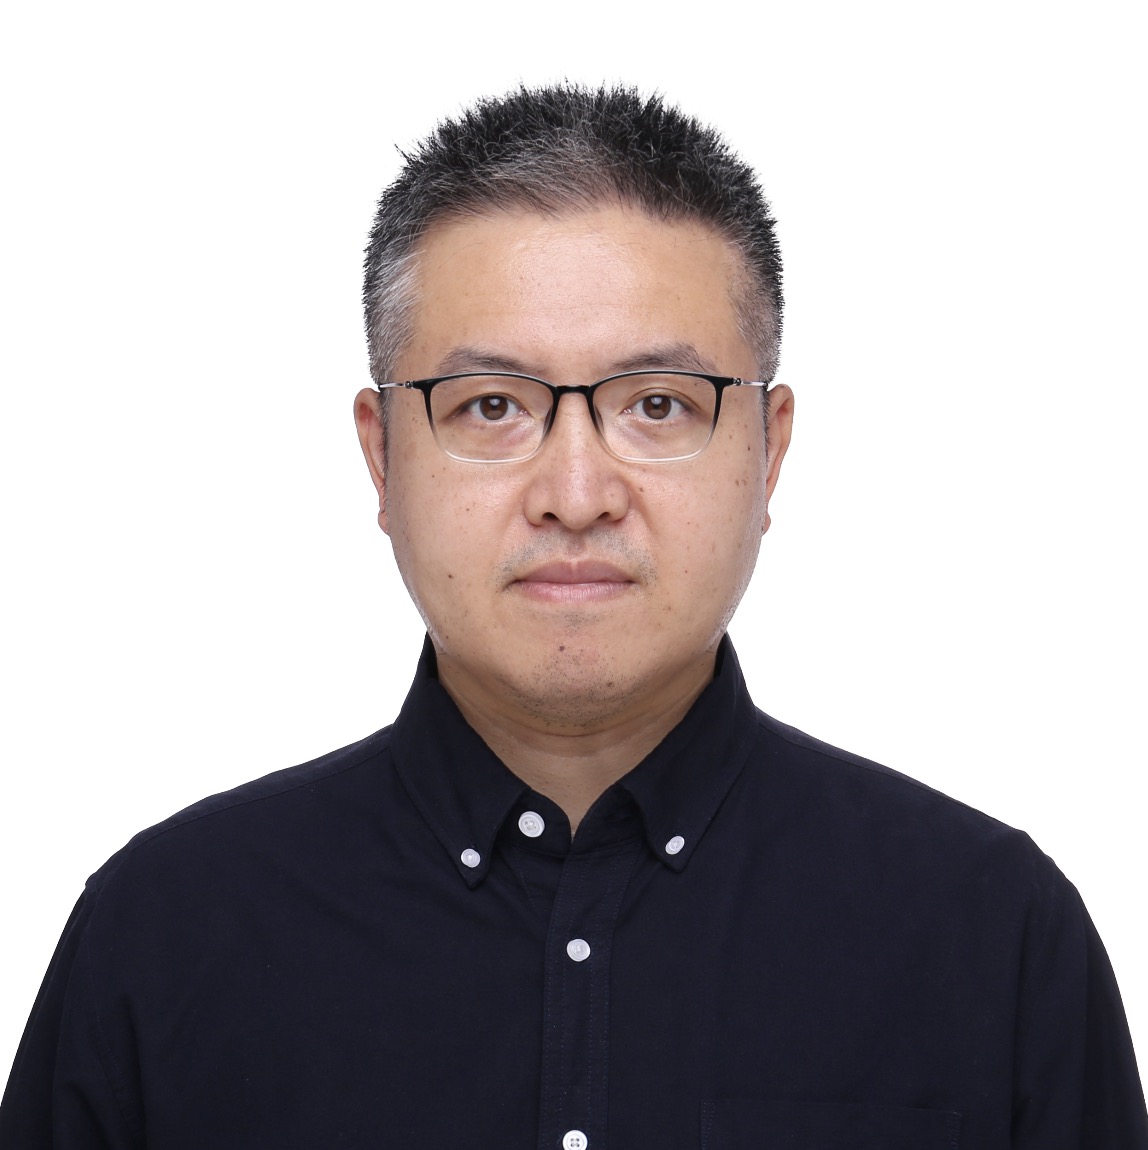
毛继明
极佳科技 合伙人 & 工程副总裁 - Topic 4
王文海
上海人工智能实验室 青年科学家
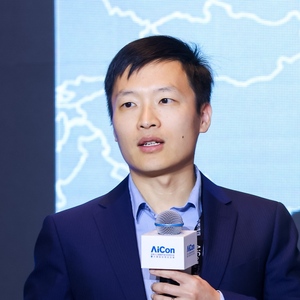
专题出品人:姚旭晨
Seasalt.ai CEO
自然语言处理和人工智能领域的专家和创业者。本科毕业于南京大学电子系,硕士在荷兰格罗宁根大学(自然语言处理和统计学)和德国萨尔兰德大学(计算语言学),并于美国约翰霍普金斯大学取得博士学位,主要致力于机器学习领域的自然语言处理和语音技术研究。论文在自然语言理解和机器学习的顶级会议上多次发表。曾创立了语音唤醒和自然语言交互公司 KITT.AI,致力于语音唤醒和自然语音交互技术的研究开发,公司曾被 CBInsights 评选为首届 AI 100公司,并获得微软联合创始人保罗·阿兰旗下的阿兰人工智能研究所、亚马逊 Alexa 基金等投资。
地点:钻石厅 C
专题:多模态大语言模型的前沿应用与创新
本次专场将聚焦 LLM 在多模态领域的应用和创新,探讨如何将 LLM 与图像、音频、视频等多媒体数据融合,实现更智能、更自然的交互体验。本次专场将分为以下几个模块:
- 多模态表示学习: 探讨如何从多模态数据中学习有效的表示,为LLM的理解和生成奠定基础。
- 多模态融合与推理: 研究如何将LLM与其他多模态模型进行融合,实现更强大的推理能力。
- 多模态生成与创作: 探讨如何利用LLM进行多模态内容生成,包括文本、图像、音频、视频等。
- 多模态对话与问答: 研究如何构建多模态对话系统,支持自然语言和多媒体信息的交互。
- 多模态应用案例: 展示LLM在多模态领域的落地应用,包括医疗、教育、娱乐等。
by 李岩
快手
可图大模型团队负责人本次演讲主要介绍可图大模型基座研发的关键技术创新,分享大模型时代的开源价值,剖析娱乐场景与商业化场景视觉生成模型落地差异,探索图像生成与视频生成的能力联动方式。
演讲提纲
- 视觉生成领域关键技术难点
- 可图大模型的技术创新实践
- 可图大模型开源背后的思考
- 可图大模型在快手的应用探索
- 图像生成与视频生成的技术联动
听众收益
- 可图大模型背后的技术思考
- 大模型时代开源还是闭源背后的逻辑
- 图像生成与视频生成的技术统一
by 叶剑豪
喜马拉雅
珠峰 AI 算法负责人在当前人工智能快速发展的背景下,文本大模型已经展现出巨大的应用潜力。然而,大模型不会局限于文本的生成,其他模态以及多模态大模型也正在开辟更广阔的想象空间。
本次演讲将以生成式音频大模型为切入点,深入探讨音频以及多模态大模型的构建过程、应用场景及未来展望。我们将首先回顾生成式音频大模型的发展历程,分析其与文本大模型的关系,并详细介绍其能力与构建方法。随后,我们将探讨生成式音频大模型在多模态领域的应用,特别是在音频内容AIGC“产模结合”、音视频内容生成、数字人技术方面的创新应用。最后,我们将展望多模态大模型的未来发展方向,探讨其潜在的突破性应用。
演讲提纲
1. 生成式音频大模型
- 生成式音频大模型的前世今生
- 文本大模型和音频大模型的关系
- 音频大模型能力介绍与构建
2. 生成式音频大模型的多模态应用
- 音频内容AIGC“产模结合”
- 多模态与数字人应用
3. 统一视角下的多模态大模型构建与展望
听众收益
- 了解生成式音频大模型的前世今生
- 理解生成式音频大模型以及多模态大模型的构建过程
- 了解到生成式音频大模型在内容生产上的最佳实践以及多模态应用场景结合点
by 毛继明
极佳科技
合伙人 & 工程副总裁随着大模型的不断发展,所有通用智能问题都在走向“端到端”,高质量的闭环数据成为了核心。过去的数据采集方式都存在各种各样的瓶颈,世界模型是未来通用智能最重要的闭环数据来源。本次演讲主要介绍极佳科技在世界模型和闭环模拟器方面的技术研发和进展。
演讲提纲
1. 从视频生成到世界模型,相关领域发展现状;
- 视频生成发展现状
- 世界模型发展现状
2. 世界模型为中心,打造新一代闭环数据引擎;
- 目前具身智能主要数据来源
- 基于世界模型,打造新一代闭环数据引擎
- 我们的实践
3. 通过世界模型,推动端到端自动驾驶和具身智能的发展;
- 自动驾驶发展现状
- 世界模型对于自动驾驶的意义
- 世界模型对于具身智能的意义
4. 总结和展望
- 世界模型是未来物理世界最重要的数据来源
- 视频生成和世界模型未来发展趋势
听众收益
1. 了解视频生成和世界模型的最新进展;
2. 了解世界模型的应用场景;
3. 了解世界模型未来发展趋势。
by 王文海
上海人工智能实验室
青年科学家随着大语言模型的兴起,多模态大模型也取得了显著进步,推动了复杂的视觉语言对话和交互,弥合了文本与视觉信息之间的鸿沟。然而,现有的开源模型与商用闭源模型(如GPT-4o和Gemini 1.5 Pro)之间的能力差距仍然显著。本报告将探讨图文多模态大模型的基本原理和技术,探索如何利用开源套件构建强大的多模态大模型,研究如何通过渐进式策略扩展开源多模态模型的性能边界,以缩小开源模型与商业闭源模型在多模态理解方面的能力差距。
演讲提纲
1. 大语言模型&多模态大模型的研究现状:大语言模型和多模态大模型的发展现状介绍以及代表性工作的介绍与分析。
2. 视觉基础模型在大模型时代的角色:讨论在大模型时代视觉基础模型的作用及未来可能的发展方向。
3. 基于开源套件的强多模态大模型实现:以 InternVL 2 为例,探讨如何通过纯开源模型逐步实现媲美 GPT-4o 的强通用图文问答、文档理解、多学科理解等能力。
听众收益
1. 了解多模态大模型的最新进展;
2. 了解多模态大模型的应用场景;
3. 了解多模态大模型的未来发展趋势。
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手