本专题将深入讨论大模型的出海应用,主要内容包括:实现大模型架构对多语言的扩展,对... 展开 >
大模型的全球化机会和挑战
会议室:万豪宴会厅 1出品人:杨浩 博士
- Topic 1
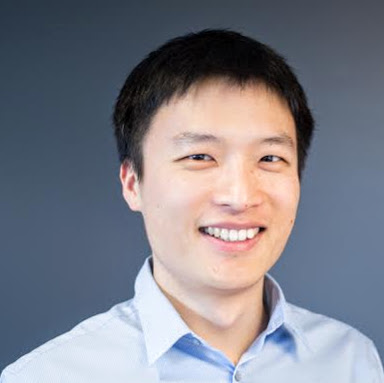
姚旭晨
Seasalt.ai CEO - Topic 2
张敏
华为 AI 科学家 - Topic 3
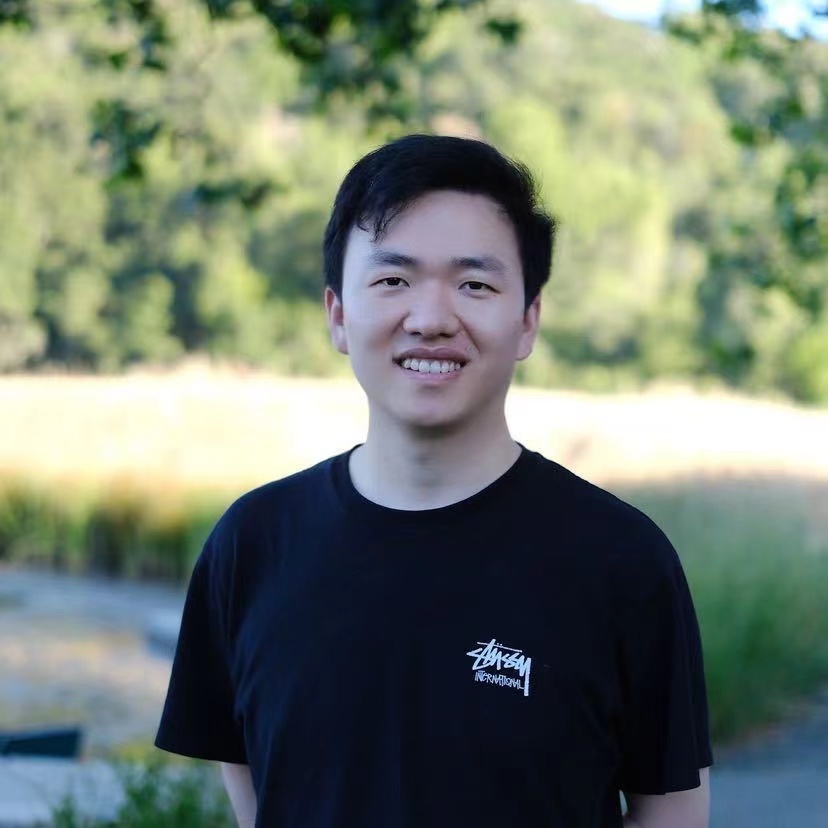
陈伟
Nexa AI CEO 和创始人 - Topic 4
王闻宇
PPIO 派欧云 CTO & 联合创始人
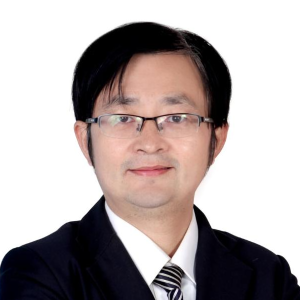
专题出品人:杨浩 博士
华为文本机器翻译实验室主任
北京邮电大学计算机博士,师承两院院士陈俊亮老师,在搜索推荐和机器翻译等人工智能相关领域有十年以上研发经验。有 30+ACL/EMNLP/ICLR/ICASSP 等顶会论文和国内外专利,带领团队获得 WMT/IWST 等多项冠军。现负责多语言盘古大模型,盘古同传等方向,希望和大家共同探讨大模型训练,Agent 和 RAG,推理加速,高质量数据和评估等前沿方向和落地应用。
地点:万豪宴会厅 1
专题:大模型的全球化机会和挑战
本专题将深入讨论大模型的出海应用,主要内容包括:实现大模型架构对多语言的扩展,对高资源语言知识的迁移方法,以及在强领域RAG(Retrieval-Augmented Generation)和Agent系统中实现高质量输出的策略。此外,我们还将探讨如何利用高质量的提示词(Prompt)和思考链CoT来指导模型的生成和评估过程。我们将从模型架构、微调、增强学习和用户交互等多个角度,全面分析大模型国际化过程中面临的挑战以及可能的优化策略。
by 姚旭晨
Seasalt.ai
CEO随着智能语音技术的发展,越来越多的场景需要实时语音交互,如客服中心、电话营销、智能家居等。然而,传统的电话体验在电话被发明后没有大变过,用户仍然需要面对漫长的等待、复杂的 IVR 菜单,无法理解的回应等问题。本次演讲将介绍如何利用大语言模型(LLM)来改善实时语音应用的体验和效率,提升客户满意度和业务收入。
首先,我们将介绍LLM 的基本概念和优势,以及如何在垂直领域上进行 Fine-tuning,提高语音识别和语音合成的准确率和自然度。其次,我们将展示语音 + 大语言模型的技术底座,分别用于实现实时语音聊天、电话信道转换和语音生成。然后,我们将分享几个实时语音应用的典型场景和解决方案,如半夜找水管工、太阳能电池板销售、现金买房等,以及我们在这些场景中遇到的技术挑战和应对策略。最后,我们将展望实时语音应用的未来发展趋势和商业机会,以及我们的愿景和目标。
演讲提纲:
- 技术基础: 讨论模型底座的优势,包括成本效益、高并发能力和结构化输出
- 场景应用: 举例说明大模型如何在 B2C 和 B2B 领域提供解决方案,如智能语音信箱、客服 Copilot 等
- 商业潜力: 强调每个场景都有可能孕育出年收入超过 1000 万美元的公司,并探讨广泛的合作伙伴和 Reseller 网络的重要性
听众收益:
- 扩充眼界: 了解Seasalt.ai在商场实战中遇到的各种案例与应对方案
- 效率提升: 了解如何通过大模型减少等待时间,提高响应速度
- 成本节约: 学习如何利用自动化和集成系统降低人力成本
- 商业机会: 掌握如何利用大模型开拓新的商业机会和提升客户体验
by 张敏
华为
AI 科学家随着 ChatGPT 的出现,大模型的研究如雨后春笋般涌现,但研究主要聚焦在高资源语种上(如英文、中文),对中低资源语种的研究相对较少且大模型在这些语种上的效果较差。如何在中低资源语上进行大模型业务落地,是一个非常有价值且值得探索的问题。本次分享将介绍我们在泰国金融领域客户进行大模型业务落地的实践。首先我们将介绍如何以较低成本实现盘古大模型对新语种(泰语)的支持,然后介绍在客户个性化营销活动和呼叫中心提效场景上的落地实践。
演讲提纲:
- 泰语大模型现状
- 盘古大模型支持泰语的实现
- 基于 Agent 的个性化营销活动
- 基于 RAG 的呼叫中心提效
听众收益:
- 了解如何低成本实现大模型向中低资源语种的能力迁移
- 了解Agent、RAG与大模型协同下,业务的落地实践
by 陈伟
Nexa AI
CEO 和创始人随着 AI 技术的不断进步, 端侧 AI 模型正在成为新的发展趋势。模型的体积不断缩小, 基础算力却在持续提升, 这使得在终端设备上运行 AI 模型成为可能。在这个时代, 人们越来越关注自己的隐私和成本支出, 端侧模型恰好能很好地解决这些问题。目前端侧模型的研发、部署和整个生态系统仍处在早期阶段。这次的分享会围绕端侧模型研发、SDK 和整个生态来展开讨论。
by 王闻宇
PPIO 派欧云
CTO & 联合创始人演讲提纲:
- 我们为什么要出海
- 中美科技博弈下,我们如何面对
- 出海的困难在哪?出海产品和增长的思考
- 我们出海技术优化实例
- 分布式AI推理云
- unsensor模型算法优化
- 推理加速算法优化
- 全球网络加速
- 实际效果和后续发展方向
听众收益:
- 了解出海过程中可能遇到的挑战,如文化差异、法律法规、市场竞争等
- 探讨出海企业在技术方面的优化实践
关注主办方(InfoQ)


联系我们
交通指南
北京乐多港万豪酒店
Beijing Marriott Hotel Changping
地址:北京市昌平区南口路29号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手