公有云 LLM 模型分布式训练最佳实践

所属专题:大模型训练

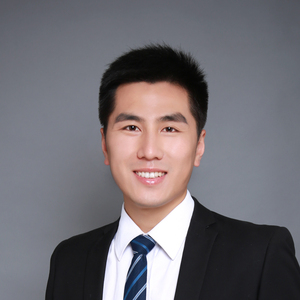
嘉宾 : 曹治政 | Google CloudInframod specialist

会议室 : 会议室 4+5

讲师介绍

专题演讲嘉宾:曹治政

Google CloudInframod specialist

十年以上云计算工作经验,在云计算基础设施、云原生以及 AI 等领域有广泛而又深入的积累,曾就职于多家知名云计算公司(AWS/ 华为)以及硅谷创业公司(Mesosphere)。 实践经验丰富,独立承担多次大规模的项目建设与迁移,在公有云、云原生以及 AI 等几个领域有深入且持续的积累。

工作和研究方向包括:

  1. 私有云数据中心的建设:云计算管理平台(Openstack),分布式存储(Ceph)以及 SDN 网络架构设计(Openflow+ 网络设备)
  2. 容器与容器管理平台:Docker/Mesos/Kubernetes
  3. 云原生平台与应用:Devops/Serverless/ 微服务,对 CNCF 中的开源项目以及公有云上的服务有深入研究以及实践
  4. AI 工程化:分布式训练 / 推理优化 /MLops,曾帮助多个客户成功构建云上 MLops Pipeline,加速模型的训练与部署流程
议题介绍

地点:会议室 4+5
所属专题:大模型训练

演讲:公有云 LLM 模型分布式训练最佳实践

分享内容主题为 GenAI LLM 在工程化的过程中所面临的挑战,以及对应的解决方案。LLM 模型参数量近些年呈指数型发展,远远超过单个硬件加速设备(GPU/TPU)的发展速度。从工程的角度上看,这种发展速度无论对模型的训练和推理都造成了严重的挑战。以大模型的训练为例,分布式训练基本上成为了标配,然而这种复杂的技术架构给实践者带来了很大的挑战。例如:

  1. 如何选择开源框架与技术工具
  2. 如何构建大规模的分布式训练集群、如何优化存储与网络的设计
  3. 如何做到基础设施的自动化与扩展能力,并在不同的场景下最优化成本
  4. 如何集成开发与运维工具,端到端自动化模型训练的工作流程(MLops),持续地优化和改进模型,同时提高模型的发布效率。

本次分享,带着以上几个问题,与参会者详细分享如何在公有云上,通过利用云服务的特性,同时结合开源工具解决大模型在工程化上所面临的挑战。

演讲提纲:

  1. LLM 发展历史回顾与模型架构概览
  2. LLM 模型预训练与 Fine Tune 的流程以及对硬件要求
  3. 模型的分布式训练原理与云上实践
  4. 利用开源工具与公有云服务构建 MLops 工作流,端到端加速 GenAI 模型工程化

听众收益:

  • 系统了解大模型的内部结构与训练方式
  • 了解大模型分布式训练的原理与主流框架(tensor parallelism/pipelineparallesim/data parallesim、Lora、量化、deepspeed/FSDP 等)
  • 了解大模型在不同云上基础设施的训练方案以及基础设施自动化方案(GPU/TPU,Vertex AI/SageMaker/Ray)

交通指南

北京乐多港万豪酒店

Beijing Marriott Hotel Changping
地址:北京市昌平区南口路29号
  • 微信咨询

  • 电话咨询

    联系电话:13269078023

微信联系我们

如您在购票过程中遇到问题,请扫码咨询票务小助手