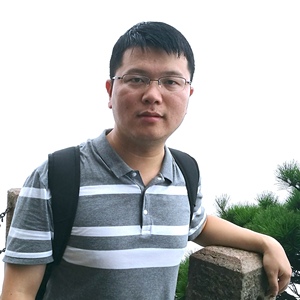
目前是阿里云计算平台事业部机器学习 PAI 高级技术专家,长期从事云计算、深度学习相关方向,擅长深度学习平台,超大规模模型训练、通信优化等领域。深度参与阿里云 MaxCompute、PAI 平台的建设,负责 PAI 平台深度学习训练框架,主导统一多种并行策略的分布式训练框架 Whale 的研发和建设。
讲师介绍
议题介绍
地点:宴会厅B
所属专题:大规模预训练模型进展
演讲:大规模预训练模型高效训练的架构实践
最近,阿里巴巴并联合清华大学等共同开发了全球最大规模的中文多模态预训练模型 M6(MultiModality-to-MultiModality Multitask Mega-transformer)。模型参数超1万亿规模,借助 PAI 自研的分布式训练框架 Whale,首次2天内在496 GPU卡上完成M6模型1亿图文样本的预训练。
相比于非纯文本或者纯图像预训练模型,多模态预训练模型数据挑战更大、模型训练难度更高、下游覆盖的应用场景更广泛。从学术研究的角度来讲,跨模态的理解和生成和人类认知也有着千丝万缕的联系(语义对齐、语言/视觉控制),对其更加深入的研究或许能使我们往AGI的路上向前再迈一小步。而从业界的视角来讲,多模态预训练模型不仅可以应对文本和图像各自领域的任务,还可以用于大量需要跨模态理解&生成的应用场景,而这些场景在阿里复杂的生态体系中,往往蕴藏着不可忽视的商业价值。我们可以借助m6模型的通用知识基础,让下游业务能使用较少的样本数,来达到比较好的业务效果。
工程训练框架方面,万亿多模态预训练模型的提出对于当前的深度学习框架提出来很多挑战。这些挑战包括模型计算效率的挑战、模型分布式训练性能的挑战、数据IO的挑战、模型训练收敛性的挑战等。针对这些挑战,PAI团队自研Whale分布式训练框架,在多个方面进行了深度优化。从而可以帮助千亿、万亿多模态预训练模型能够快速迭代训练。Whale分布式训练框架基于Graph IR,针对数据并行、模型并行、流水并行、混合并行等多种并行模型进行了统一架构设计,并对用户提供并行策略原语,用户在仅仅添加几行API调用的情况下就可以实现丰富的分布式并行策略。同时Whale中实现了包括自动Gradient Checkpointing、Optimizer峰值显存优化、通信分组和线程池技术、混合精度、编译优化等优化技术。算法同学不需要修改模型代码,只需添加简单几行的API调用就可以快速构建高效的分布式训练任务。
演讲提纲:
- Whale 分布式训练框架介绍
- 借助 Whale 高效训练超大规模模型的方法
- 超大规模模型预训练的挑战
- 解决思路:
- 对于超大规模模型 M6,采用 Whale 的数据并行+模型并行的分布式策略进行训练
- 结合MoE 结构来优化超大模型对算力的需求,并通过计算、显存、通信优化来提高分布式训练效率
- 经验总结
你将获得:
- 了解深度学习各种并行训练模式;
- 了解超大规模模型预训练的挑战和解决方案;
- 了解 M6 模型和高效分布式训练方法。
关注主办方(InfoQ)
联系我们
交通指南
北京·悠唐皇冠假日酒店
地址:北京市朝阳区三丰北里3号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质
电话咨询
联系电话:+86 13269078023
在报名过程中如有任何问题,欢迎微信扫描二维码联系我们的票务经理